Alors que les titans de la technologie présents à l'événement Dreamforce de Salesforce Inc. à San Francisco cette semaine se livraient à un débat animé sur la question de savoir si le rythme de déploiement de l'intelligence artificielle devait être ralenti, un groupe d'experts en technologie de haut niveau se réunissait au même moment à environ une heure de route vers le sud pour décrire comment ils construisaient l'infrastructure de l'IA aussi rapidement que possible.
Lors du AI Infra Summit à Santa Clara, des technologues d'entreprises telles qu'Amazon Web Services, Oracle, Broadcom, Qualcomm et d-Matrix, ont expliqué comment ils travaillaient dur pour optimiser l'infrastructure pour répondre aux exigences toujours croissantes de l'IA. Les défis liés à la technologie deviennent chaque jour plus évidents. L’IA est gourmande en énergie et en mémoire, et le coût des jetons devient actuellement incontrôlable pour de nombreuses entreprises.
« Les jetons par watt sont devenus la nouvelle mesure clé dans cette guerre de l'IA », a déclaré Tony Pialis, vice-président exécutif et directeur général du centre de données et de l'IA chez Qualcomm, lors d'une présentation lors de la conférence mercredi. « Nous ne pouvons clairement pas rester sur cette tendance. Du côté des infrastructures, nous devons faire mieux. »
Construire pour la demande d’inférence
La demande exponentielle en IA a généré une diversité de calculs en un laps de temps remarquablement court. Bien que la formation des modèles d’IA ait nécessité des quantités importantes de puissance d’unité de traitement graphique pendant une grande partie de 2025, l’accent mis cette année sur l’inférence a entraîné une utilisation fulgurante des jetons et la nécessité d’une infrastructure plus hétérogène intégrant des unités centrales de traitement.
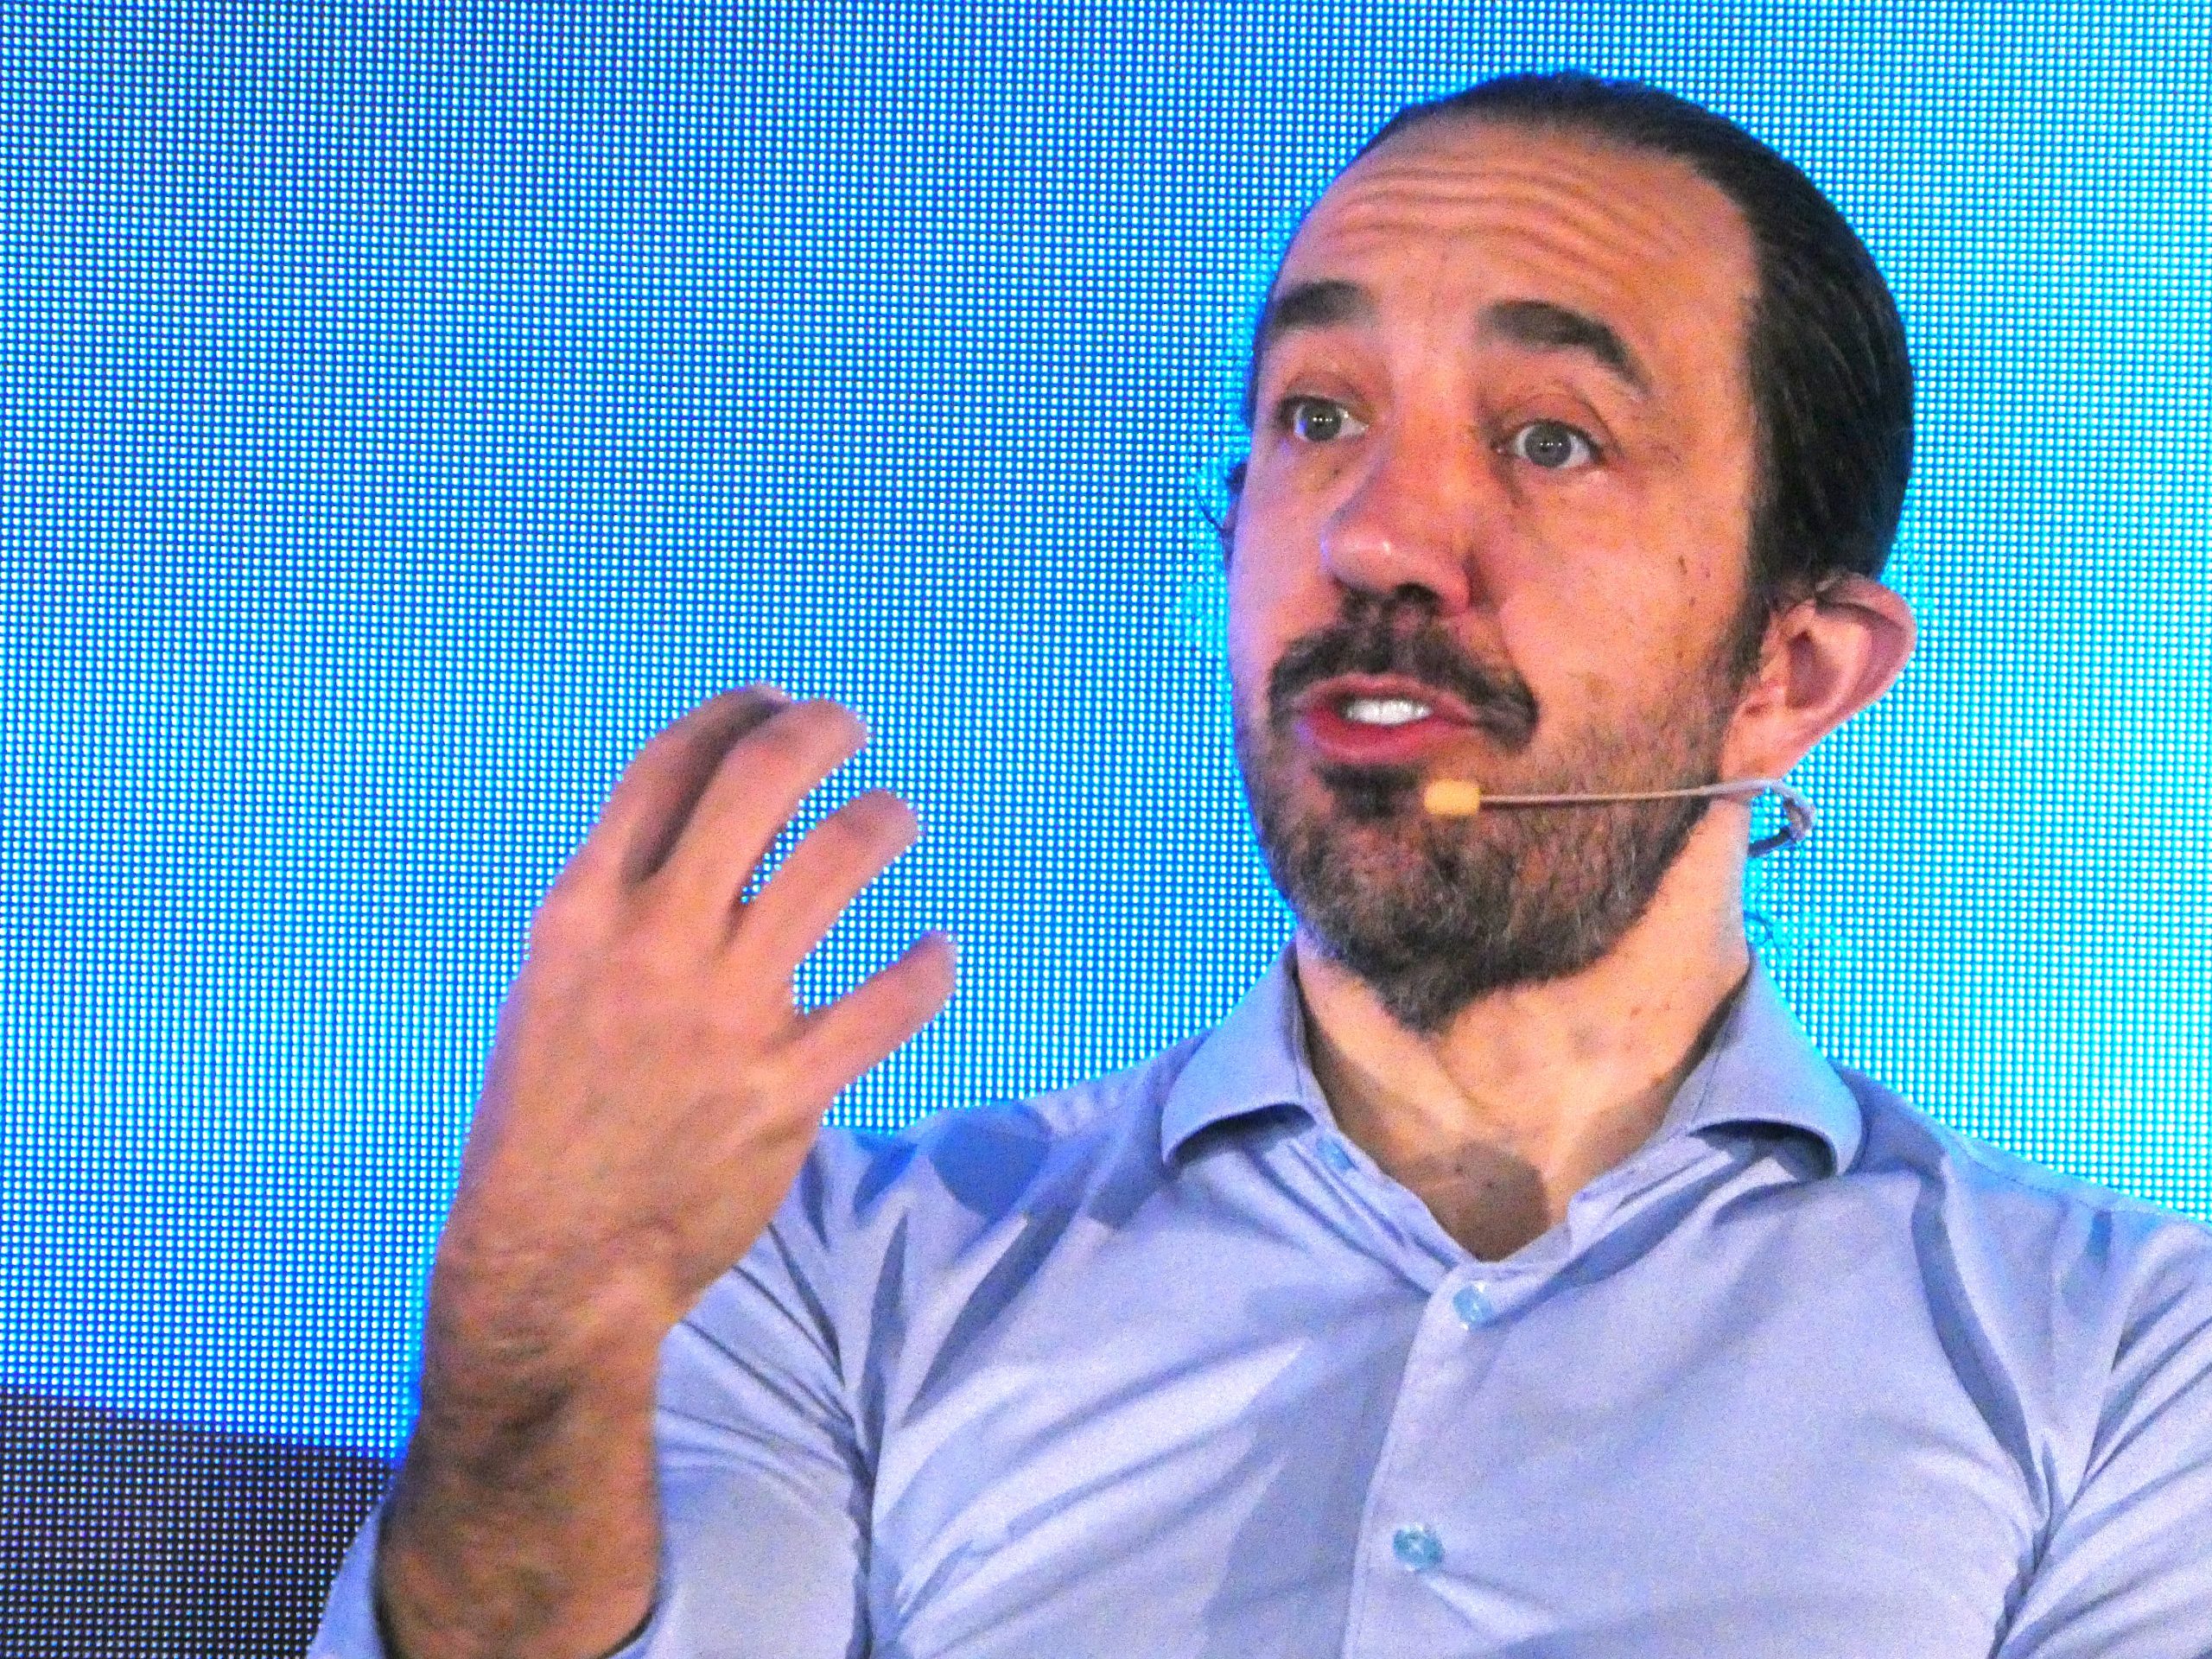
Pour l’hyperscaler Amazon Web Services Inc., qui a construit son propre portefeuille de processeurs au fil des années, cela représente une excellente opportunité de façonner la future infrastructure pour l’IA. « La majorité des calculs serviront à l'inférence », a déclaré Peter DeSantis (photo), vice-président senior d'Amazon. « L'inférence va représenter une charge de travail énorme. »
Au cœur de la stratégie d'AWS se trouve Graviton, la famille de processeurs Arm 64 bits de la société, développée pour offrir une efficacité énergétique dans l'alimentation des applications pour le cloud. En juin, AWS a lancé le processeur Gaviton5 pour prendre en charge le raisonnement de l'IA en temps réel et l'orchestration des tâches en plusieurs étapes.
« Aujourd'hui, la grande majorité des charges de travail sur AWS s'exécutent de manière rentable et plus rapide sur Graviton », a déclaré DeSantis, qui a noté que l'IA était sur le point de débloquer davantage de spécialisation dans les logiciels. « Je pense que toute une vague de charges de travail à usage général va en découler. »
Briser le mur de la mémoire
En plus de l’équilibre entre GPU et CPU, il y a le rôle de plus en plus critique de la mémoire pour le traitement de l’IA. Comme l'ont documenté les analystes de SiliconANGLE, un serveur d'IA typique utilise environ huit fois plus de mémoire qu'un serveur traditionnel, et les dépenses en mémoire des serveurs d'IA devraient passer de 35 milliards de dollars en 2025 à entre 175 et 190 milliards de dollars d'ici 2027, soit environ cinq fois plus.
Cette croissance accélérée a conduit à une divergence d’opinions autour des solutions optimales pour répondre aux besoins substantiels de mémoire de l’IA. Au cours de la dernière année, Qualcomm a réorienté son attention de la mémoire traditionnelle à large bande passante ou HBM vers une nouvelle architecture propriétaire appelée calcul à large bande passante ou HBC.
Qualcomm Inc. estime que son HBC fournit six fois la bande passante par watt par rapport au HBM pour les lots de grande taille, et 200 fois la capacité par watt par rapport aux solutions de mémoire statique à accès aléatoire ou SRAM. La société considère que HBC a un moyen de surmonter le mur de mémoire, où le calcul a dépassé à la fois la mémoire et la bande passante, selon Pialis de Qualcomm.
« Le goulot d'étranglement réside dans le mouvement des données, pas dans l'arithmétique », a-t-il déclaré. « La façon de résoudre ce problème est de rapprocher encore plus le calcul de la mémoire. Nous avons effectivement déplacé les données dans le même condo où se trouve le calcul. Tout le monde a désormais le même ascenseur, de haut en bas. HBC offre l'avantage dont l'industrie a besoin. »
Solution DRAM Raptor avec Nvidia
Il existe un autre secteur dans la communauté technologique d'entreprise qui recherche une solution différente pour le mur de mémoire, une solution qui s'appuie plutôt sur la mémoire dynamique à accès aléatoire ou DRAM. La startup informatique d-Matrix Corp. a intégré une DRAM 3D à haut débit dans son architecture de puce de nouvelle génération appelée Raptor. La solution empile plusieurs couches de cellules de mémoire verticalement, permettant une densité de stockage plus élevée et des performances améliorées.
«Nous sommes bien meilleurs que SRAM», a expliqué le fondateur et PDG de d-Matrix, Sid Sheth, dans sa présentation AI Infra. « Nous faisons en fait bien mieux que HBM. Nous nous préparons depuis longtemps à un monde d'inférence infinie. »
La semaine dernière, la société de Sheth a dévoilé une collaboration avec Nvidia Corp. pour intégrer Raptor dans l'architecture de référence en rack du géant des puces IA, NVLink Fusion. La solution est conçue pour les laboratoires d'IA, les hyperscalers et les néoclouds afin de déployer des services de jetons haut de gamme à très faible latence.
« Nous avons décidé de simplement utiliser cette infrastructure », a déclaré Sheth. « Nous passons d'un rack Vera Rubin à un rack Vera Raptor avec cette approche. »
Mise en réseau pour l'évolutivité
Dans la quête visant à transformer des millions de GPU, CPU, systèmes de stockage, mémoire et logiciels en une machine productive, la mise en réseau est devenue un élément central de l’histoire de l’infrastructure de l’IA.
La mise en réseau devient essentielle dans l’équation du succès de l’IA d’entreprise pour de meilleures performances, évolutivité et coûts. Un exemple de cet accent mis sur la mise en réseau est Acceleron d'Oracle Corp., une architecture de virtualisation de réseau hautes performances et une technologie SmartNIC convergée conçue pour Oracle Cloud.
Les alliances d'Oracle avec Nvidia et Advanced Micro Devices Inc. ont abouti à une technologie de réseau appelée Acceleron RoCE qui a amélioré les performances et contourné le routage des données via les unités centrales de traitement des serveurs qui hébergent les GPU.
« Nous devons vraiment optimiser chaque partie de la pile », a déclaré Karan Batta, vice-président senior d'Oracle Cloud Infrastructure. « La mise en réseau devient tout aussi importante que le calcul lui-même. »
Broadcom Inc. a également joué un rôle majeur dans l'élaboration de technologies de mise en réseau destinées à prendre en charge le déploiement de l'IA. Dans une tournure historique, l'entreprise a construit son architecture réseau pour l'IA autour d'Ethernet, une technologie développée dans les années 1970.
Ethernet est connu pour ses vitesses élevées et sa faible latence. Broadcom a développé son portefeuille de réseaux pour l'IA en tirant parti de la structure Ethernet dans les clusters d'IA.
La puce réseau Tomahawk 6 de Broadcom, lancée l'année dernière, a été optimisée pour alimenter les commutateurs Ethernet des centres de données. Tomahawk 6 optimise les vitesses du réseau à l'aide d'un ensemble de fonctionnalités d'IA connues sous le nom de Cognitive Routing 2.0, qui évite les goulots d'étranglement en matière de performances en détectant la congestion du réseau et en redirigeant les données vers d'autres connexions.
« Il existe un consensus unanime dans l'industrie selon lequel les plus grands clusters de la planète utilisent Ethernet pour évoluer », a déclaré Hasan Siraj, vice-président des produits chez Broadcom. « Le réseau est l'ordinateur. »
Comme l’ont démontré les présentations au AI Infra Summit dans la Silicon Valley cette semaine, beaucoup de travail est en cours pour construire l’infrastructure nécessaire à l’IA. Une raison simple à cela apparaît : l’IA est désormais déployée dans les entreprises et les clients doivent l’améliorer.
Au cours d’une table ronde, plusieurs intervenants ont mentionné d’un coup les grosses factures résultant de dépenses symboliques, puis ont ignoré le coût le suivant.
« Nous avons en fait laissé tourner le compteur », a déclaré Arun Nandi, responsable des données et de l'IA chez Carrier Global Corp., qui a vu ses dépenses en jetons multipliées par huit cette année. « C'est la facture de la découverte. Pour nous, il s'agit moins du coût par jeton que de la valeur par tâche. »
