Les graphes de connaissances se déplacent au centre du développement de logiciels autonomes à mesure que les entreprises poussent les agents de codage au-delà des solutions rapides et dans de grandes bases de code interconnectées. Plus un agent touche de code, plus il doit en savoir sur tout ce à quoi ce code se connecte.
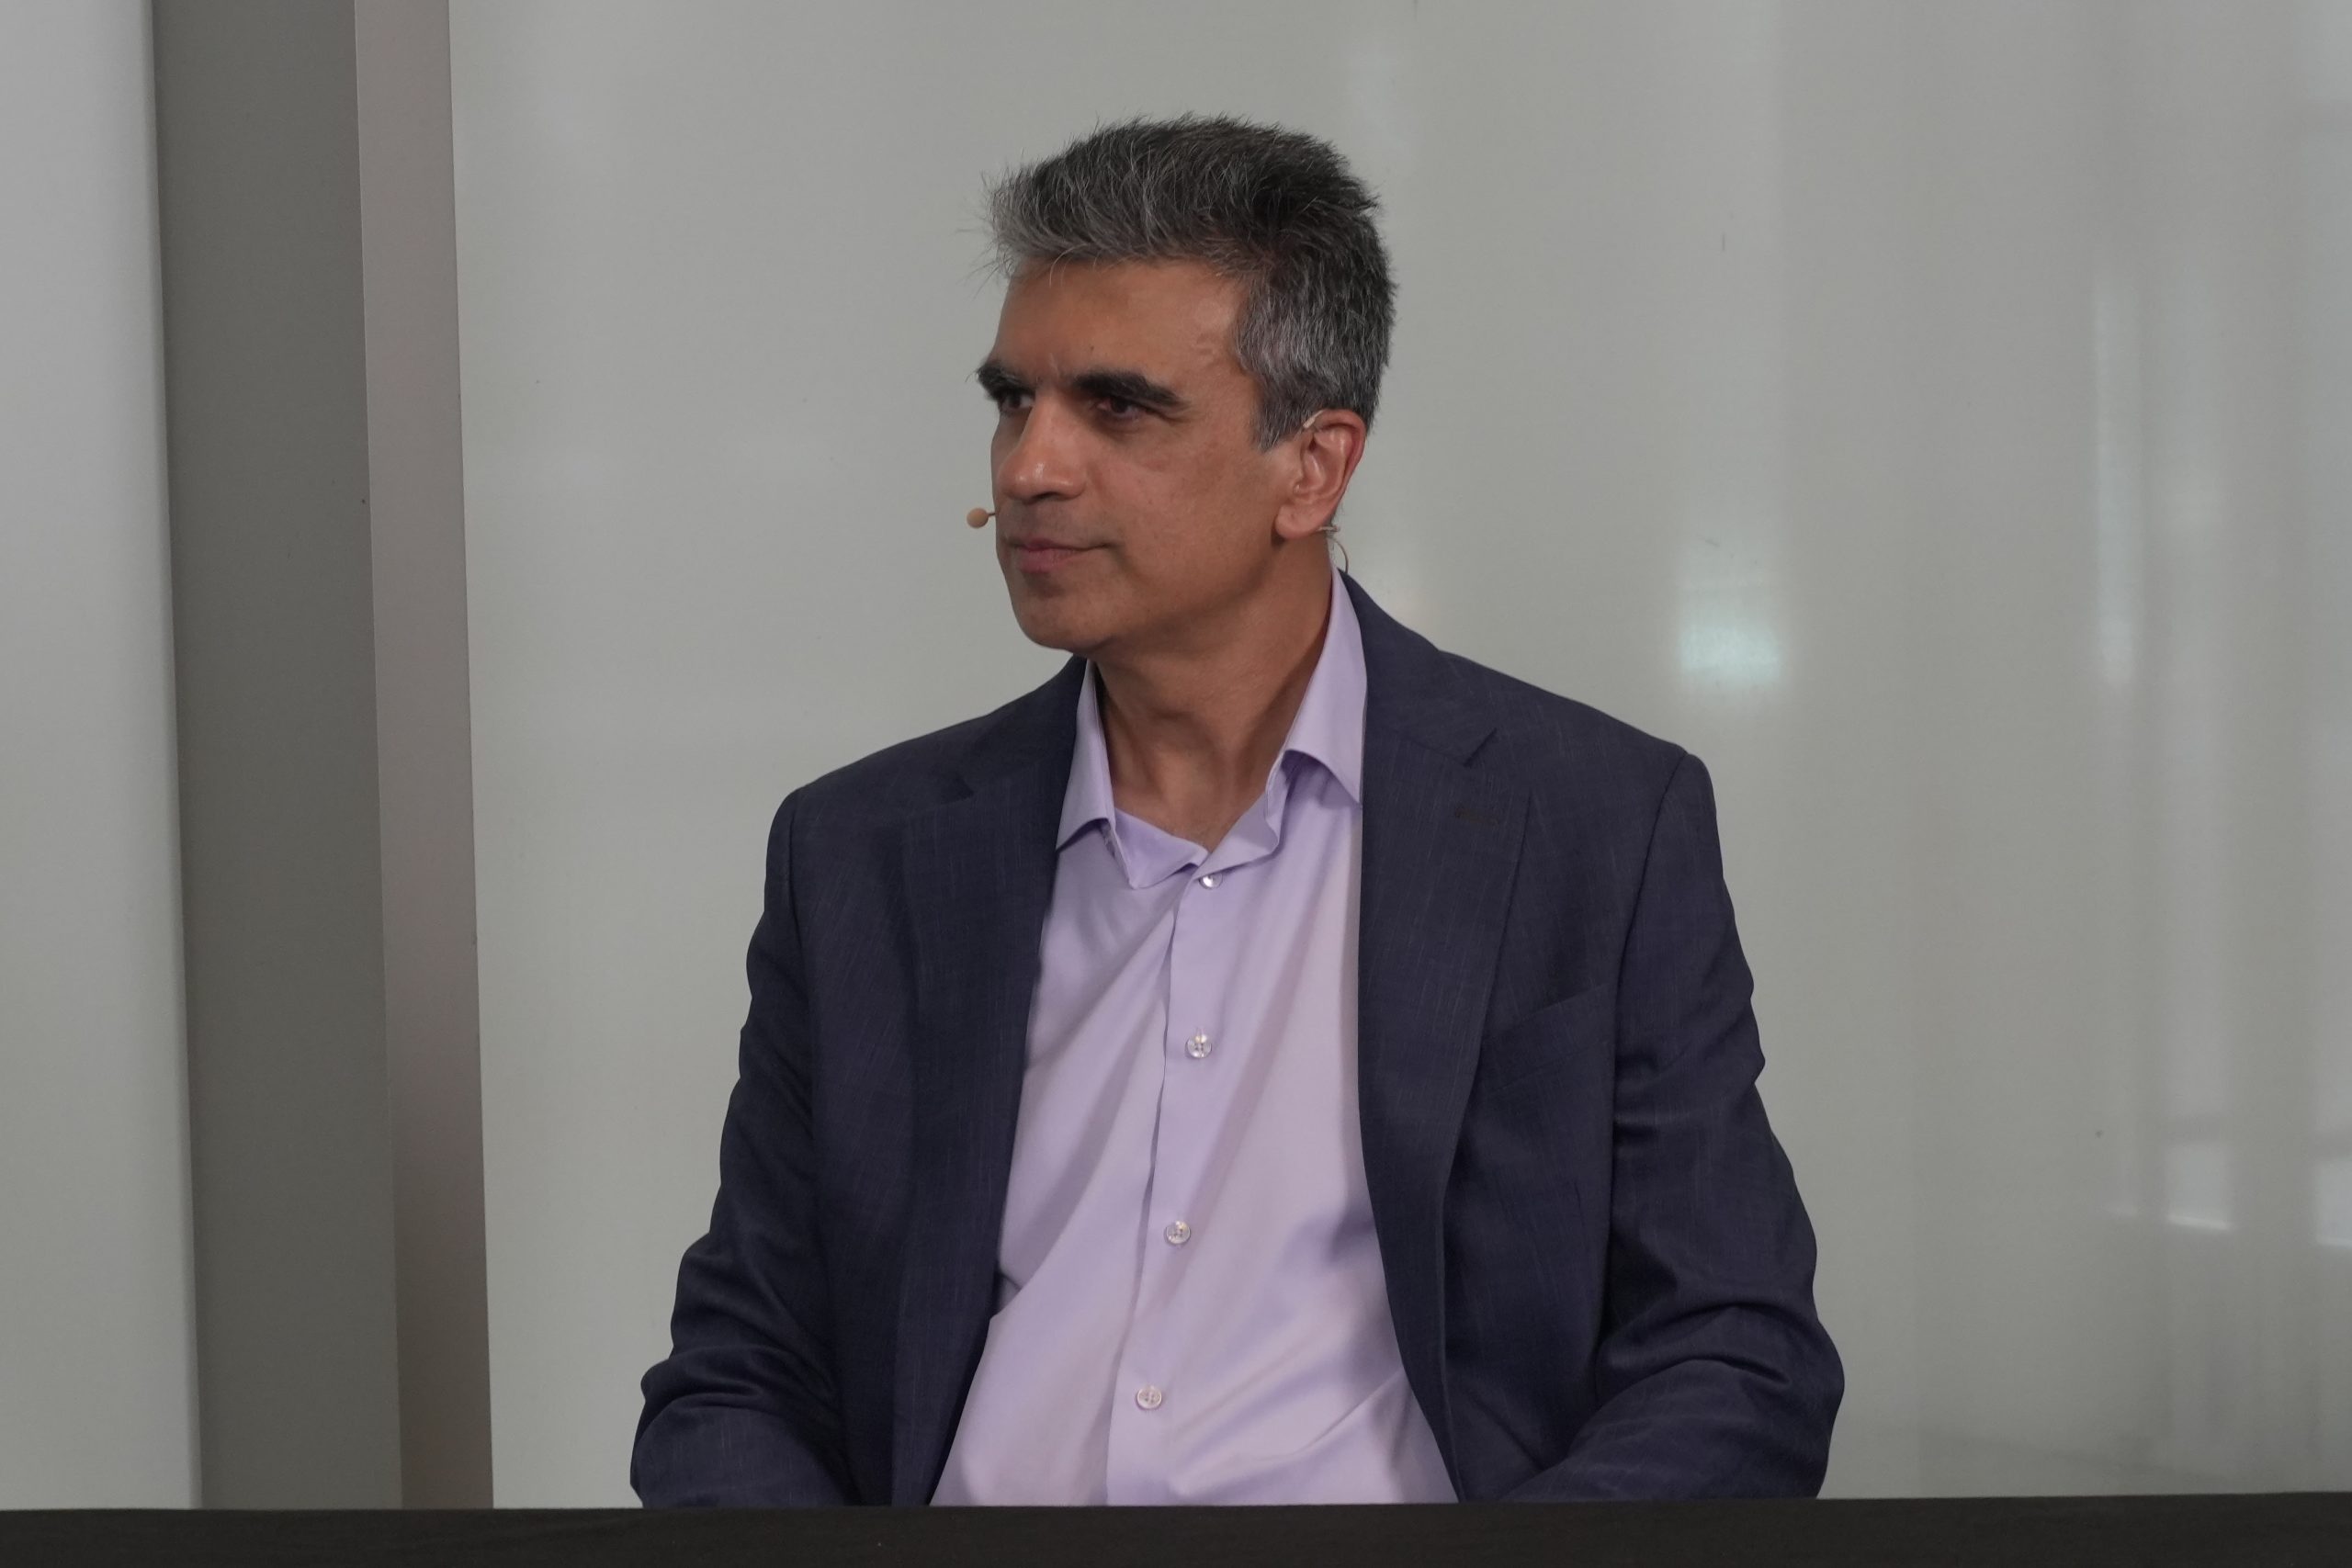
Les investisseurs parient massivement sur les plateformes conçues pour résoudre ce problème. Blitzy Inc. a levé 200 millions de dollars pour une valorisation de 1,4 milliard de dollars en mai pour exécuter des milliers d'agents de codage en parallèle. Le véritable obstacle au codage autonome n'est pas de générer du code mais de comprendre le système qui l'entoure, selon Neeraj Deshmukh (photo), directeur de l'ingénierie chez Blitzy.
« Je pense que lorsque les gens parlent de changer de logiciel de manière autonome, le plus gros problème n'est pas de savoir si l'IA peut écrire du code. Il s'agit plutôt de savoir si l'IA connaît ou comprend le système pour lequel elle écrit le code ? » » dit Deshmukh. « La compréhension est cruciale parce que je modifie peut-être une ligne de code ici, mais cela peut avoir un impact en aval quelque part au loin. »
Deshmukh s'est entretenu avec John Furrier de CUBE Research à GraphSummit, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont expliqué comment Blitzy utilise une base de données graphique de Neo4j Inc. pour donner à ses agents de codage le contexte nécessaire pour modifier les bases de code d'entreprise en toute sécurité et à grande échelle. (* Divulgation ci-dessous.)
Pourquoi les graphes de connaissances épousent la forme du code
La plate-forme de Blitzy commence par une rétro-ingénierie de l'environnement existant d'un client et par la création d'un graphique dynamique de sa base de code. Ce graphique se connecte aux systèmes de contrôle de code source tels que GitHub et GitLab, de sorte qu'il se met à jour chaque fois que les développeurs ou les agents modifient le code. L'utilisation de graphiques de connaissances pour ce travail reflète un fait fondamental sur la façon dont les logiciels sont construits, a expliqué Deshmukh.
« Fondamentalement, le code est un graphique parce que vous pensez: 'Oh, nous avons des modules, nous avons des fichiers, nous avons des fonctions, nous avons des objets, nous avons des classes, des variables' », a déclaré Deshmukh. « Chacune de ces entités est liée les unes aux autres. Donc, avant même d'introduire l'IA dans l'image, une base de code est intrinsèquement un graphique. «
Sans cette structure, les agents s'appuient sur des recherches vectorielles ou des commandes grep pour tracer les dépendances, et ces recherches brûlent rapidement la mémoire de travail. Le contexte effectif d'un agent se situe entre 200 000 et 300 000 jetons, soit entre 20 000 et 30 000 lignes de code, a noté Deshmukh. Sur une base de code de 100 millions de lignes, les agents commencent à compacter les résultats et à perdre des informations.
« Avec un graphique, vous savez exactement ce que vous allez atteindre parce que vous pouvez essentiellement choisir le point où vous voulez commencer. Et vous savez exactement ce qui est accessible. Et vous avez donc ce contexte efficace. Chaque agent connaît le contexte dont il a besoin et rien d'autre », a déclaré Deshmukh.
Cette efficacité change la façon dont les projets sont définis. Avec moins de perte de contexte dans les recherches larges, Blitzy peut s'attaquer à des projets entiers à la fois plutôt que de les diviser en épopées, user stories et tâches du modèle de sprint traditionnel. Le contrôle qualité est intégré au processus : les humains approuvent un plan d'action de l'agent avant le début du codage, et chaque ligne de code généré est testée immédiatement. La société a cité un score de 84,95 % sur SWE-Bench Pro en juin.
« En plus de cela, nous avons des agents qui surveillent les autres agents pour s'assurer qu'ils respectent les spécifications, le plan que nous avons créé et approuvé par l'humain dans la boucle », a déclaré Deshmukh. « Cela garantit qu'il n'y a pas de dérive ou d'hallucination. »
Le langage de requête est également important. Neo4j a utilisé GraphSummit pour présenter des graphiques de connaissances comme contexte partagé pour les agents d'IA, et les agents de Blitzy exécutent en permanence des requêtes dans le langage Cypher de Neo4j. La rigueur de Cypher sert également de garantie, car une requête mal formulée provenant d'un agent hallucinant ne renvoie tout simplement rien, selon Deshmukh.
« Vous n'obtenez un résultat que pour une requête correcte », a déclaré Deshmukh. « Il n'est donc pas question que les agents travaillent à partir d'informations inventées ou fausses. Vous êtes toujours fondé sur la vérité de ce qui se trouve dans le graphe de connaissances. »
Voici l'interview vidéo complète, qui fait partie de la couverture de GraphSummit par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour GraphSummit. Ni Neo4j, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
