L’architecture de stockage est en cours de réécriture pour les usines d’intelligence artificielle. Le stockage d'entreprise traditionnel a été conçu autour de charges de travail évolutives de manière relativement prévisible. L’IA change cette équation en combinant un mouvement important de données avec une activité de métadonnées transactionnelles, souvent sur une infrastructure partagée.
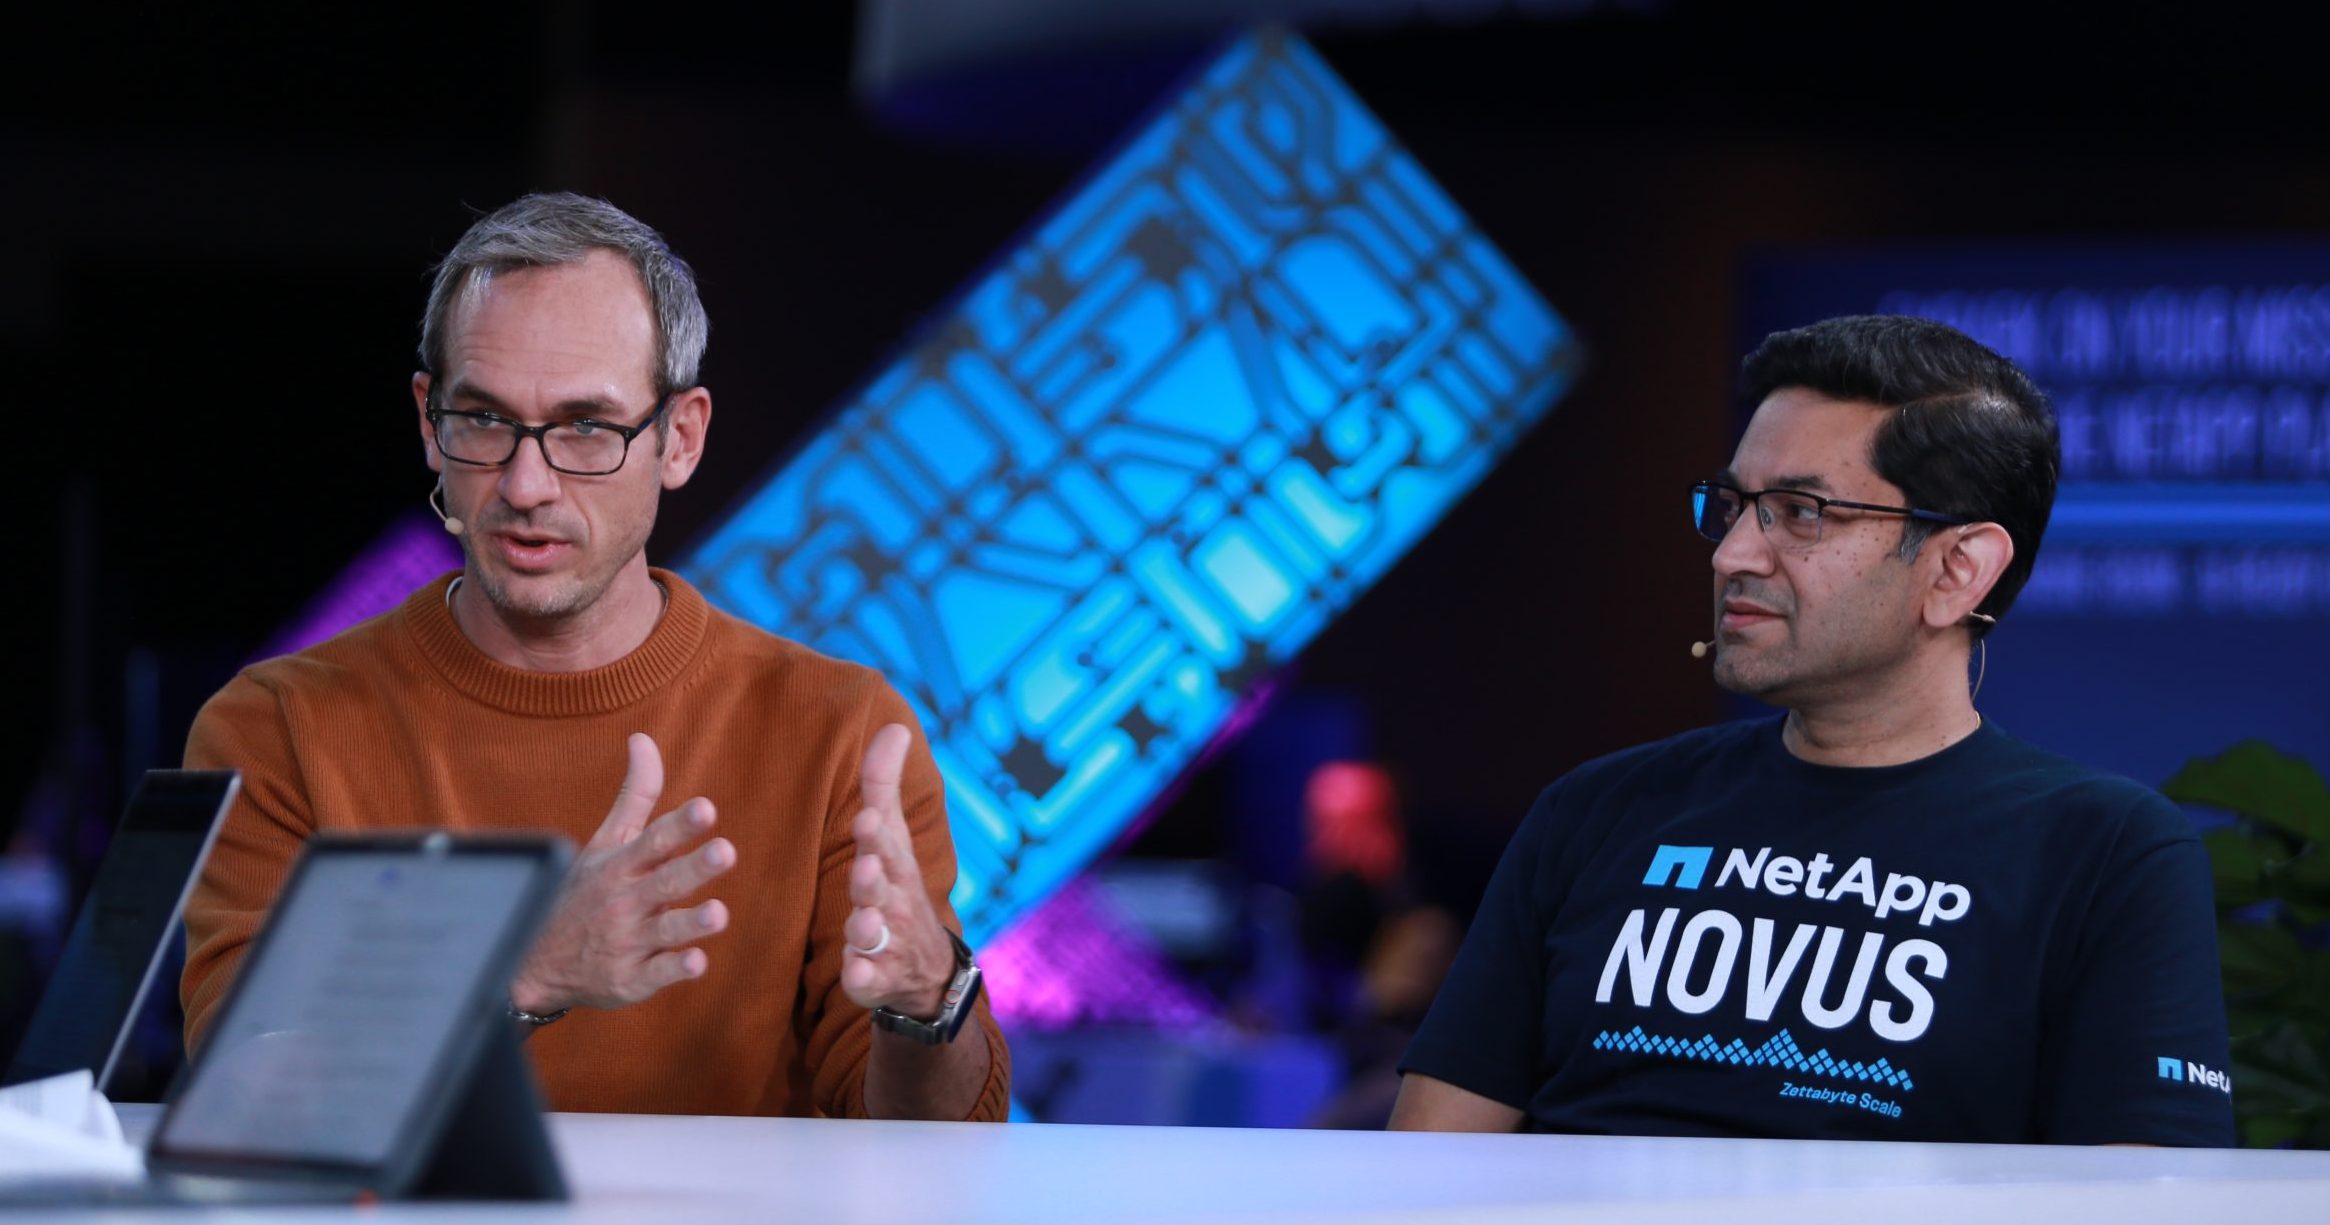
NetApp Inc. répond à cette pression grâce à son travail avec Nvidia Corp., un partenariat qui remonte à plus d'une décennie et qui inclut désormais la co-ingénierie autour de l'infrastructure de l'IA. L'architecture Novus de NetApp sépare les fonctions de données et de métadonnées afin que chacune puisse évoluer indépendamment en fonction des différentes demandes de charge de travail tout en conservant les ressources GPU alimentées en données, selon Arindam Banerjee (photo de droite), directeur de la plate-forme et de la technologie de NetApp.
« Ce qui se produit, ce sont différents types de charges de travail, comme les charges de travail transactionnelles pour les métadonnées et les lourdes charges de travail séquentielles pour, par exemple, les points de contrôle », a déclaré Banerjee. « Les architectures précédentes faisaient très bien l'un ou l'autre. Elles n'ont jamais été capables de le combiner et de faire les deux en même temps. C'est ce que les usines d'IA nous poussent, les charges de travail nous poussent à faire les deux en même temps en termes de données. »
Banerjee et Jason Hardy (à gauche), vice-président de la technologie de stockage chez Nvidia, se sont entretenus avec Christophe Bertrand et Rebecca Knight de NetApp INSIGHT, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont expliqué comment les usines et les agents d’IA obligent les systèmes de stockage à évoluer et à fonctionner différemment. (* Divulgation ci-dessous.)
L’architecture de stockage évolue avec l’échelle de l’IA
La séparation des métadonnées de la gestion des données vise à empêcher les petites opérations transactionnelles de concurrencer les transferts de données volumineux pour les mêmes ressources. Cela est important car les retards de stockage peuvent laisser des GPU coûteux sous-utilisés même s'ils continuent à consommer de l'énergie, ce qui fait de l'efficacité une partie plus importante de l'équation de mise à l'échelle de l'IA, a expliqué Banerjee.
« Ce que nous pouvons faire, c'est adapter chacun d'eux indépendamment sur différents axes », a-t-il déclaré. « Si les métadonnées et les données partageaient les mêmes ressources, les mêmes médias, le même réseau, cela aboutirait à un système inefficace. Parce que les opérations de données seraient mises en file d'attente derrière les opérations de métadonnées, qui sont petites et de nature transactionnelle. Cela non seulement laissait vos GPU sous-utilisés, mais ils consommaient de l'énergie. Pour rétablir l'efficacité, tirer le meilleur parti de nos écosystèmes et maintenir les GPU alimentés, nous devions opérer ce changement architectural. «
L’infrastructure d’IA doit également évoluer sans obliger les entreprises à repenser le système à chaque fois qu’un nouveau cas d’utilisation est mis en ligne. L’objectif est une plus grande flexibilité en termes de réglage fin, d’inférence, de capacité et de données prêtes pour l’IA à mesure que les charges de travail de production changent et que la demande évolue dans différentes parties de l’infrastructure, a souligné Hardy.
« Je pense que tout se résume à la première chose: vous voulez être capable de concevoir un système qui vous permet d'évoluer au fil du temps », a-t-il déclaré. « Lorsque vous intensifiez vos efforts… ils entrent dans cette phase 2 où nous avons maintenant dépassé l'essai et où la production grand public commence vraiment. Les agents d'IA commencent vraiment à apparaître maintenant. L'inférence à l'échelle de l'entreprise est en train de se produire. »
Les agents placent la barre plus haut en matière de concurrence
Les charges de travail agents génèrent un autre type de pression, car des milliers d'agents peuvent avoir besoin d'accéder aux données en même temps. Leurs autorisations peuvent également être temporaires et de portée limitée, augmentant le volume des opérations de métadonnées parallèlement aux exigences de débit déjà imposées aux systèmes de stockage, a noté Banerjee.
« Je pense que nous avons parlé de débit. C'est important », a-t-il déclaré. « Une autre chose très importante est la concurrence. Si vous pensez que des agents arrivent et accèdent à vos données, des milliers d'entre eux arrivent en même temps, s'autorisant… tout cela se produit en même temps apporte un ensemble très différent d'exigences de concurrence à vos systèmes en dehors du débit. L'accès aux métadonnées via les agents simultanés est ce qui redéfinit vraiment la façon dont nous allons construire cette chose pour l'avenir. «
Ce changement opérationnel change également qui interagit avec la couche de stockage. Les équipes d'IA peuvent avoir besoin de provisionner et d'utiliser l'infrastructure sans devenir des spécialistes du stockage, ce qui rend les API, les SDK et les contrôles conviviaux pour les agents de plus en plus importants à mesure que ces environnements passent en production et font partie des opérations quotidiennes de l'entreprise, a expliqué Banerjee.
« Supprimez la complexité », a-t-il déclaré. « Ce sont des équipes d'IA, ce ne sont pas des équipes d'ingénierie de stockage. Elles devraient être capables de consommer du stockage via une API, de coder vers une API, de coder vers un SDK, par exemple. Ou à l'avenir, ce seront peut-être des agents qui feront ce travail. Il doit s'agir d'une consommation vraiment pilotée par les API et conviviale pour les agents. C'est pourquoi nous concevons un nouveau plan de contrôle qui permet la consommation de Novus via les API. »
Voici l'interview vidéo complète, qui fait partie de la couverture de NetApp INSIGHT par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour NetApp INSIGHT. Ni NetApp, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
