L'infrastructure de données d'IA doit prendre en charge la croissance des clusters GPU tout en rendant les données d'entreprise utilisables pour les modèles et les agents.
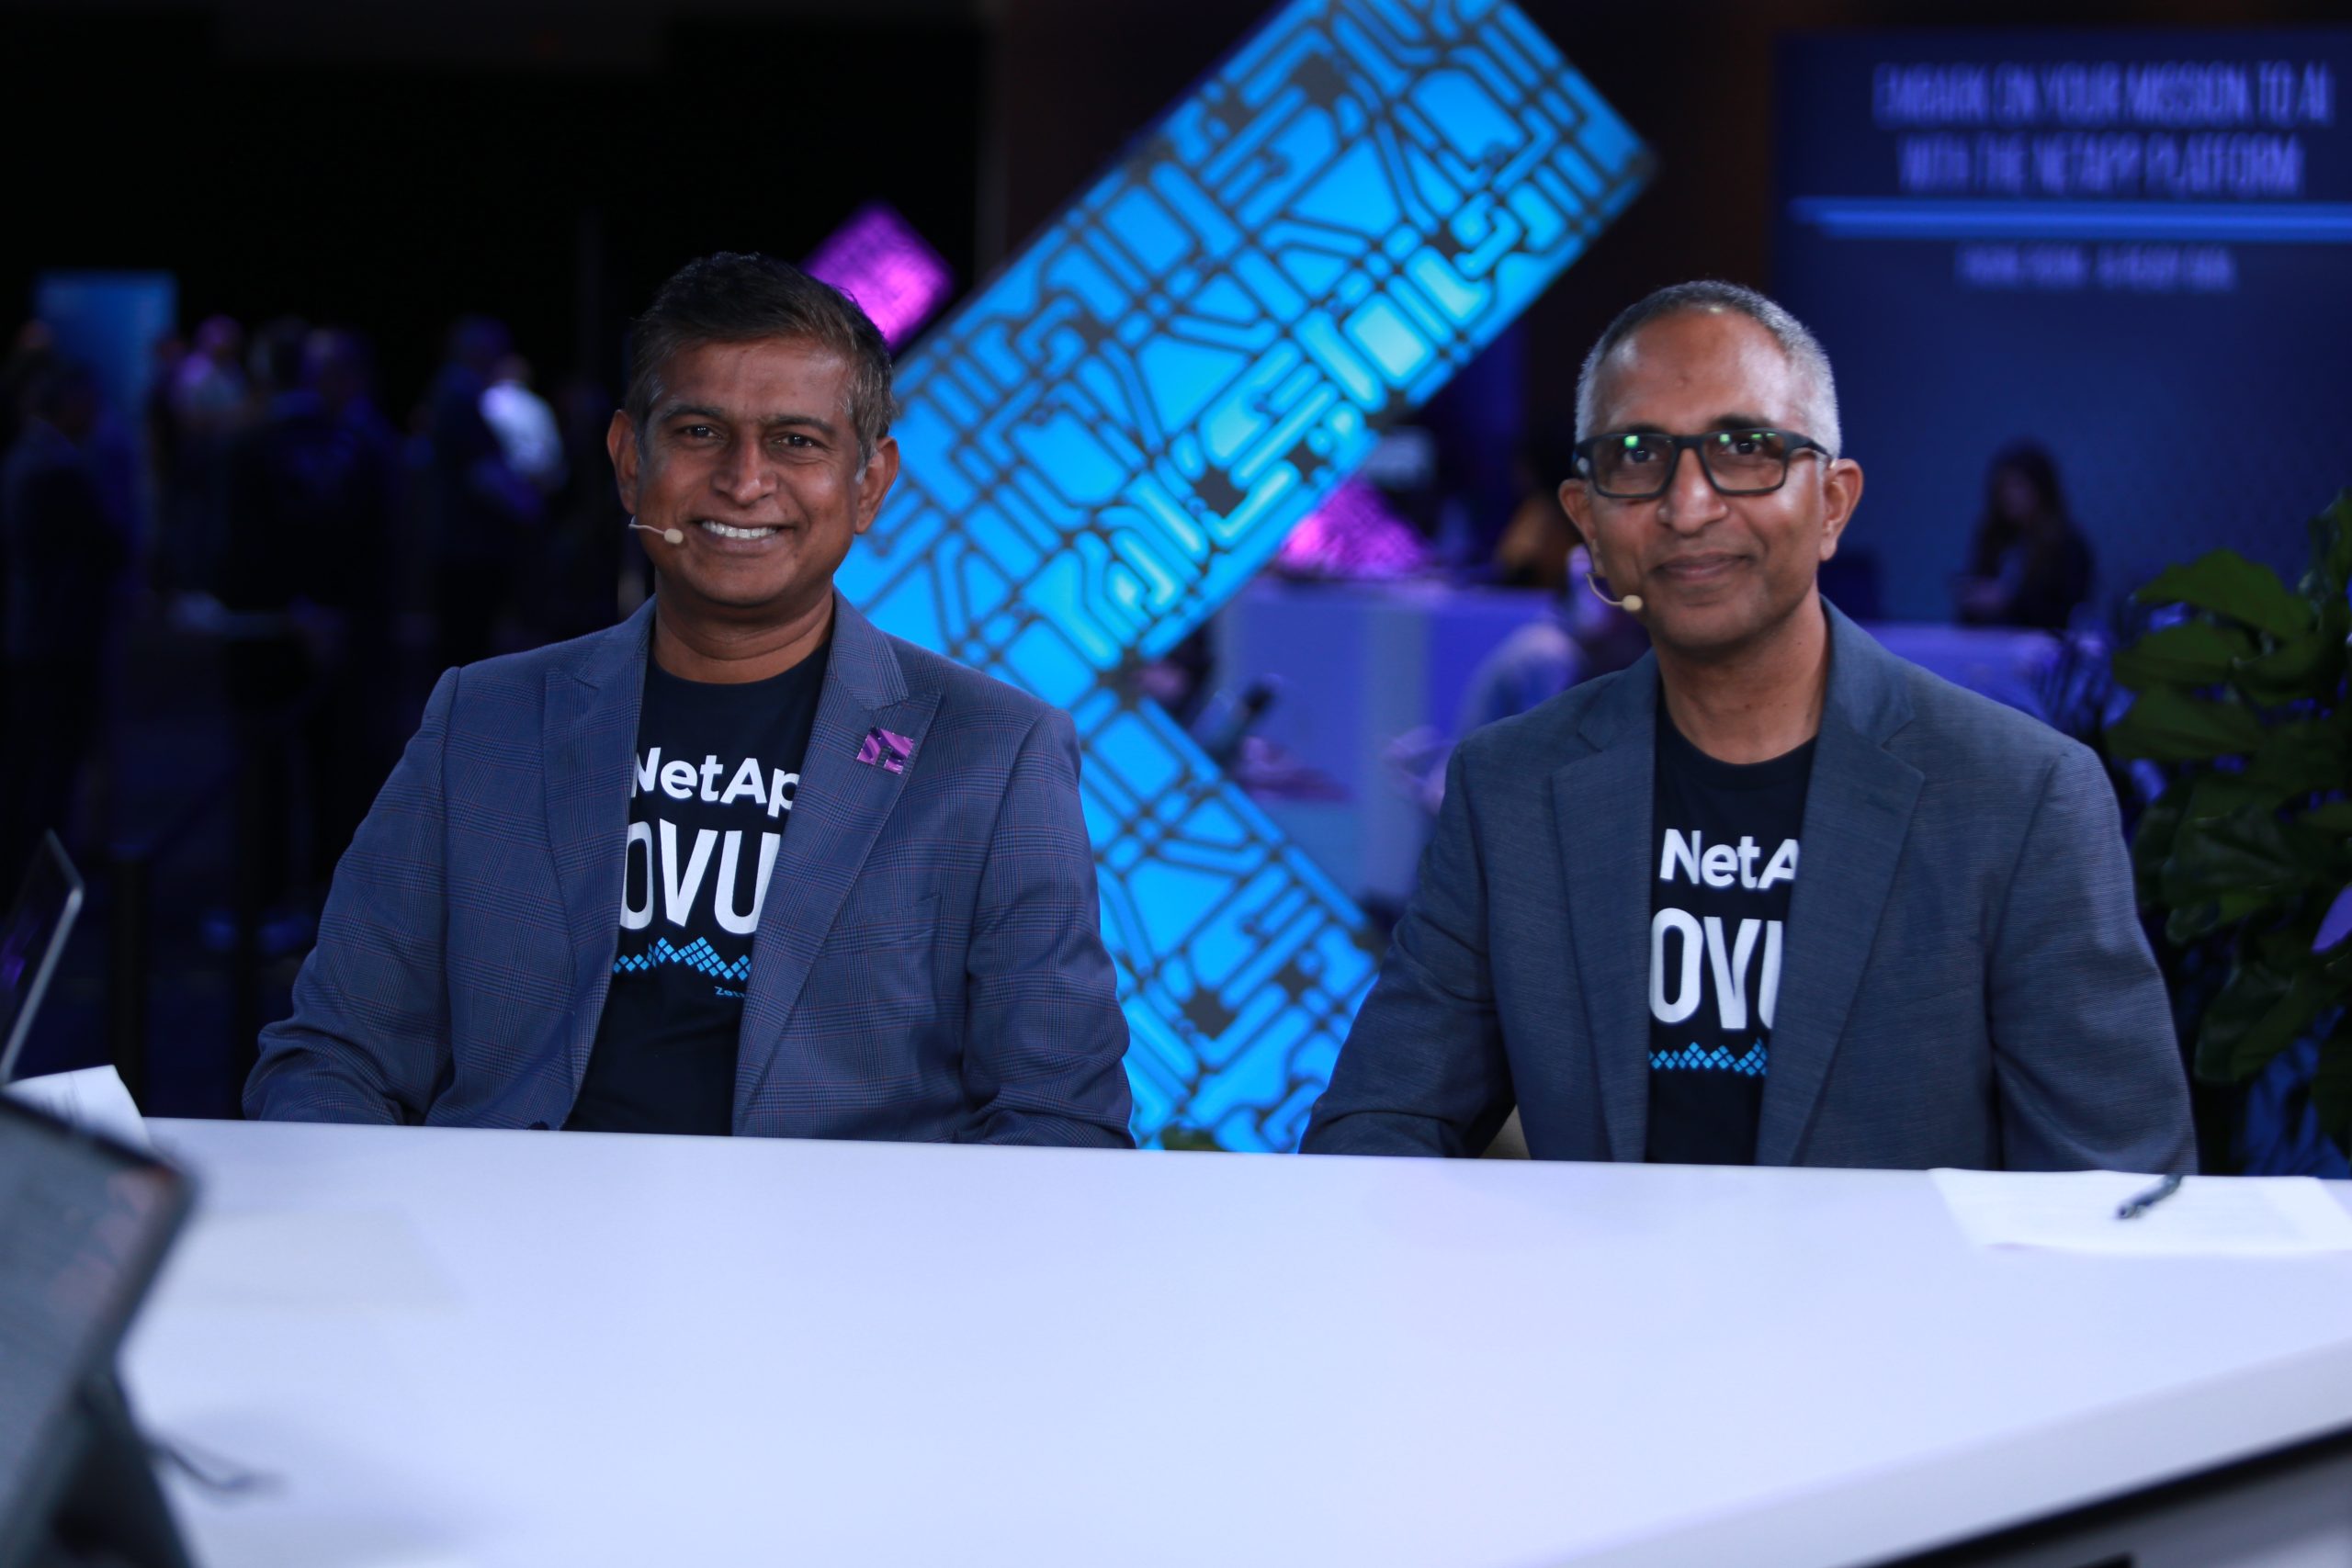
NetApp Inc. associe l'infrastructure de données intelligente à l'IA de production grâce à une approche unifiée du stockage et de la gestion des données. Selon Syam Nair (photo, à gauche), directeur produit de NetApp, des données fragmentées et une gouvernance conçue autour de politiques appliquées manuellement peuvent empêcher les entreprises de réaliser des retours sur leurs investissements en IA.
« De nombreux investissements sont réalisés, de nombreuses applications de données sont prêtes, des modèles sont prêts, mais la plupart des entreprises n'obtiennent pas de retours sur investissement », a-t-il déclaré. « Fournissons cette infrastructure de données intelligente où il existe un stockage unifié qui couvre l'ensemble de l'écosystème, où que se trouve l'infrastructure. »
Nair et Gunna Marripudi (à droite), vice-président de la gestion des produits pour Novus chez NetApp, se sont entretenus avec Christophe Bertrand de theCUBE Research et co-animatrice Rebecca Knight chez NetApp INSIGHT, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. (* Divulgation ci-dessous.)
Reconstruire l'infrastructure de données de l'IA à l'échelle du zettaoctet
L'architecture de stockage Novus de NetApp dépasse 100 To/s de débit global, selon la société. Son directeur de données gère les métadonnées séparément des données stockées, permettant à chacune d'évoluer indépendamment. Cela donne également aux applications une vue unifiée des fichiers sur plusieurs clusters de stockage ONTAP plutôt que de les obliger à accéder à chaque cluster séparément, a expliqué Marripudi.
« Les métadonnées sont la clé », a-t-il déclaré. « La concurrence d'accès aux métadonnées est le pilier d'une architecture. »
Cependant, la vitesse à elle seule ne rend pas les données utilisables par les agents IA. Le moteur de données AI de NetApp découvre, classe et vectorise les données d'entreprise, dans le but de réduire le travail de préparation qui prend généralement six à neuf mois d'ingénierie, a noté Nair.
« La performance et le débit d'accès aux données sont une nécessité pour l'IA, mais cela ne suffira pas pour que les agents puissent réellement agir sur les données », a-t-il déclaré. « Si les données ne sont pas prêtes et ne sont pas protégées, vous obtenez des résultats rapides. compromis résultats, mais ils ne seront peut-être pas ceux que vous souhaitez.
NetApp s'appuie également sur des normes ouvertes afin que les clients puissent étendre ce qu'ils utilisent déjà. L'acquisition prévue de PEAK:AIO Ltd. devrait apporter une technologie de système de fichiers parallèle basée sur le protocole pNFS. Tout noyau Linux publié après 2018 comporte déjà un client pNFS, a expliqué Marripudi. L’objectif est une infrastructure de données d’IA qui s’intègre aux systèmes existants.
« Ce n'est pas une conversation sur le stockage, ce n'est pas une conversation sur une plate-forme de données, c'est une conversation sur l'infrastructure des données », a déclaré Nair. « La promesse que nous avons est la suivante : 'Clients, vous n'avez pas besoin de déchirer et de remplacer ce que vous avez déjà. »
Voici l'interview vidéo complète, qui fait partie de la couverture de NetApp INSIGHT par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour NetApp INSIGHT. Ni NetApp Inc., le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
