Nvidia Corp. a annoncé aujourd'hui de nouveaux partenariats et contributions à la communauté open source lors de l'Open Compute Project Global Summit à San Jose, visant à jeter les bases de l'avenir de l'infrastructure d'intelligence artificielle agentique.
Au cœur de ces annonces, le géant des puces et du matériel a contribué aux conceptions clés de racks et de plateaux de calcul Vera Rubin au projet Open Compute via l'architecture Nvidia MGX de la société. Cela donnera aux constructeurs de systèmes des plans communs pour que les usines d'IA puissent développer les futures configurations de racks, la conception de réseaux, les systèmes d'alimentation et de refroidissement.
« Le véritable goulot d'étranglement pour l'industrie à l'heure actuelle est la rapidité avec laquelle le monde peut fabriquer et déployer des usines d'IA », a déclaré Joe DeLaere, responsable des solutions d'infrastructure d'IA.
Grâce à MGX 1.2, Nvidia fournit également des composants ouverts qui permettent aux ingénieurs de faire évoluer et de lier rapidement le refroidissement liquide et une infrastructure d'interconnexion interopérable au niveau du rack pour les systèmes d'IA haute puissance. Il ajoute également de la modularité pour les baies d'E/S sans ventilateur refroidies par liquide et une alimentation standardisée, permettant de rationaliser la fabrication et l'installation sur le terrain.
Les racks présentent la conception de rack d'unité centrale de traitement Vera et étendent l'architecture Nvidia MGX au-delà de l'informatique accélérée pour gérer les tâches d'IA agentique les plus intenses.
Bien que l’industrie se concentre fortement sur les unités de traitement graphique, la bête de somme de la formation et de l’inférence de l’IA, lorsque l’IA est déployée à grande échelle, les processeurs obtiennent souvent le statut de citoyen de seconde zone. Ce sont les orchestrateurs qui effectuent la plupart du travail en coulisses, en divisant le réseau, en faisant déplacer les données, en sandboxant l'exécution et en traitant les bits, tandis que les GPU effectuent l'exécution parallèle pour le travail d'IA.
« Entre les appels modèles, les agents doivent procéder à l'orchestration », a déclaré DeLaera. « Ils doivent exécuter du code. Ils doivent traiter des données, exécuter des évaluations. »
Sans GPU gérant la logistique des flux de données et coordonnant la couche applicative, le système d’IA s’effondre rapidement, comme une armée sans ligne d’approvisionnement bien huilée.
Nvidia affirme que ses processeurs Vera offrent environ deux fois les performances de sa génération précédente de GPU Grace sur plusieurs tests de charge de travail, et une amélioration de 1,8 fois sur Terminal-Bench, qui mesure les tâches pratiques des agents impliquant des conteneurs de code.
Les partenariats ouvrent la voie au reste de l’usine d’IA
À mesure que les usines d’IA deviennent plus complexes, le matériel informatique ne constitue qu’une partie de l’équation. Nvidia a également annoncé son partenariat avec Meta Platforms Inc., Google LLC et Cisco Systems Inc.
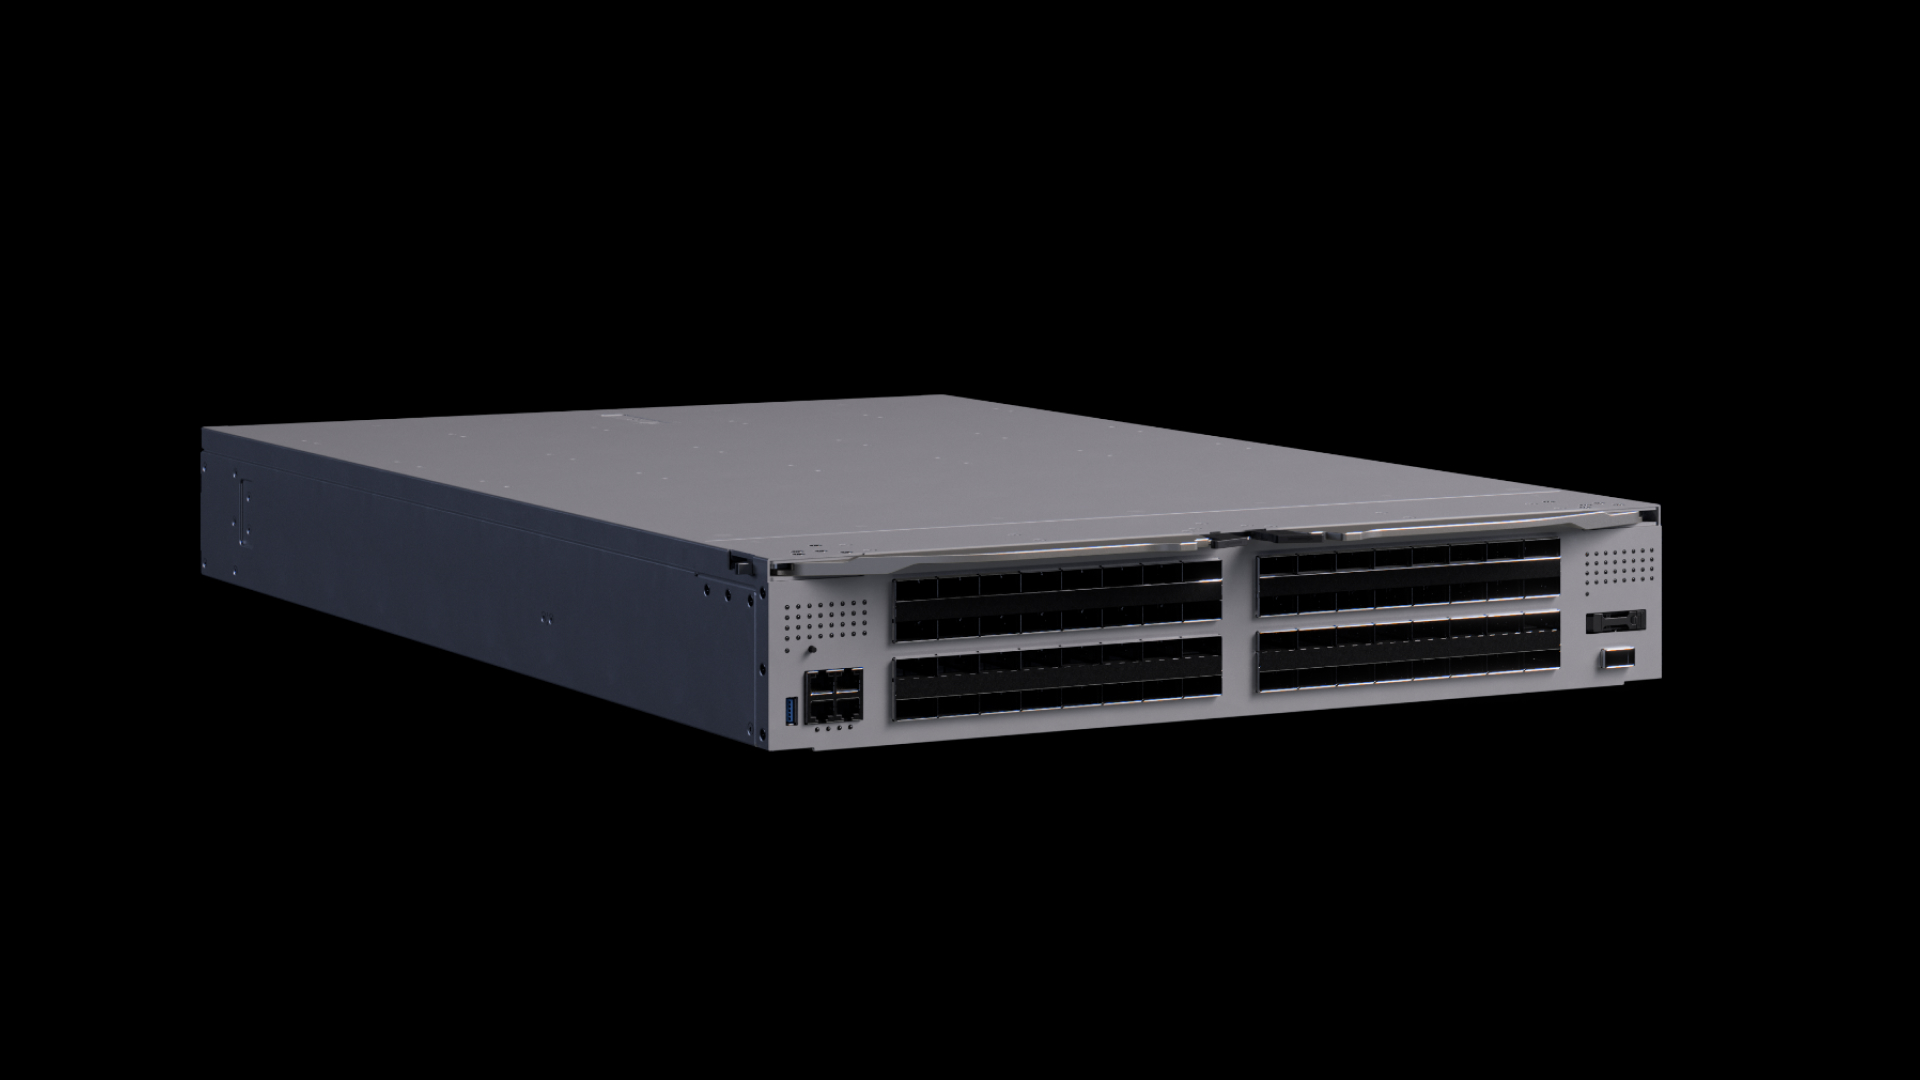
Meta adopte le commutateur Ethernet Nvidia Spectrum-6 pour son réseau d'usine d'IA de nouvelle génération, qui se connectera directement aux déploiements Vera-Rubin. Spectrum-6 est la puce de commutation Ethernet de 102,4 térabits par seconde de Nvidia, conçue pour gérer un trafic massif et des réseaux de structure, tels que ceux générés lorsque les systèmes informatiques d'IA distribuent des données à des fins de travail sur des milliers de processeurs ou de GPU à des fins de formation et d'inférence.
Nvidia ajoute la prise en charge de Falcon Transport de Google à son écosystème de réseau Ethernet Spectrum-X, en commençant par les futures SuperNIC ConnectX-10 de la société. La feuille de route s'étend également au matériel BlueField. Falcon est une technologie de transport conçue pour gérer efficacement la livraison de données dans des réseaux à grande échelle. Il peut déplacer le trafic sur plusieurs chemins, répondre aux embouteillages, récupérer les paquets perdus et maintenir des connexions sécurisées.
S'appuyant également sur les réseaux, Nvidia et Cisco définissent conjointement un nouveau format de module optique : un Ultra-dense Small Form Factor Pluggable, ou USFP, conçu pour prendre en charge les futures structures réseau de 400 gigabits par seconde par voie.
Ce module optique enfichable agit comme un composant amovible, permettant aux équipements réseau de transmettre et de recevoir des informations via des connexions à fibre optique. La conception USFP offrira quatre fois la densité de bande passante du facteur de forme OSFP 200G existant ; Nvidia revendique une amélioration de 1,3 fois de l’efficacité énergétique.
Grâce à ces partenariats, Nvidia cherche non seulement à développer l’échelle CPU pour les plans d’usine d’IA, mais également à devenir l’épine dorsale du réseau – la structure qui déplace les données entre l’IA agentique et les applications qui fournissent et consomment les résultats. Une plus grande capacité réseau peut s'adapter à la même empreinte physique avec une consommation moindre, permettant ainsi aux opérations des centres de données d'étendre leurs réseaux sans systèmes de commutation plus grands.
