Les flux de travail agentiques font de la vitesse une condition pour l’existence de classes entières d’applications d’IA, et les jetons les plus rapides détermineront quelles plates-formes remporteront la prochaine phase de l’IA.
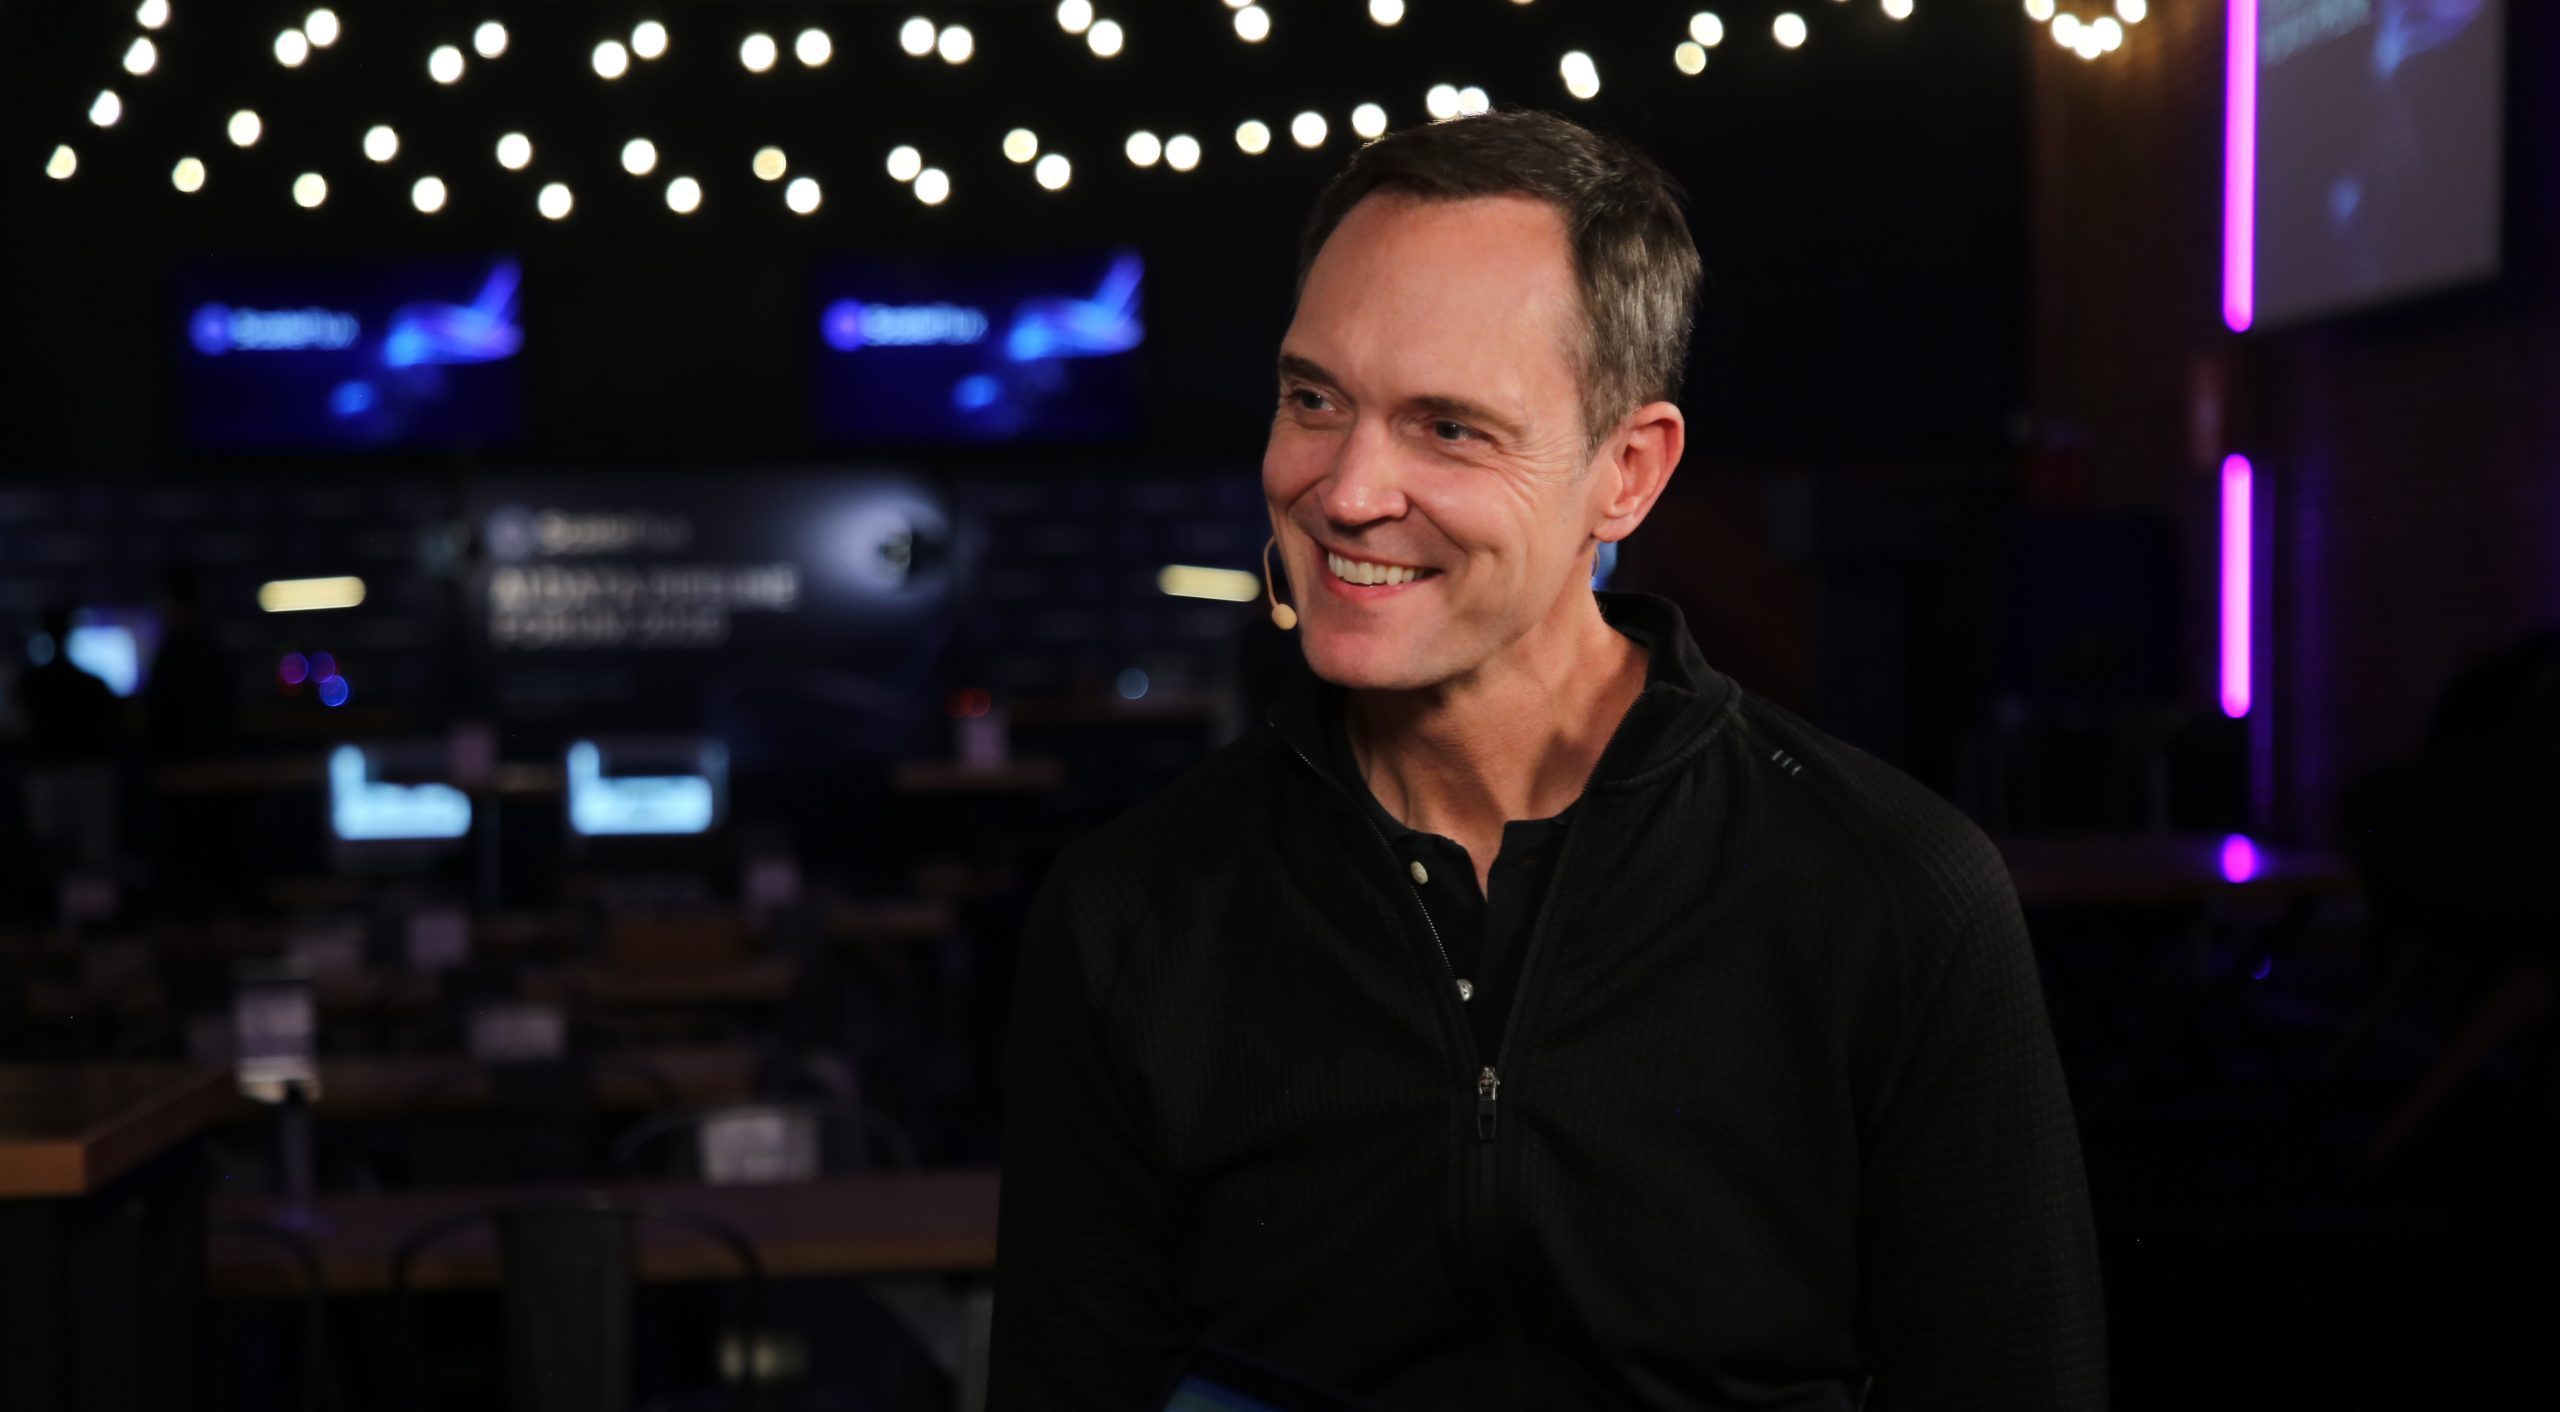
Cerebras Systems Inc., qui a levé 5,5 milliards de dollars lors de son introduction en bourse en mai 2026, a bâti son activité sur la fabrication de processeurs beaucoup plus rapides, selon Andy Hock (photo), directeur de la stratégie de Cerebras.
« Nous ne l'avons pas construit en grand parce que gros a l'air cool. Nous l'avons construit en grand parce que l'IA veut de grosses puces », a déclaré Hock. « L'IA a besoin de beaucoup de calcul, mais elle a besoin que ce calcul soit proche les uns des autres, et elle a également besoin que ce calcul soit proche de la mémoire. »
Hock s'est entretenu avec John Furrier de theCUBE Research au AI Data Pipeline Forum, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté des flux de travail agents et de l'importance de la vitesse d'inférence. (* Divulgation ci-dessous.)
Pourquoi les workflows agents font de la vitesse une exigence
Le moteur Wafer-Scale Engine de Cerebras est plus de 50 fois plus volumineux que les processeurs conventionnels précédents, et la société affirme que ses performances d'inférence sont 10 à 15 fois plus rapides que celles des plates-formes GPU concurrentes. Dans les flux de travail agentiques, cela signifie que davantage d’agents travaillent ensemble, a expliqué Hock.
« Une question de votre part ou de moi dans un système agent n'engendre pas seulement un agent intelligent qui s'exécute et fait un travail ou répond à une question pour nous, mais elle engendre une famille d'agents filles qui font tous un travail différent et se coordonnent tous ensemble », a déclaré Hock. « C'est là que la vitesse fait vraiment la différence. »
Cerebras a publié ses résultats du premier trimestre 2026 en juin. Au cours des deux derniers mois, les laboratoires de fondation et les entreprises se sont éloignés du tokenmaxxing et se sont tournés vers l'exploitation maximale de chaque jeton, a noté Hock.
« Ils prennent des décisions basées sur ce paradigme de maximisation de la valeur sur les modèles, sur les ensembles de données et sur l'infrastructure », a-t-il déclaré. « Du côté de l'infrastructure, pour revenir à Cerebras, ce que nous constatons, c'est que nos utilisateurs finaux tirent réellement le meilleur parti des jetons les plus rapides. »
Voici l'interview vidéo complète, qui fait partie de la couverture par SiliconANGLE et theCUBE du forum AI Data Pipeline :
(* Divulgation : ScaleFlux a sponsorisé ce segment de theCUBE. Ni ScaleFlux ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
