
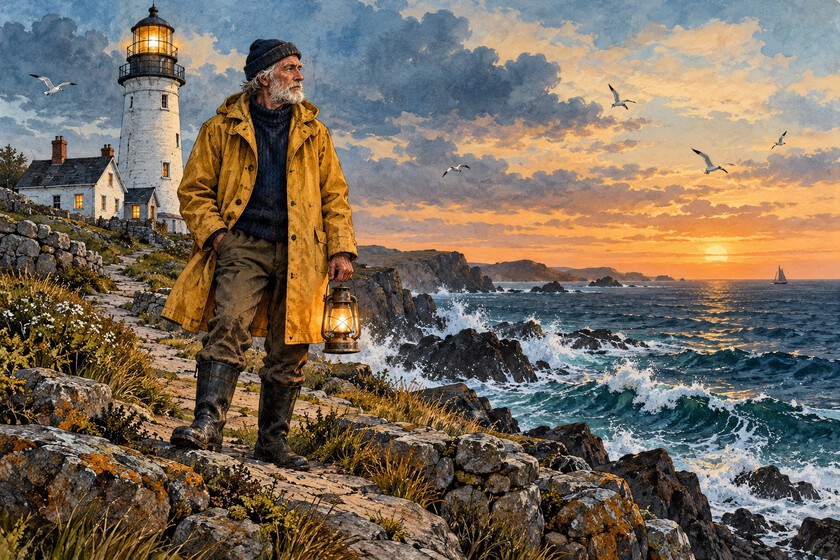
Elías est un gardien de phare qui apparaît très fréquemment lorsqu'il faut demander à un modèle d'intelligence artificielle d'écrire une histoire. Son nom et sa profession apparaissent régulièrement dans les résultats de différents fournisseurs, comme l'a publié le Cornell Chronicle, sur la base de recherches qui montrent que les autres détails des histoires changent, mais que les mêmes contextes et professions apparaissent constamment.
L'étude de Hamilton et Mimno a analysé vingt mille histoires, et 88,3 % d'entre elles contenaient au moins un des onze mots clés. 51,2 % contenaient « phare » et 26,5 % contenaient « Elias ». Ces pourcentages sont sensiblement différents, mais l’article précise que la recherche ne suggère pas que neuf histoires sur dix contiennent le mot « phare ».
« Vous pensez avoir une histoire unique. »déclare Sil Hamilton, doctorant en sciences de l'information. Son collaborateur est David Mimno, professeur à la même université. Les résultats ont été publiés le 19 octobre 2026, avant la tenue de la conférence EMNLP du 24 au 29 octobre à Budapest.
La révision de ses histoires s'est basée sur les versions Claude Haiku 4.5, Gemini 3.1 Flash-Lite, GPT-5.4-Mini et OLMo 7b Thinking. Ils ont tous répondu mille fois à chacune des cinq demandes en anglais, dont « écrire une histoire »et la description de l'étude sur arXiv est datée du 26 mai 2026, les pourcentages font donc référence à ces conditions, et non à une conversation avec d'autres instructions ou une version ultérieure.
Les personnages ont des métiers traditionnels et se trouvent dans des lieux familiers. « L’ambiance est toujours vaguement antérieure à l’époque contemporaine »dit Hamilton. Les chercheurs soupçonnent que le réglage pourrait favoriser cette répétition, même s’ils n’en ont pas prouvé la cause.
La recherche ne prétend pas que les modèles linguistiques sont incapables d’écrire des histoires intéressantes et diverses. Hamilton souligne que l’aspect créatif de l’écriture reçoit peu d’attention dans le développement de modèles linguistiques.
Ce que WildChat apporte à la recherche
Hamilton et Mimno ont analysé un ensemble de données appelé WildChat, créé en 2024 comme une collection d'un million de conversations ChatGPT. Ils l'ont observé et ont découvert des fragments sur le gardien de phare Elías, et ils pensent que cette découverte pourrait nous permettre de suivre la façon dont ces modèles se transmettent entre les ensembles d'entraînement. Cependant, les raisons pour lesquelles ils apparaissent si fréquemment restent l’objet de recherches.
WildChat contient de véritables conversations entre les utilisateurs et ChatGPT. Il a été créé avec le consentement de ceux qui accédaient gratuitement à ChatGPT et ses auteurs ont proposé son utilité pour aider les personnes souhaitant affiner ces modèles à suivre les instructions.
Avec de telles données, il est possible d’étudier comment les réponses d’un modèle de langage peuvent être incorporées dans la formation d’autres modèles de langage, ce qui aiderait les gens à mieux comprendre les données sur lesquelles sont basés les modèles de langage affinés, mais l’existence même de cette circulation de données ne démontre pas ce qui a causé la prédominance notable de ces histoires dans les réponses.
Selon l'analyse d'OLMo, dans ses 78 958 histoires de tuning ultérieures, 3 053 contenaient au moins un des onze mots, une proportion que les auteurs évaluent à 3,8 %. Cette valeur n'explique pas pourquoi les mots ont autant de poids dans les réponses générées, et les mots étaient beaucoup plus rares dans les romans anglais et dans les données de pré-entraînement OLMo 3 analysées que dans les histoires générées. De plus, l’expérience a été réalisée avec des instructions et des réponses en anglais.
Les auteurs ont rendu publics les identifiants de l'histoire afin que d'autres puissent localiser les enregistrements dans les référentiels publics de données de post-réglage d'OLMo 3, avec des instructions pour les télécharger. La portée de cette enquête peut également être confondue avec l'accès aux données post-réglage des concurrents, dans la mesure où elle documente la situation d'OLMo, mais ne fournit pas les données des autres marques.
Créativité et diversité dans les histoires
Dans une autre expérience, la similitude entre les histoires n’a pas empêché les répondants de les évaluer positivement. Selon une expérience menée par Doshi et Hauser, les écrivains étaient chargés d'écrire des histoires, certains avec l'aide d'idées issues d'une intelligence artificielle et d'autres sans. Ensuite, 600 juges ont évalué ces textes pour leur créativité, sans savoir quels écrivains avaient reçu des idées d'une IA et lesquels ne l'avaient pas reçu. Les textes aidés ont reçu des notes de créativité plus élevées, mais ont également montré une plus grande similitude les uns avec les autres.
L'interprétation du résultat, selon la publication de l'UCL sur l'étude, est que l'amélioration du score de créativité était plus importante pour les auteurs ayant moins de créativité originale. Il est important de noter que cette distinction pourrait s’appliquer à l’utilisation de l’intelligence artificielle pour rechercher des idées. Les évaluations d’une histoire individuelle et de la variété de l’ensemble peuvent évaluer différents aspects, et un outil peut aider à écrire une histoire agréable, tout en permettant à différentes personnes de parvenir plus facilement à des histoires similaires. Nous écrivons déjà des tests de créativité avec des mèmes.
C’est l’objectif de NouveautéBench, une recherche menée en 2025 par Yiming Zhang et ses co-auteurs, qui ont testé vingt modèles de langage sur leur capacité à produire des réponses multiples, distinctes et de qualité. Les auteurs rapportent que la diversité était inférieure à celle des réponses écrites par des humains et qu'au sein d'une famille, les modèles plus grands généraient souvent moins de diversité. Demander de nouvelles réponses basées sur les précédentes pourrait améliorer la variété, même si cela pourrait encore poser problème.
Par conséquent, il peut y avoir une opportunité de comparer les scénarios et les conflits posés par diverses histoires avant de décider de travailler sur l’une d’entre elles. Étant donné que changer certains noms ne suffit pas pour conclure que le contenu est différent, cela apparaît comme une recommandation provisoire pour l'application de ces modèles linguistiques à cette fin, accompagnée d'un avertissement selon lequel l'étude d'Elias n'a pas prouvé une solution pour éviter les répétitions de l'histoire du gardien de phare.
