Les charges de travail agentiques poussent Kubernetes sur un territoire que ses créateurs n'avaient jamais prévu. Les agents génèrent du code non fiable à la volée, restent inactifs pendant de longues périodes et parcourent les pods à un rythme qui met à rude épreuve le plan de contrôle de l'orchestrateur.
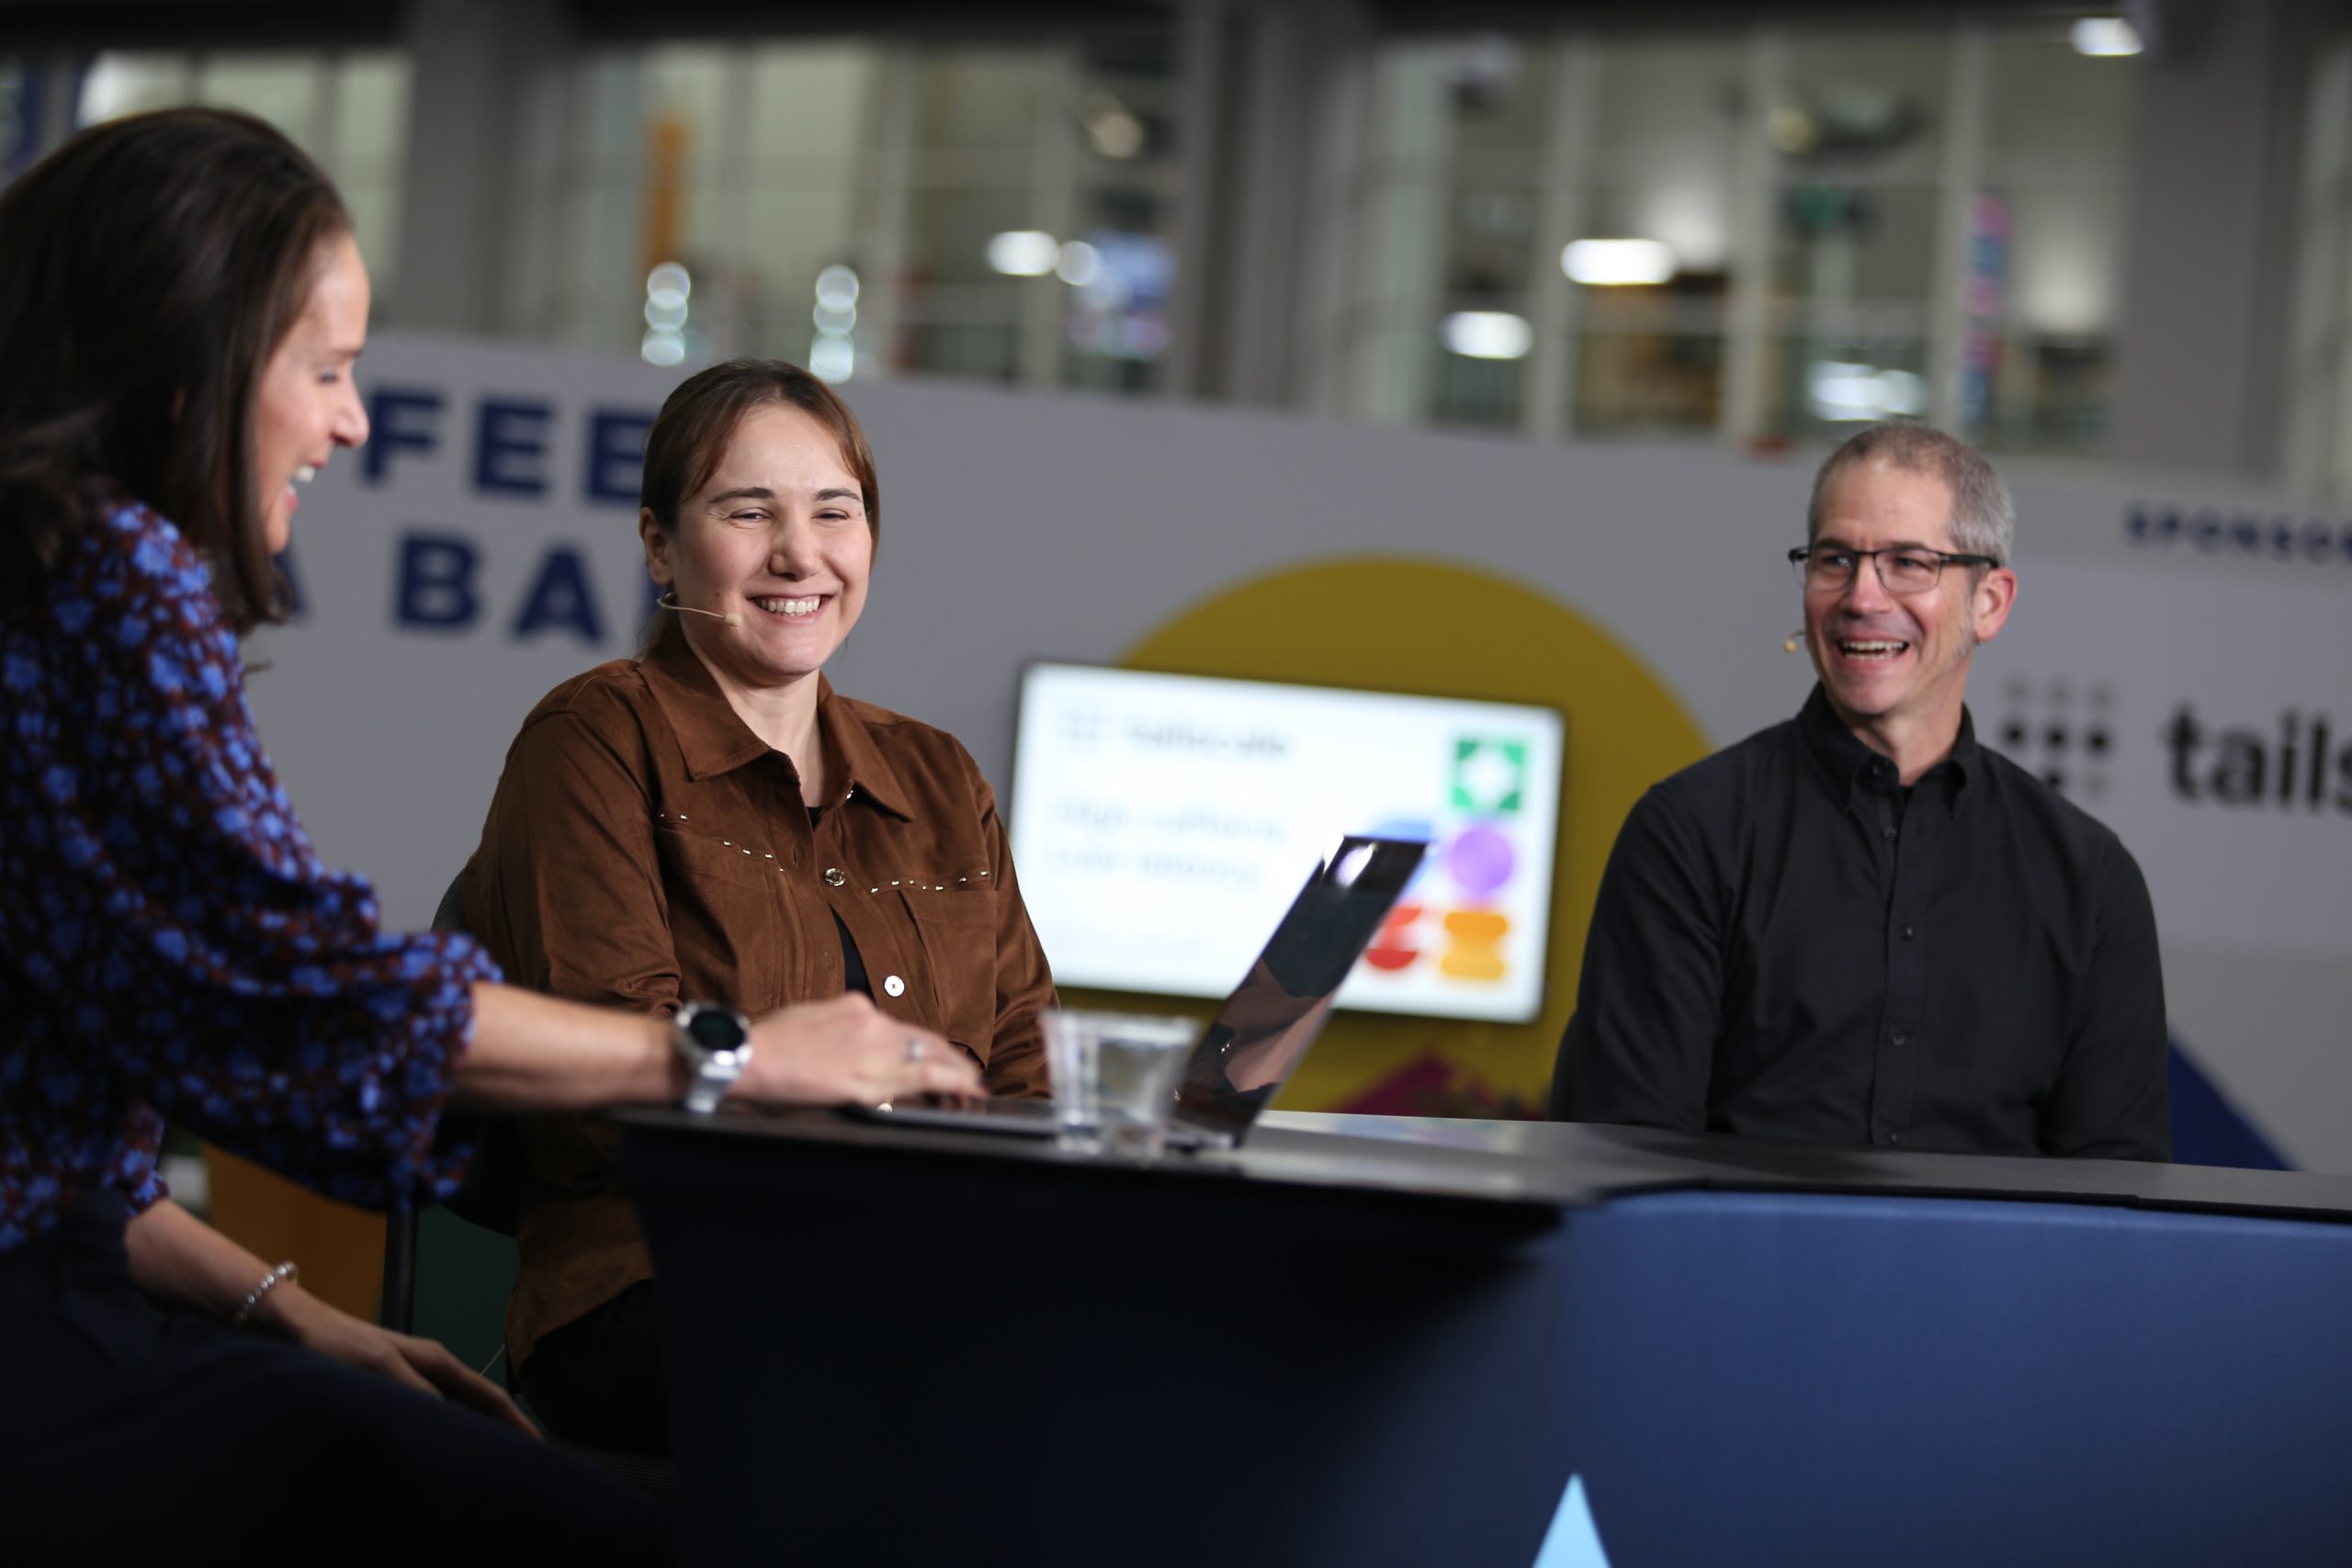
Les fournisseurs de cloud repensent désormais la polyvalence d’un cluster. La réponse de Google LLC est d'arrêter de traiter chaque cluster comme un moteur infiniment flexible et de régler chacun sur un environnement d'exécution optimisé pour sa charge de travail, selon Jago Macleod (photo de droite), directeur de l'ingénierie pour Kubernetes et Google Kubernetes Engine chez Google Cloud.
« Il n'y a pas assez de mémoire. Il n'y a pas assez de machines. Nous devons donc devenir plus efficaces. Et donc l'un des moyens d'y parvenir est de concentrer le cluster Kubernetes sur la charge de travail qu'il exécute et de l'optimiser pour cette charge de travail spécifique », a déclaré Macleod.
Macleod et Jaana Dogan (photo, à gauche), ingénieur principal chez Google Cloud, se sont entretenus avec Rebecca Knight de theCUBE à KubeCon + CloudNativeCon NA, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont expliqué comment Google personnalise Kubernetes pour les charges de travail agents sans fragmenter l'écosystème open source. (* Divulgation ci-dessous.)
Les charges de travail agents mettent à rude épreuve le plan de contrôle Kubernetes
Kubernetes a été conçu pour les microservices, puis étendu pour gérer les tâches de formation dans lesquelles un seul pod revendique un nœud entier, a expliqué Macleod. Les agents sont encore une fois une bête différente, et certaines équipes ont eu recours à la création de plans de contrôle personnalisés juste pour y faire face.
« Je pense que les charges de travail agents sont si différentes dans le thrash et que le taux de désabonnement qu'elles représentent n'est vraiment pas du tout ce pour quoi nous avons construit Kubernetes », a déclaré Macleod. « Et puis les applications agents sont presque à l'opposé, c'est-à-dire que, dans une implémentation naïve, vous avez juste autant de pods que possible, et donc la machinerie API atteint ses limites. »
Les équipes de plate-forme ont passé une décennie à faire de Kubernetes leur infrastructure informatique, et les clients ont déclaré à Google qu'ils ne voulaient pas que les agents la fragmentent, a expliqué Dogan. La réponse de Google est Agent Substrate, qui exécute des agents IA dans des bacs à sable directement sur Kubernetes. La société a fait don du projet à la Cloud Native Computing Foundation et a récemment publié la version 1.0. Étant donné que les agents écrivent leur propre code, ce code n'est pas fiable par défaut et nécessite un sandboxing et des garde-fous réseau, selon Dogan. Les clients ont également signalé une inefficacité coûteuse.
« Par exemple, nos clients nous ont dit : « Hé, la plupart du temps, nos agents sont inactifs, mais nous devons allouer un bac à sable tout au long de la durée d'une session » », a déclaré Dogan. Cela signifie gaspiller beaucoup de cycles CPU, a-t-elle expliqué.
Les agents de codage modifient également la façon dont les ingénieurs travaillent, en produisant davantage de prototypes et des équipes plus petites et plus ciblées, a noté Dogan. À mesure que les charges de travail des agents se multiplient, le jugement humain devient plus précieux que moins, selon Macleod.
« Il ne s'agit pas vraiment, vous savez, de lancer une invite, de l'oublier et de s'en aller », a déclaré Macleod. « Il s'agit simplement d'un niveau différent dans le système où vous appliquez votre jugement et votre expertise. Et cela n'a jamais été aussi important. »
(* Divulgation : Google Cloud a sponsorisé ce segment de theCUBE. Ni Google Cloud ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
