Les entreprises qui abandonnent leurs anciens hyperviseurs découvrent que le déplacement de machines virtuelles ne représente que la moitié du travail et qu'une couche de gestion de données portable décide souvent de la réussite d'une migration Kubernetes. La hausse des coûts de licence pousse les équipes à exécuter des conteneurs et des machines virtuelles sur une seule plateforme.
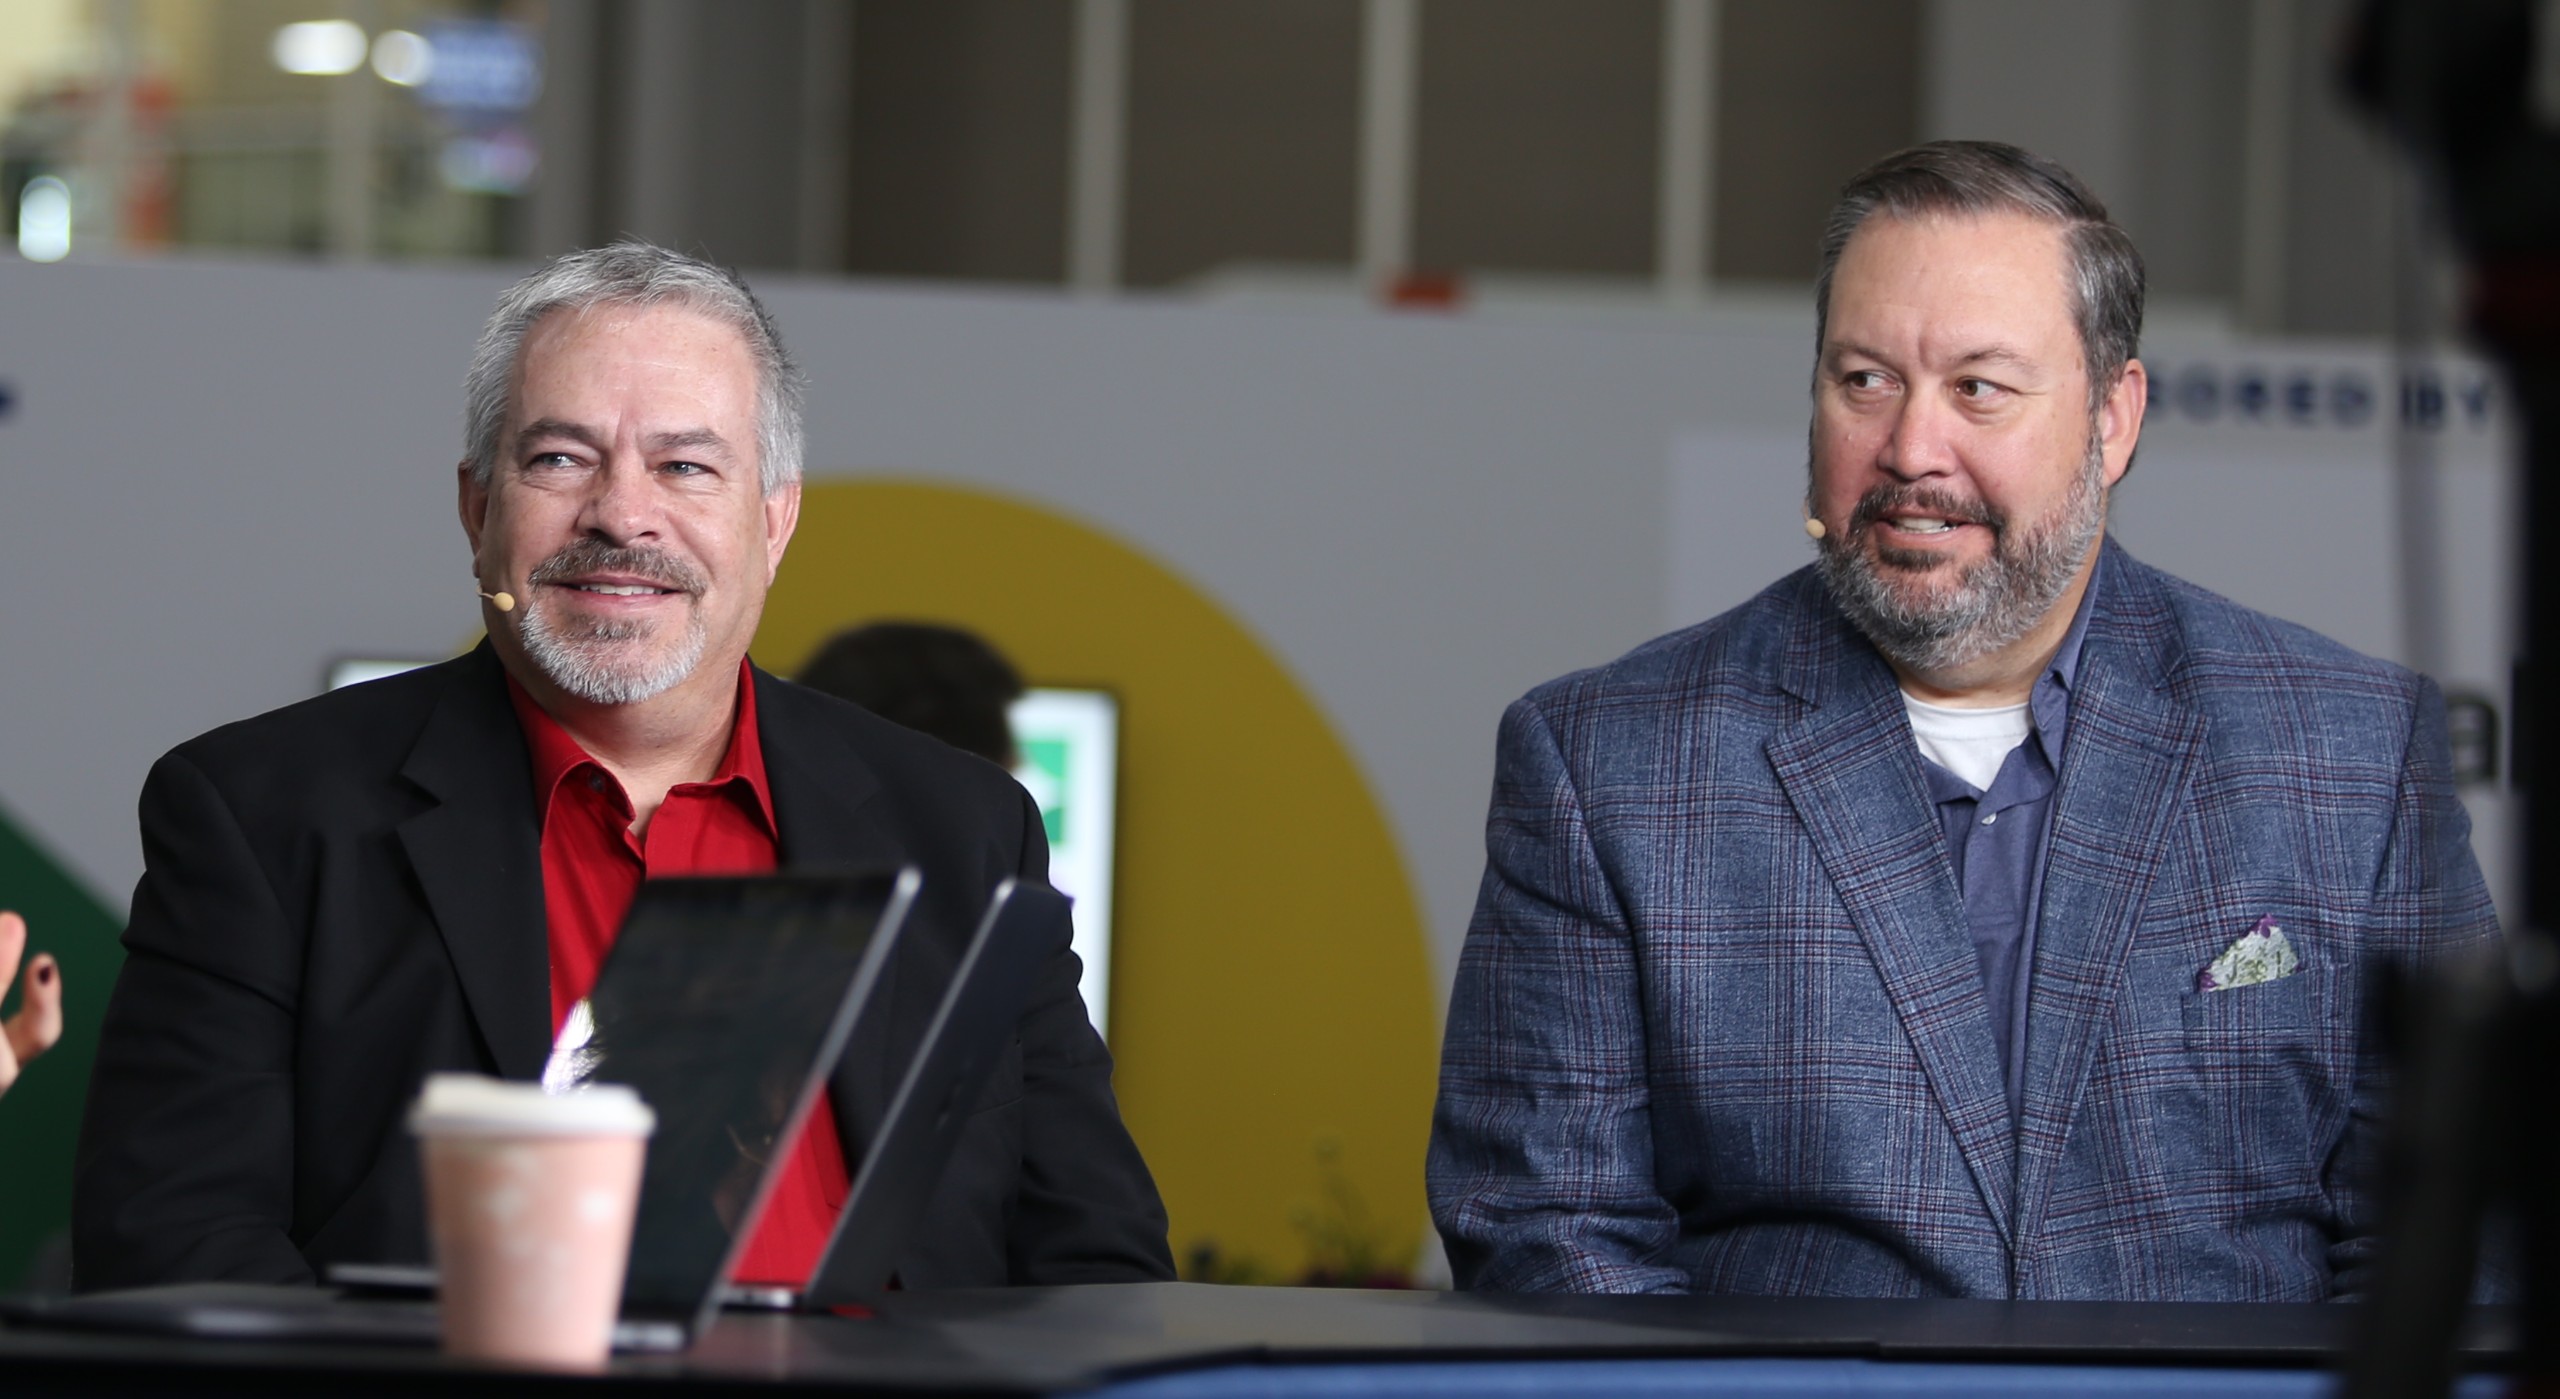
Ce changement se produit chez Mouser Electronics Inc., l'un des plus grands distributeurs de composants électroniques au monde. Après avoir exécuté OpenShift de Red Hat Inc. pour les conteneurs pendant cinq à six ans, la société construit actuellement un cluster de virtualisation OpenShift de production pour déplacer les charges de travail de VMware de Broadcom Inc., selon Ronald Waller (photo, à gauche), ingénieur système chez Mouser.
« Peu importe que nous utilisions des conteneurs ou des machines virtuelles, nous les exécutons sur la même base, ce qui fonctionne vraiment bien », a déclaré Waller. « Parce que nous pouvons gérer ces choses avec les mêmes outils et les mêmes compétences. »
Waller et Jon Owings (à droite), vice-président adjoint des préventes techniques mondiales, des services cloud et de données chez Portworx by Everpure, se sont entretenus avec John Furrier et Rebecca Knight de theCUBE à KubeCon + CloudNativeCon NA, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont expliqué comment la couche de gestion des données permet d'exécuter des machines virtuelles et des conteneurs sur OpenShift. (* Divulgation ci-dessous.)
Une couche de gestion des données pour les VM et les conteneurs
Kubernetes sert déjà de plan de contrôle commun pour les charges de travail d'IA conteneurisées, et l'intégration de machines virtuelles dessus étend cette norme aux applications plus anciennes. Everpure Inc., qui a été rebaptisé Pure Storage Inc. cette année dans le cadre d'un pivot centré sur les données, positionne Portworx comme l'abstraction correspondante pour le stockage.
« Kubernetes fournit ce plan de contrôle omniprésent pour chacun d'entre eux, et c'est ce que les clients nous demandent », a déclaré Owings. « La seule chose qui manquait était la même chose, mais au niveau des données. »
La courbe d'apprentissage pour les administrateurs VMware qui migrent vers Kubernetes est abrupte, et Waller l'a gravi au cours de l'année dernière. Le stockage s'est avéré être la partie la plus facile lorsqu'il a construit le cluster de validation de principe de Mouser, a-t-il expliqué.
« J'ai demandé au responsable du stockage ce dont j'avais besoin, et il m'a remis un identifiant utilisateur et une clé API. Je suis allé sur Portworx Central. J'ai configuré mes spécifications pour l'opérateur et le cluster de stockage, créé mon secret, et boum, Portworx Enterprise a fait tout le reste sur le backend », a déclaré Waller. « Je n'ai même pas eu besoin d'y penser. »
Portworx continue de construire pour ce cas d'utilisation. Il a rendu la gestion des données native à OpenShift en mai et a dévoilé de nouvelles fonctionnalités d'IA et de VM à KubeCon. Pour les équipes qui suivent le chemin de Mouser, Owings voit la sortie d'un hyperviseur existant comme une opportunité de repenser les opérations du deuxième jour sur une couche de gestion de données qui transite à travers les cloud et les distributions Kubernetes.
» Que pouvons-nous changer que nous n'avons pas aimé au cours des 15 dernières années ? … Étions-nous dépendants d'un fournisseur ? Étions-nous dépendants de scripts shell ou de PowerShell ? » Dit les dues. « Nous avons une excellente opportunité de faire quelque chose de nouveau, et Kubernetes dispose de cette API ouverte qui vous permet d'être créatif. »
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE de KubeCon + CloudNativeCon NA :
(* Divulgation : Portworx a sponsorisé ce segment de theCUBE. Ni Portworx ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
