À mesure que les charges de travail de l’intelligence artificielle se tournent vers l’inférence, la bande passante mémoire décide si le matériel génère rapidement des jetons ou reste inactif. D-Matrix Corp. répond avec Raptor, une puce de deuxième génération empilant de la DRAM 3D sous sa logique de calcul.
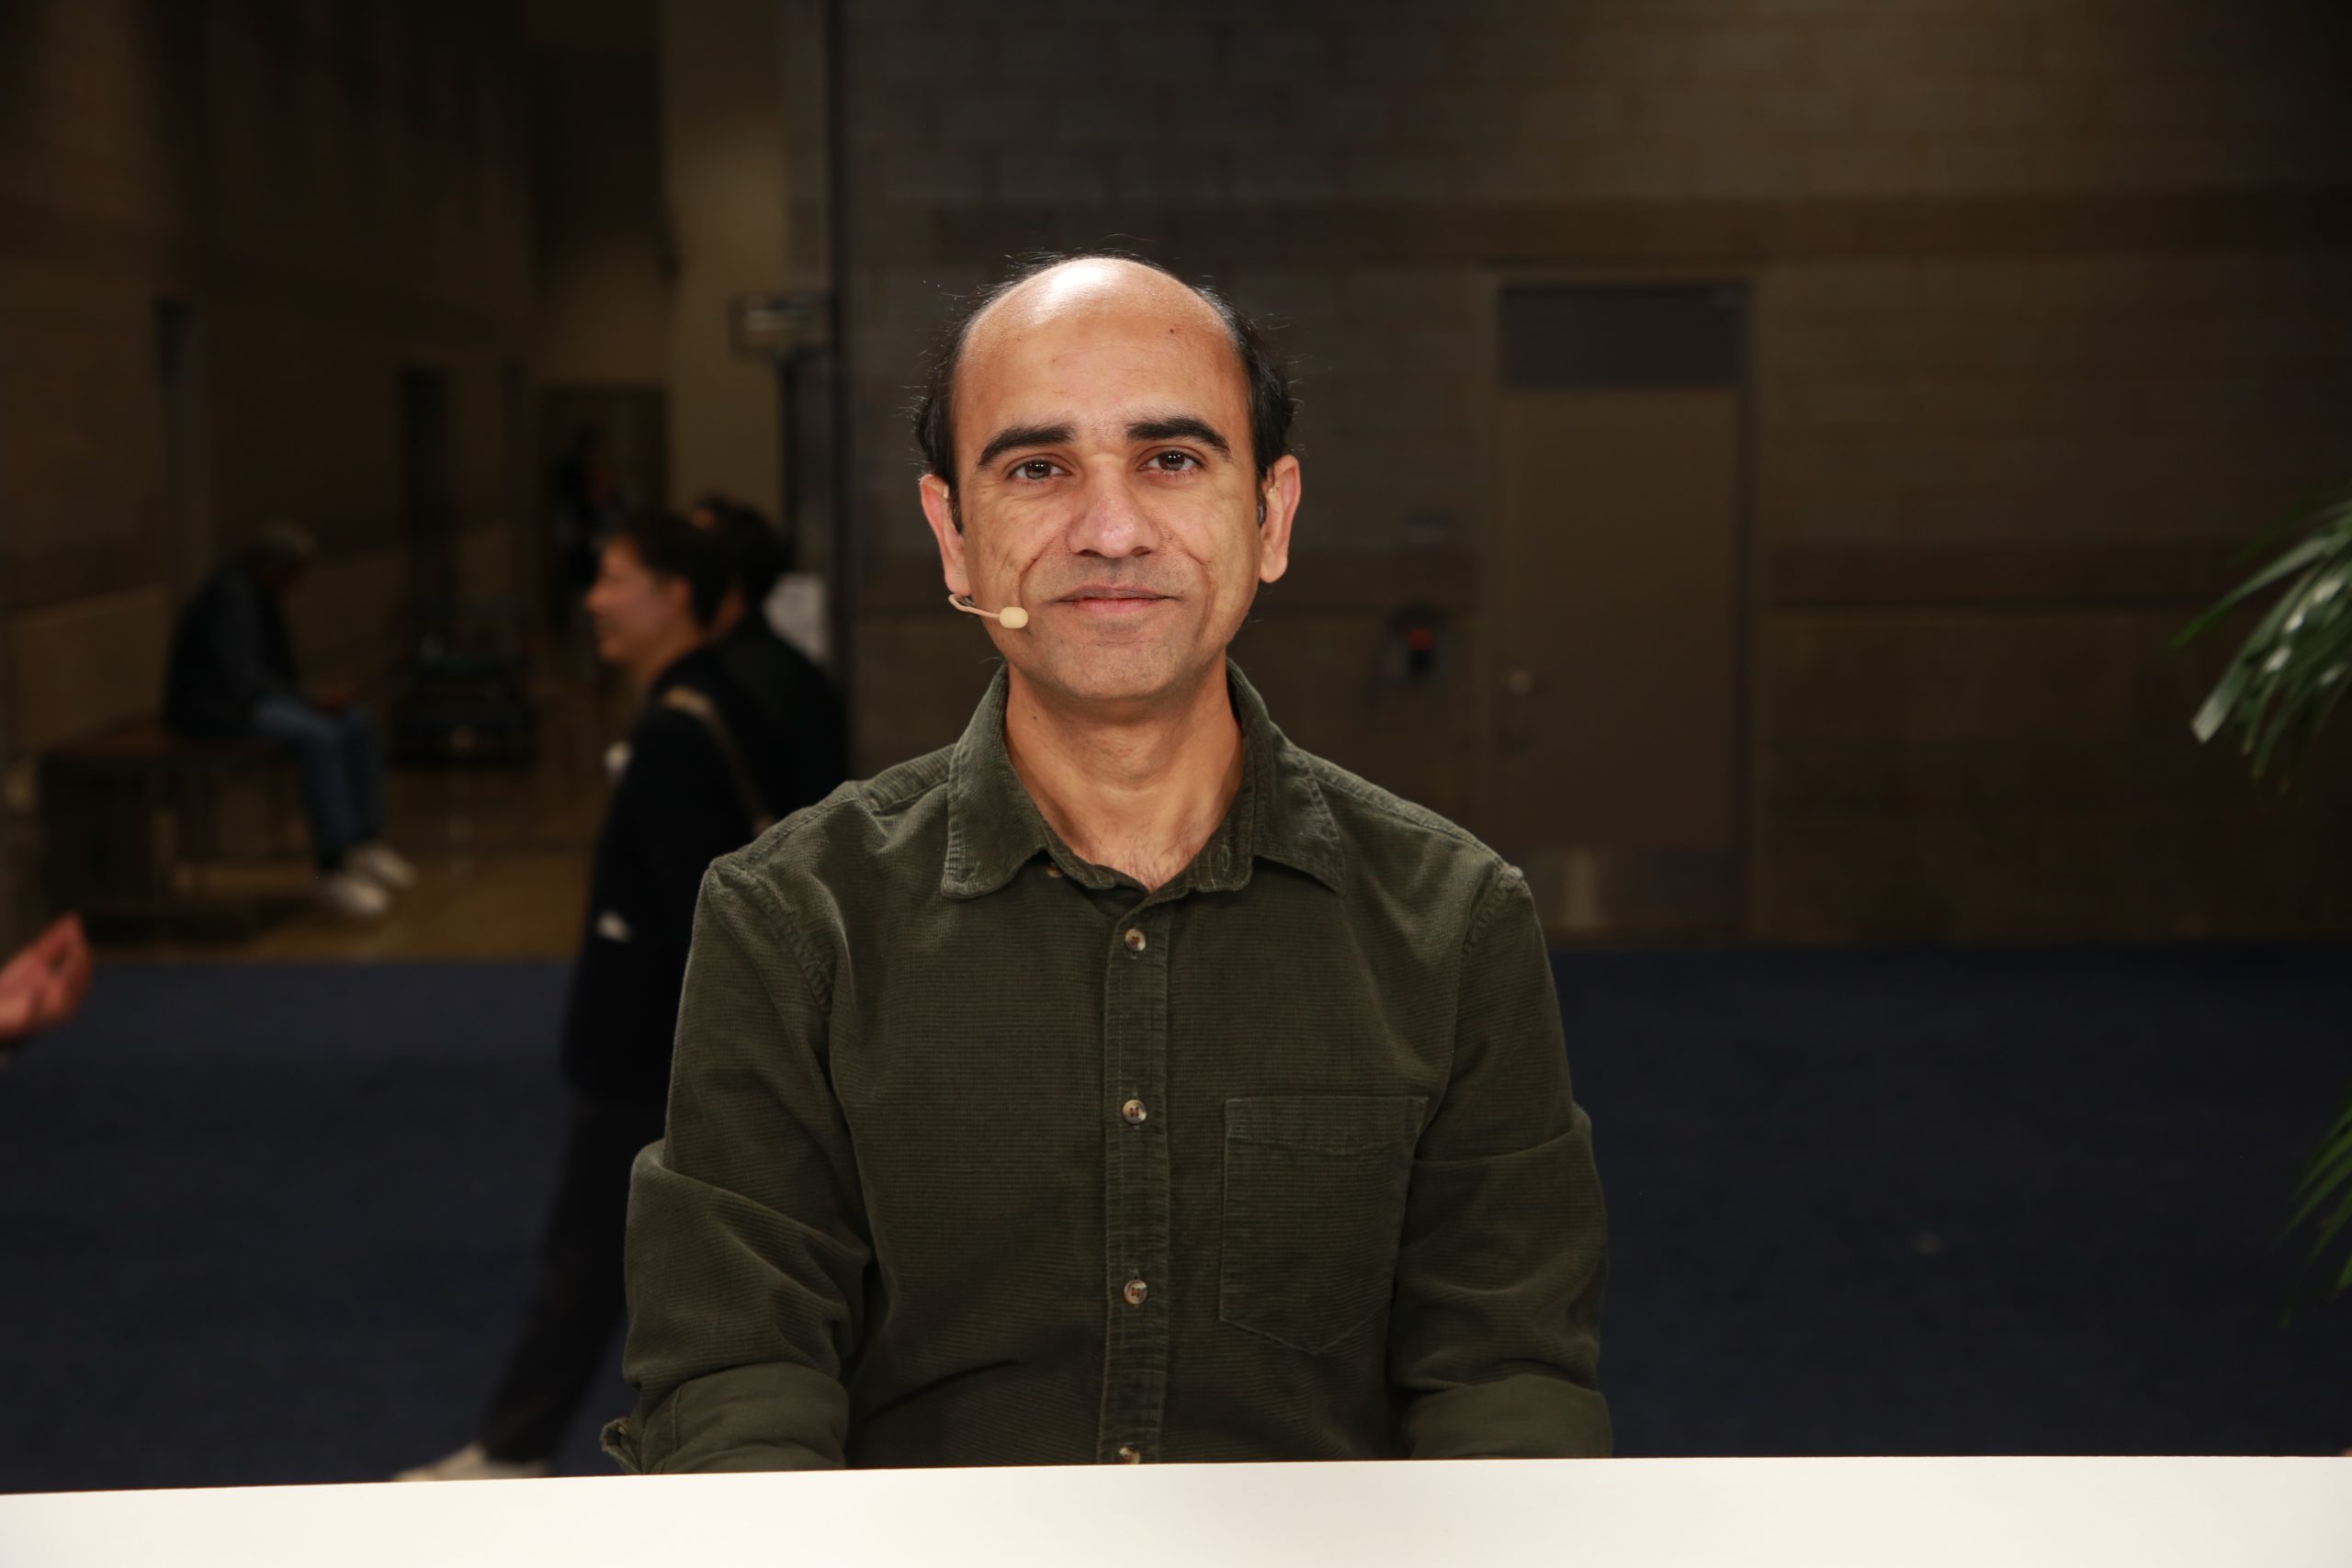
L'infrastructure de l'IA est devenue un jeu de systèmes, et les gagnants combinent mémoire, interconnexion et logiciels dans des conceptions cohérentes, selon Satyam Srivastava (photo), membre de d-Matrix.
« Ce n'est plus un problème de puce. La puce joue un rôle. La bande passante mémoire est un avantage fondamental qui doit être résolu », a déclaré Srivastava. « La prochaine étape est l'efficacité énergétique. La prochaine étape est l'efficacité des interconnexions. La prochaine étape est la cohésion logicielle. »
Srivastava s'est entretenu avec John Furrier de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la puce Raptor de d-Matrix et de sa DRAM 3D empilée, de la bande passante de la mémoire d'inférence et de la transition vers une informatique hétérogène. (* Divulgation ci-dessous.)
Raptor apporte un niveau de mémoire empilée à l'inférence
D-Matrix prouve d'abord chaque technologie risquée sur une puce de test. Jayhawk a prouvé la connectivité die-to-die et Jayhawk II a validé l'informatique numérique en mémoire. L'accélérateur Corsair a combiné les deux et est entré en pleine production plus tôt cette année, a expliqué Srivastava.
« Avance rapide, nous avons la puce Pavehawk, une puce de test, qui prouve la DRAM 3D empilée sous la puce logique, qui sert de technologie de base pour Raptor, qui est notre puce de deuxième génération qui sortira l'année prochaine », a déclaré Srivastava.
L'empilement conserve intacte l'architecture de mémoire distribuée mais déplace les cellules de mémoire sur une couche distincte plutôt que de consommer la zone de la puce logique. Les données parcourent une courte distance et ne traversent jamais un interposeur. Cela place la DRAM 3D à un nouveau niveau entre la SRAM et la mémoire à large bande passante, a déclaré Srivastava.
« Vous obtenez donc une efficacité énergétique 10 fois supérieure à celle du HBM, et une bande passante 10 fois supérieure à celle du HBM, où il se situe entre SRAM et HBM en termes de capacité », a déclaré Srivastava.
L'association d'un serveur basé sur Corsair avec une flotte de GPU Hopper existante peut augmenter l'utilisation d'environ 20 % à 80 %, ce qui signifie plus de jetons par dollar, a noté Srivastava. D-Matrix a également adopté l'infrastructure rackscale NVLink Fusion de Nvidia Corp. pour connecter ses accélérateurs aux usines d'IA de Nvidia.
« Pour nous, cela ouvre la possibilité de participer à un écosystème très établi, l'usine d'IA la plus populaire au monde. Nous avons accès à une conception très renforcée d'un rack MGX », a déclaré Srivastava.
Le partenariat pointe vers une informatique hétérogène, où les logiciels orchestrent les GPU, les CPU et les accélérateurs tels que Raptor comme un seul système, avec le cluster comme unité de calcul, a expliqué Srivastava.
« Alors pensez à une puce, mais cette puce est un cluster entier et elle comporte de nombreuses unités matérielles différentes », a déclaré Srivastava. « Certains sont des GPU, d'autres des CPU, d'autres des accélérateurs ASIC, et vous pouvez utiliser celui de votre choix pour répondre au mieux aux besoins de la charge de travail. »
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : NYSE Wired a sponsorisé ce segment de theCUBE. Ni NYSE Wired ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
