Les entreprises qui font passer l'IA du stade pilote à la production apprennent que les données, et non les GPU, sont la partie la plus difficile, et que les formats de table ouverte tels qu'Apache Iceberg font partie de la réponse. La demande en infrastructures d’IA montre peu de signes de ralentissement, mais une grande partie des informations dont les entreprises ont besoin sont encore dispersées, non gouvernées et hors de portée.
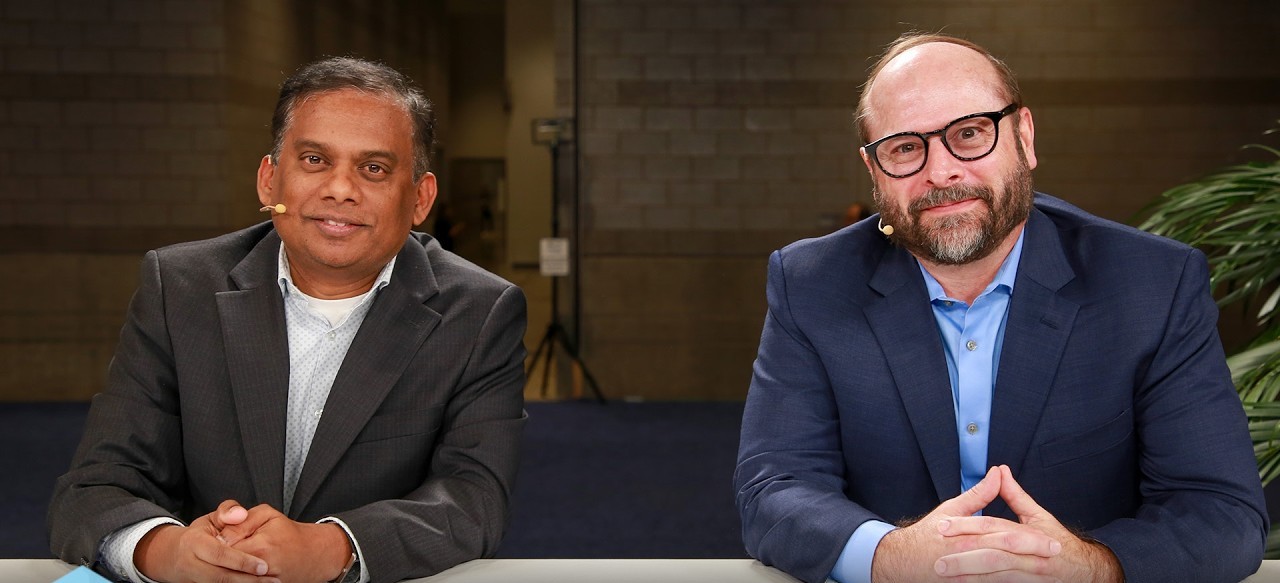
Cette pression transforme le stockage en une couche active qui classe, gouverne et transmet les données aux modèles. Les fichiers non structurés tels que les journaux et les images médicales contiennent des renseignements que l'IA peut désormais extraire, selon Arun Prasad Raman (photo, à gauche), vice-président du cloud hybride et de l'infrastructure IA chez Hitachi Vantara Corp.
« Le stockage ne consiste pas simplement à stocker des données », a déclaré Raman. « Vous devez apporter plus d'intelligence de manière native plutôt que de déplacer les données vers une autre réplication et de les ramener pour, par exemple, l'indexation. S'il peut le faire de manière native, c'est là que réside la valeur ajoutée. »
Raman et Jeff Lundberg (à droite), responsable principal des produits et des solutions chez Hitachi Vantara, se sont entretenus avec John Furrier et Gemma Allen de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de l'écart entre le pilote et la production de l'IA, d'Apache Iceberg et de la manière dont Hitachi Vantara ajoute de l'intelligence au stockage. (* Divulgation ci-dessous.)
Apache Iceberg et la poussée en faveur du stockage intelligent
Les architectures de référence pour les usines d’IA et les plateformes de données sont largement établies. La plupart des projets échouent parce que les données sont réparties entre des systèmes sur site, des applications logicielles en tant que service et le cloud, tandis que le contrôle d'accès, la gouvernance et l'évolution des réglementations ajoutent des frictions, selon Lundberg. Hitachi Vantara répond avec des solutions spécifiques à l'industrie, construites sur sa pile Hitachi iQ et l'expérience de ses entreprises sœurs dans le domaine ferroviaire et énergétique, a-t-il expliqué.
« Il s'agit davantage du résultat que de la technologie que nous essayons de mettre en place », a déclaré Lundberg. « C'est un moyen de vous amener à la solution à laquelle vous essayez d'arriver. »
Une grande partie de ce travail se déroule désormais dans le stockage. La semaine dernière, Hitachi Vantara a étendu sa plate-forme VSP One avec de nouvelles capacités de stockage d'objets et de data lakehouse. Un service de son magasin d'objets signale les fichiers contenant des informations personnelles, telles que les numéros de sécurité sociale. Les data scientists peuvent alors conserver ces données en dehors de modèles spécifiques ou bloquer leur réplication vers un autre pays, a expliqué Raman.
« C'est l'intelligence que nous ajoutons au stockage lui-même », a déclaré Raman. « C'est donc là que l'évolution du stockage le rend plus intelligent. »
Les analyses suivent la même logique. Les métadonnées du scanner peuvent être stockées au format Apache Iceberg sur le magasin d'objets de l'entreprise et interrogées directement. Une application pourrait répertorier chaque analyse abdominale de l’année écoulée sans extraction, transformation et chargement distincts, ni processus ETL ou base de données, a noté Raman.
« Qu'il s'agisse d'une sauvegarde ou qu'il date de 10 ans, il contient toujours des informations », a déclaré Raman. « Tant qu'il transporte de l'intelligence, il devient important pour l'IA. »
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : Hitachi Vantara Corp. a sponsorisé ce segment de theCUBE. Ni Hitachi Vantara Corp. ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
