Les usines d’IA dépassent les centres de données traditionnels à mesure que les modèles s’agrandissent et que l’inférence distribuée passe du concept au déploiement. L'infrastructure derrière ces modèles doit désormais s'étendre sur les racks, les sites et même les poches d'alimentation dispersées.
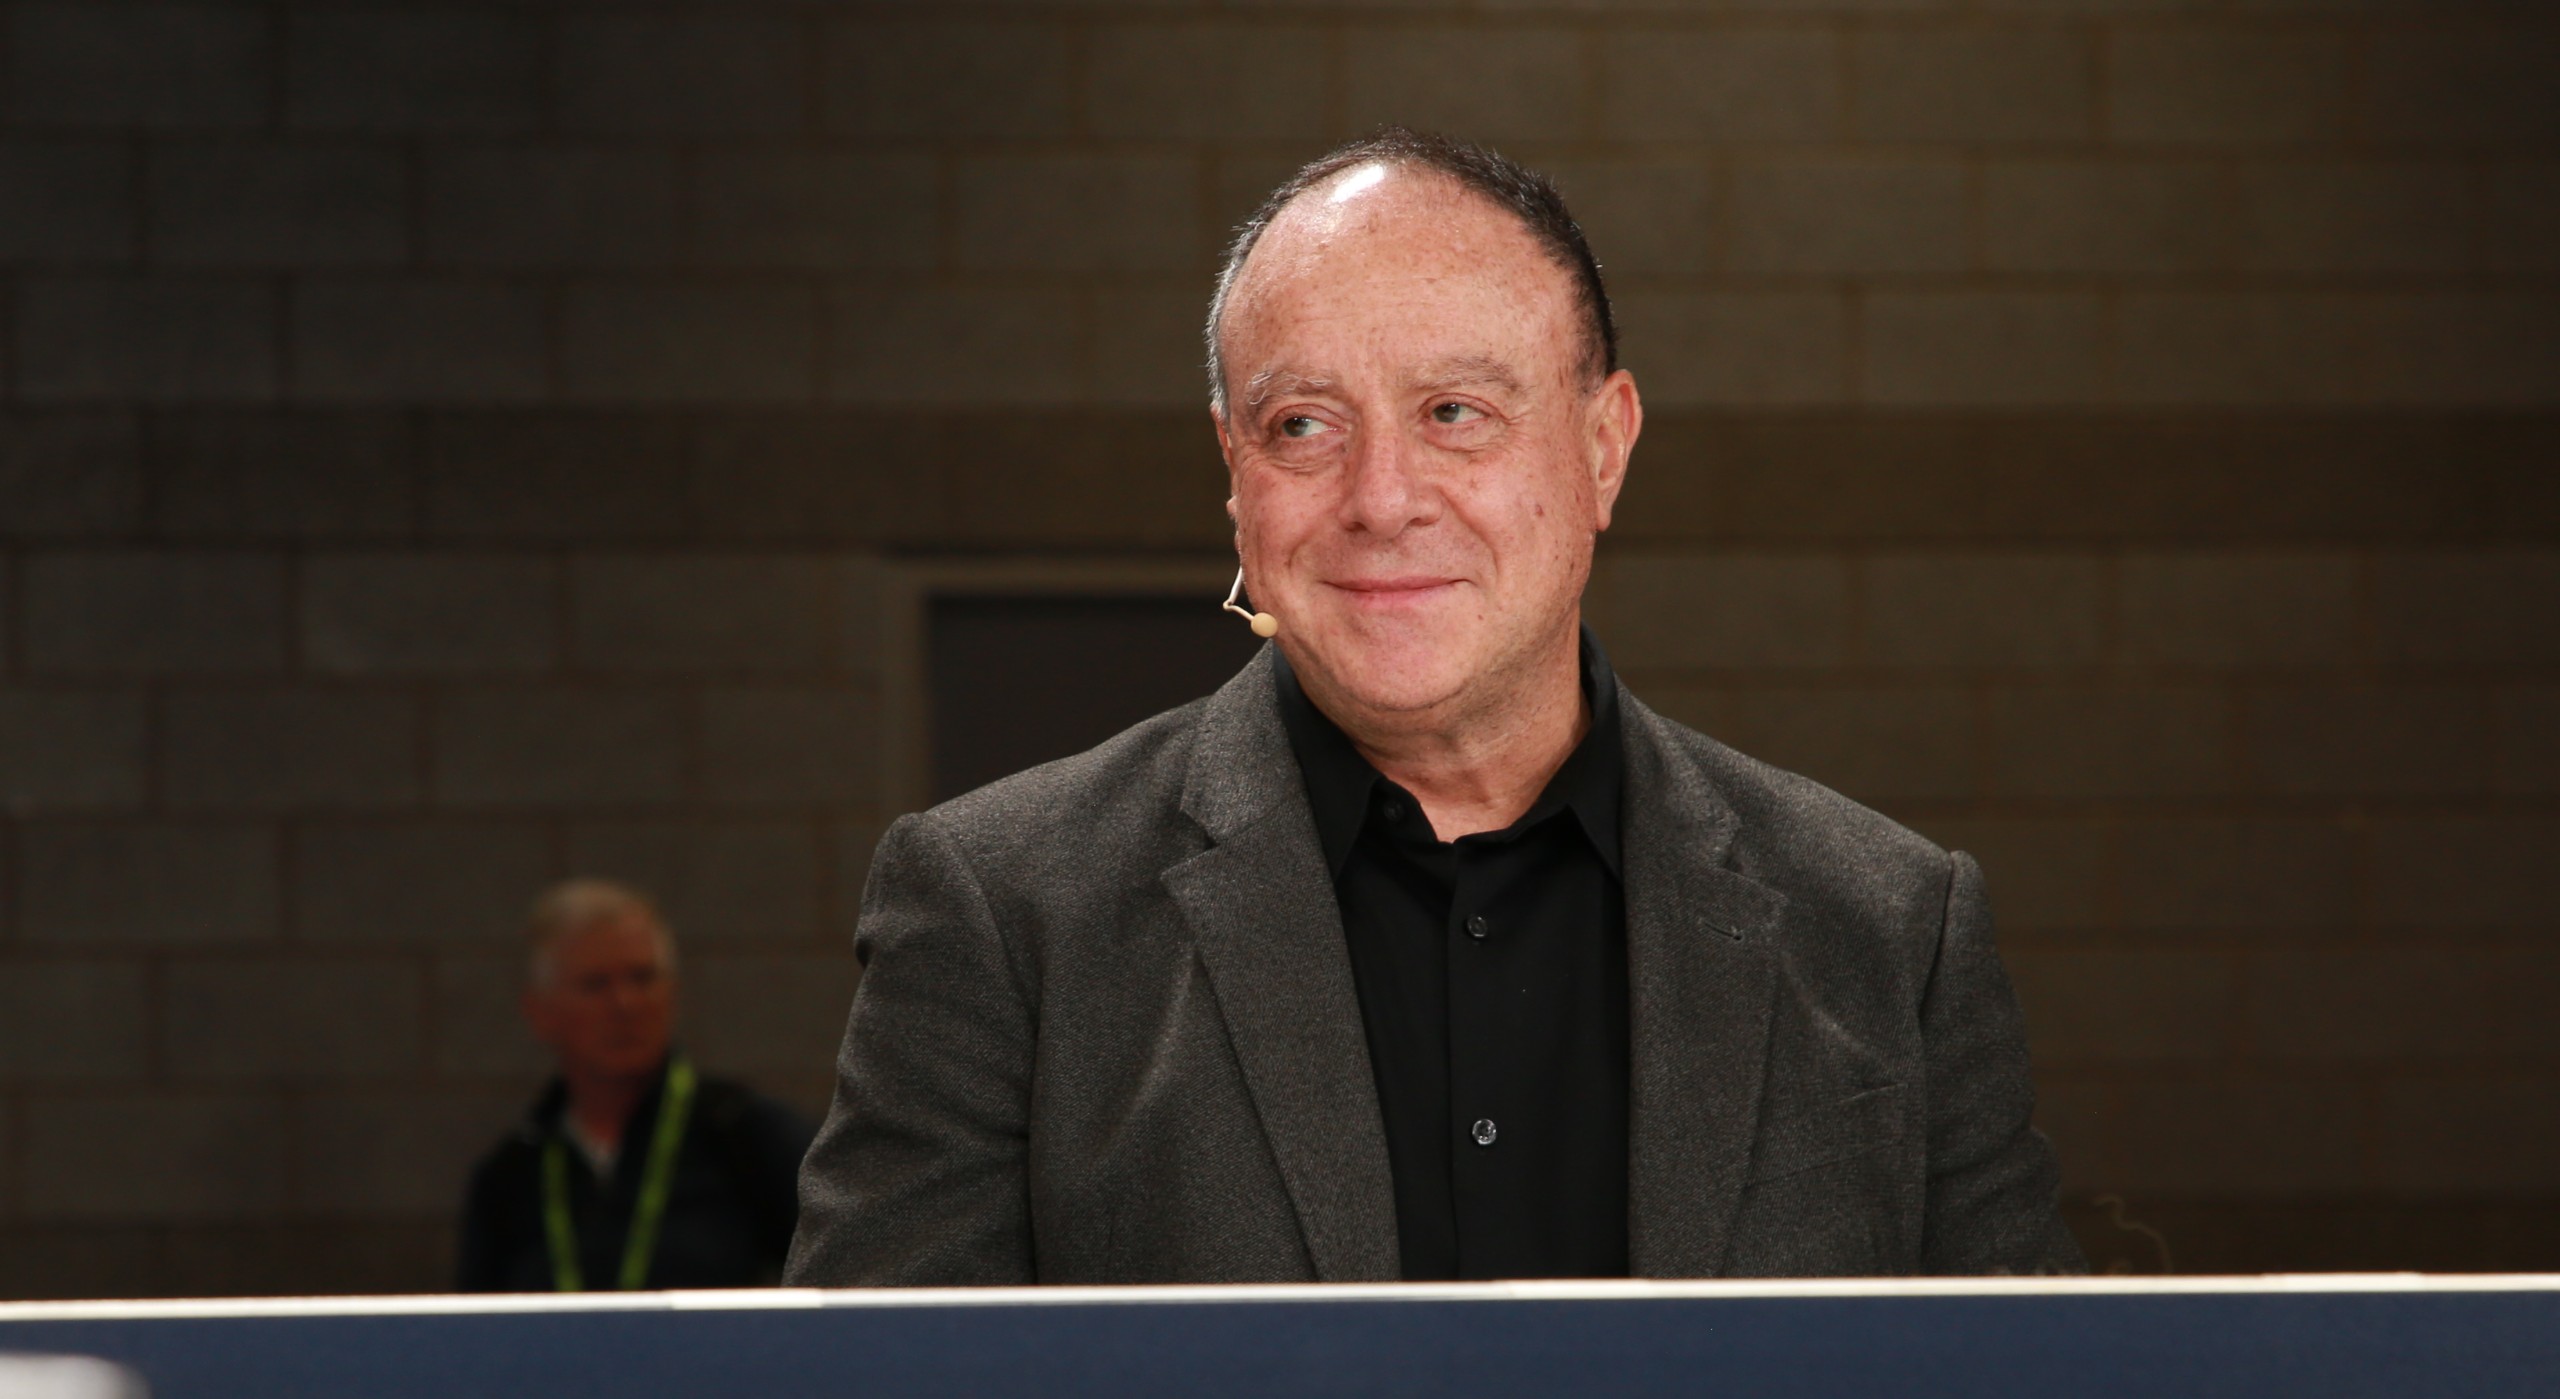
Dell Technologies Inc. parie que la réponse réside dans la construction de systèmes complets plutôt que de composants, depuis la gestion à l'échelle du rack jusqu'aux conceptions entièrement refroidies par liquide. La taille des clusters d'IA modernes éclipse tout ce que le calcul haute performance a pu gérer auparavant, selon Ihab Tarazi (photo), vice-président senior et directeur de la technologie pour l'IA, le calcul et les réseaux chez Dell.
« La différence avec l'IA est que l'échelle est énorme. Des dizaines de milliers, des centaines de milliers de GPU qui sont tous sur une seule structure. Il peut s'agir de plusieurs clusters, mais ils finissent par ne former qu'une seule structure », a déclaré Tarazi.
Tarazi s'est entretenu avec John Furrier et Rebecca Knight de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté du système de réseau Dell 100 % refroidi par liquide, de l'inférence distribuée et de la transformation de l'énergie bloquée en capacité d'IA. (* Divulgation ci-dessous.)
Le refroidissement liquide ouvre la voie à l’inférence distribuée
La dernière initiative de Dell amène le refroidissement liquide au-delà du GPU. La société expédie ce qu'elle appelle le premier système réseau 100 % refroidi par liquide, avec des commutateurs, des optiques et des câbles prétestés dans son usine et livrés sous forme de rack unique, a expliqué Tarazi.
« Le fait qu'il soit pré-testé en tant que système à rack unique signifie qu'au lieu de devoir assembler des centaines de pièces sur site et de prendre peut-être deux ou trois semaines pour trouver les bugs, tout arrive, vous l'installez (et) nous le montons en quelques heures », a déclaré Tarazi.
Le lancement du réseau fait suite aux débuts de Dell en matière de stockage refroidi par liquide pour les racks AI. Le calcul, la mise en réseau et le stockage partagent désormais les mêmes spécifications de refroidissement et d’alimentation. Cela est important alors que les opérateurs conçoivent de nouvelles installations autour du refroidissement par eau, selon Tarazi.
« Au lieu de construire deux centres de données – un pour le GPU, un pour le réseau – pouvoir en créer un représente pour nous une réduction considérable du temps et des coûts », a déclaré Tarazi.
Le logiciel est le prochain levier de l’inférence distribuée. Les clients veulent un plan de contrôle unique capable de fonctionner sur différents GPU et CPU et de relier jusqu'à 1 000 petits sites disposant chacun d'une certaine énergie disponible, a noté Tarazi. Cette approche transforme l’énergie inutilisée en capacité d’IA pour les entreprises qui ne peuvent pas construire rapidement un énorme centre de données.
« Vous serez surpris de ce que signifie la disponibilité de l'électricité », a déclaré Tarazi. « Cela ne signifie pas seulement que vous avez de l'électricité dans votre magasin. Cela pourrait également signifier la sortie de méthane – toutes les sources d'énergie possibles. Les gens reviennent en arrière et se demandent : « Comment puis-je exploiter cette puissance pour le calcul et permettre l'inférence de manière distribuée ? »
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : Dell a sponsorisé ce segment de theCUBE. Ni Dell ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
