La mise en commun de mémoire est en passe de devenir l’un des outils les plus performants en matière d’économie d’inférence de l’IA, les entreprises s’efforçant d’extraire plus de rendement de chaque unité de traitement graphique.
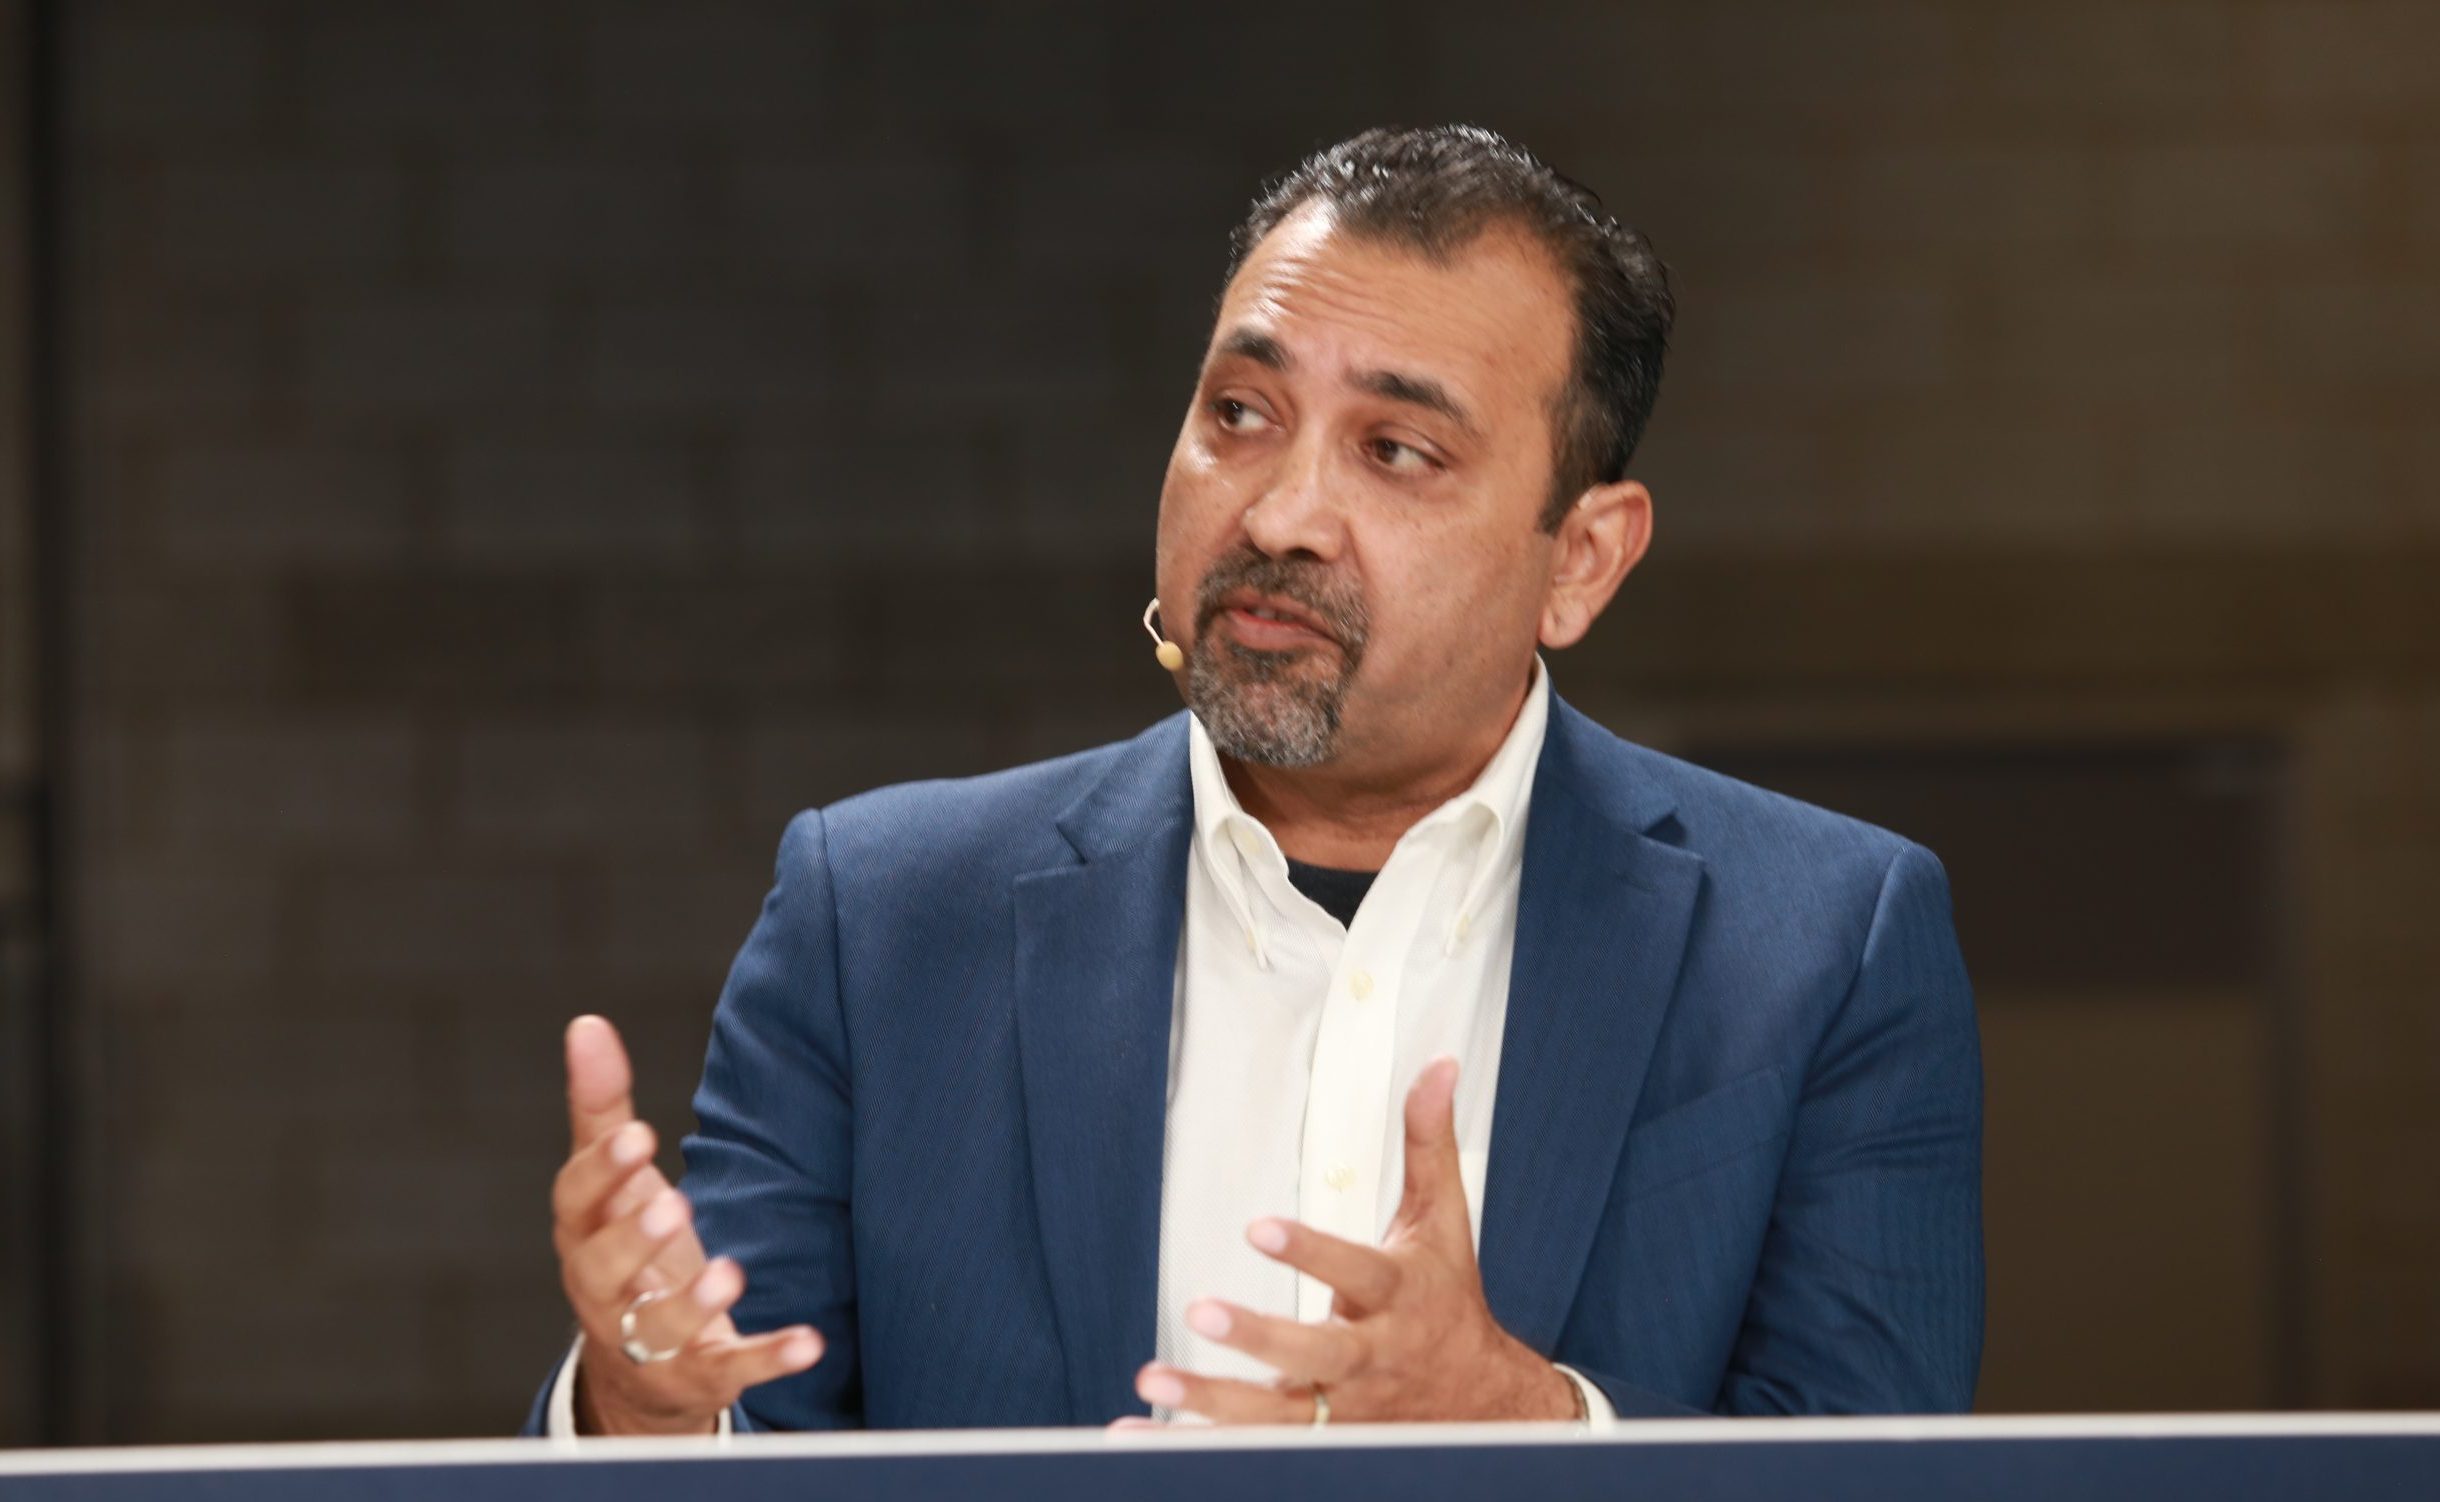
La plupart des serveurs IA sont toujours livrés avec un rapport GPU/mémoire fixe qui dure toute la durée de vie de la machine. Mais cela ne convient pas puisque personne ne sait quel modèle ils déploieront dans six mois, selon Sumit Puri (photo), co-fondateur et directeur technique de Liqid Inc.
« Notre technologie fondamentale de base consiste à regrouper et à partager les ressources les plus critiques du centre de données, qui sont désormais le GPU et la mémoire », a déclaré Puri. « Plutôt que de déployer ces éléments de manière statique à l'intérieur d'un serveur, notre vision est simple. Plaçons des pools de ressources dans le rack, les GPU et la mémoire, et attribuons-les dynamiquement à tout serveur qui en a besoin en fonction du modèle ou de la charge de travail que nous cherchons à déployer. «
Puri s'est entretenu avec John Furrier et Gemma Allen de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la mise en commun des GPU et de la mémoire, de la tokenomique de l'inférence de l'IA et du Liquid as a Service. (* Divulgation ci-dessous.)
La mise en pool de mémoire répond au test tokenomics
Liqid mesure les gains en tokenomics, les critères étant les jetons par seconde, les jetons par watt et, surtout, les jetons par dollar. L’offre est un autre point de pression dans le développement de l’infrastructure d’IA, la mémoire étant l’un de ses composants les plus contraints. Mais fournir uniquement la mémoire dont chaque application a besoin va encore plus loin, a expliqué Puri.
« Fournir chain est un massif contrainte pour tous de nous – mémoire être un géant massif contraint chose« , a-t-il déclaré. « Si nous pouvons faire des choses comme mettre en commun la mémoire, partager la mémoire, fournir de manière optimale de la mémoire au serveur dans la quantité de mémoire requise par l'application, nous pouvons résoudre directement certains de ces problèmes de chaîne d'approvisionnement. »
Liqid élargit également la manière dont les clients achètent le pool de mémoire. Lors du SC26, la société a annoncé Liqid as a Service, une offre entièrement gérée à locataire unique, et s'oriente vers des appareils préconfigurés. Le pari est que la plupart des entreprises déploieront des modèles plutôt que de les construire et auront donc besoin de leurs propres capacités, selon Puri.
« Le monde est passé à une consommation illimitée de minutes, et c'est vers cela que nous pensons que les jetons se dirigent », a déclaré Puri. « Tout le monde va posséder sa propre machine à jetons afin de pouvoir consommer ces jetons à volonté. »
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : Liqid a sponsorisé ce segment de theCUBE. Ni Liqid ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
