Les agents d’IA changent la façon dont les entreprises créent, déplacent et gèrent les informations, et l’observabilité des données devient une condition préalable plutôt qu’un avantage. Les modèles retiennent l’essentiel de l’attention, mais les données qu’ils contiennent déterminent s’ils résistent à la production.
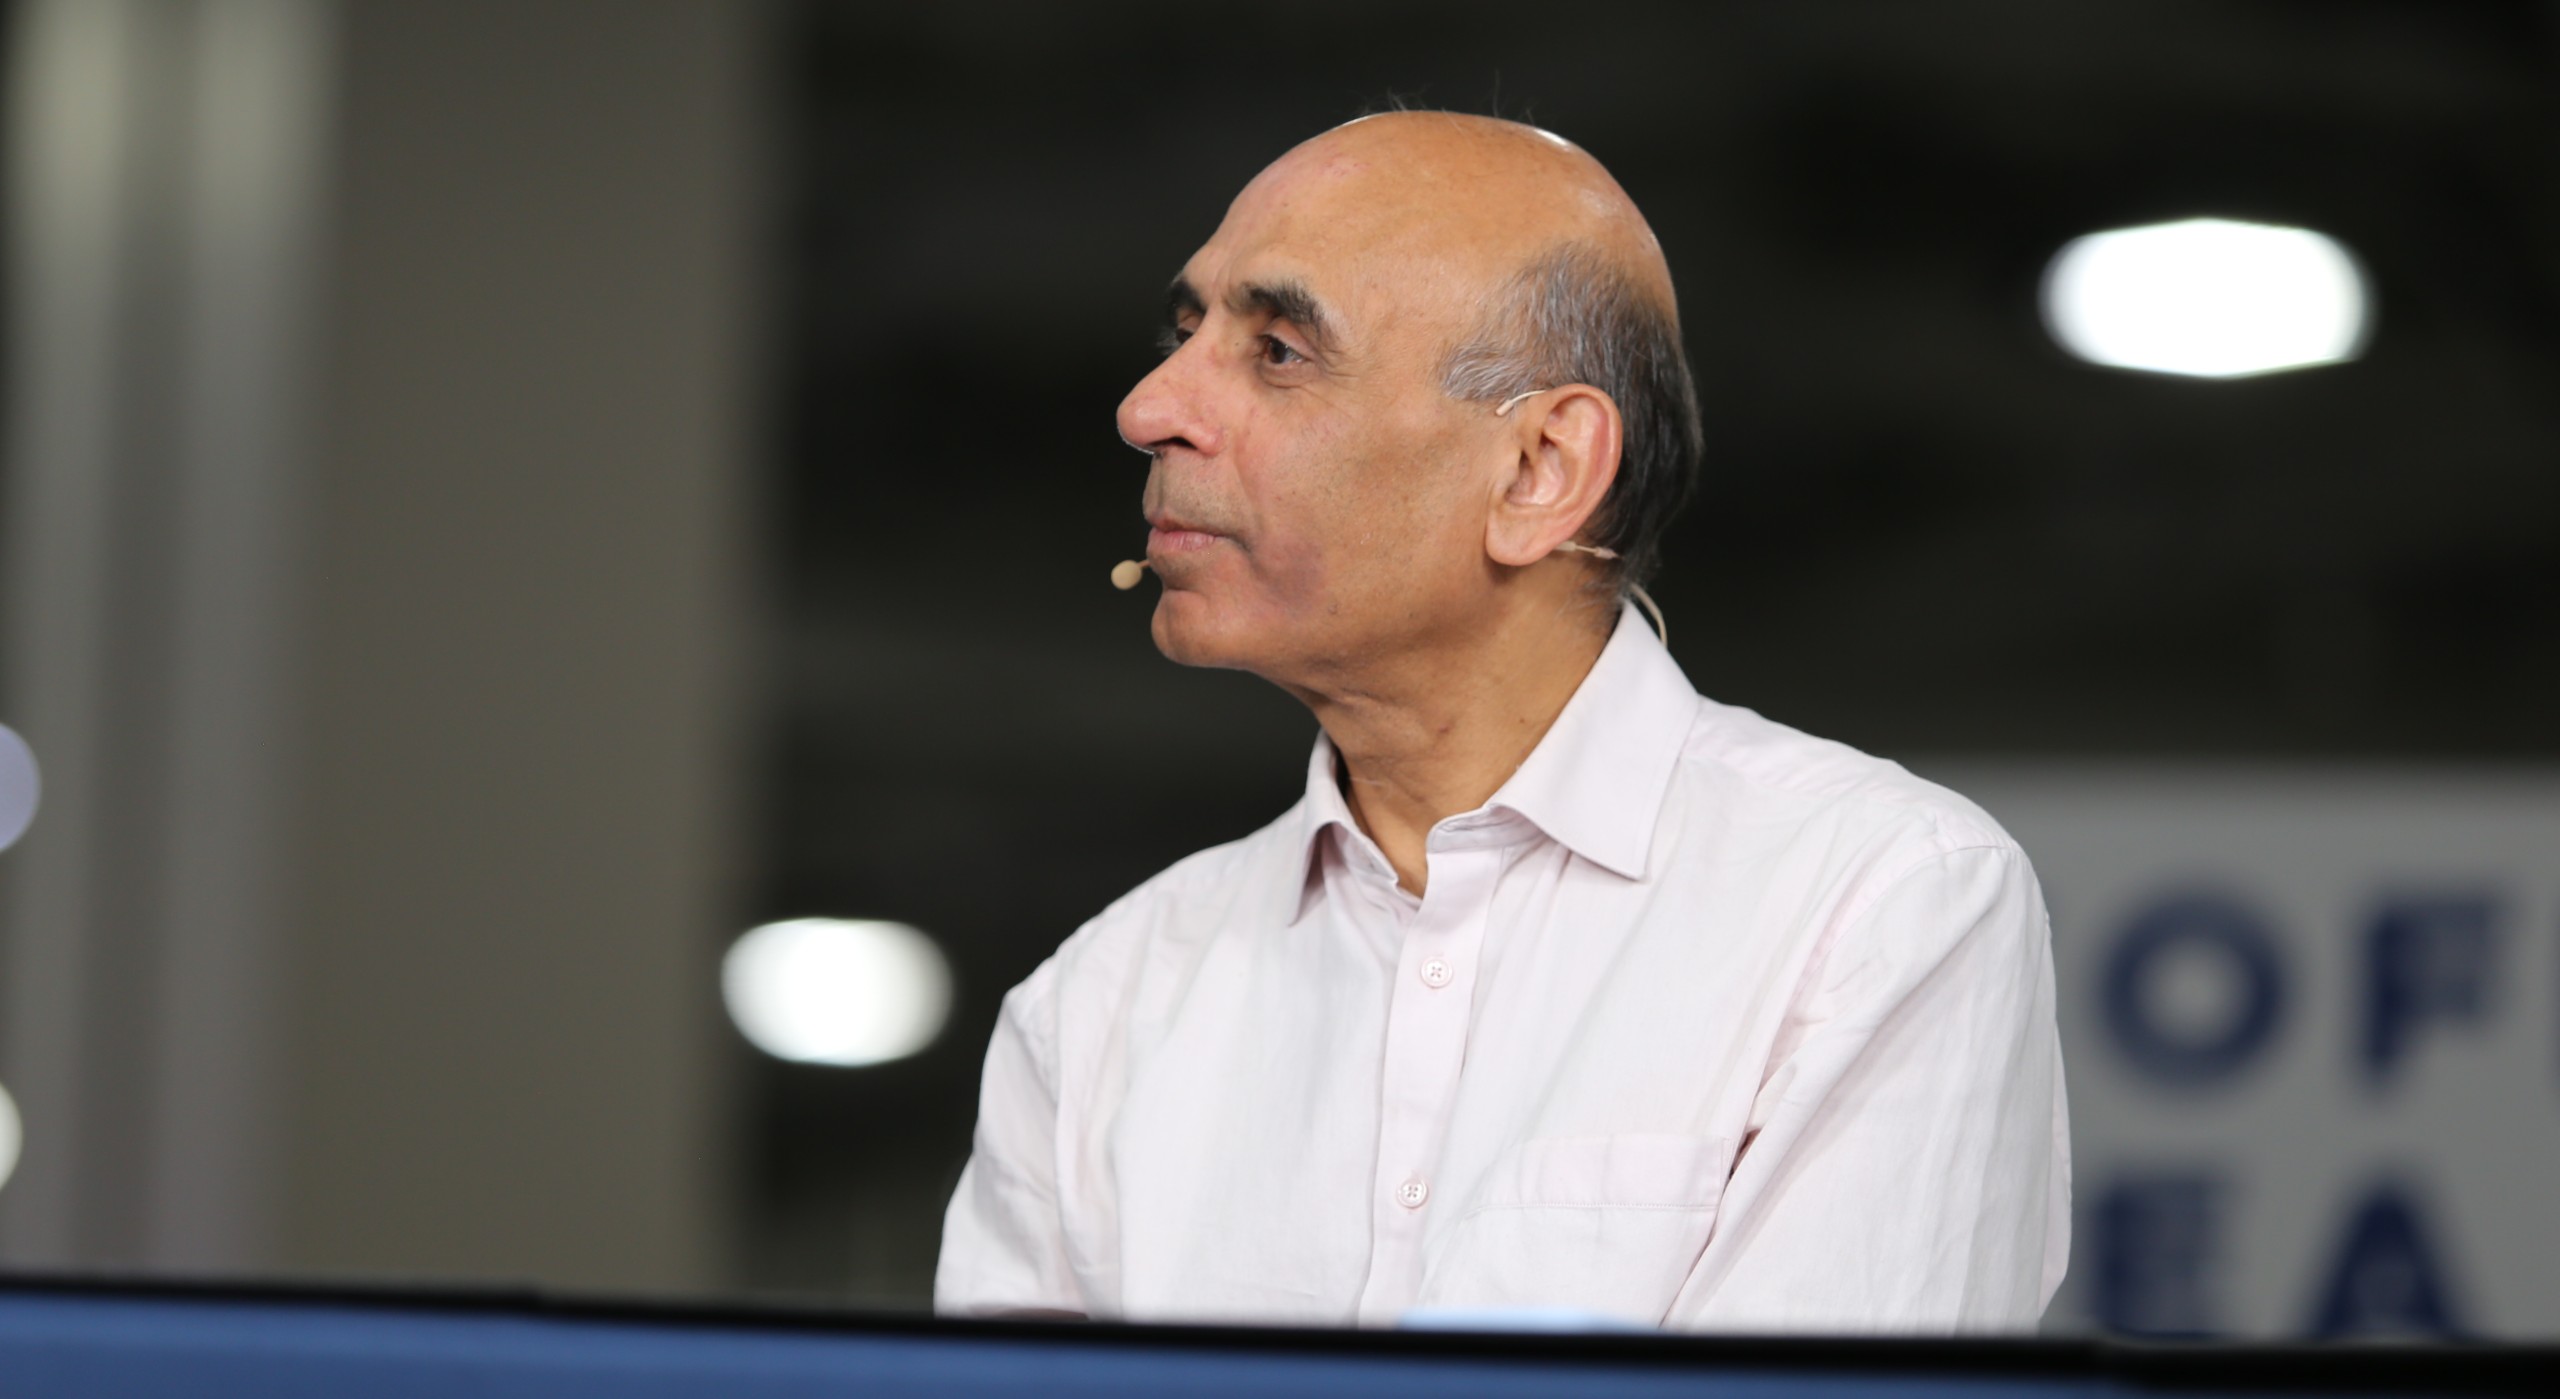
Cette pression atteint désormais la communauté cloud native, où les organisateurs de la KubeCon ont ajouté cette année une piste dédiée à l'inférence et à l'agentivité de l'IA. L'industrie est passée des chatbots à la récupération, au réglage fin et aux agents, mais chaque vague repose sur les mêmes bases, selon Sanjeev Mohan (photo), directeur de SanjMo, une société de conseil en données et en IA, et auteur de « Designing the AI-Driven Data Foundations ».
« L'IA ne peut réussir que si elle repose sur des bases solides », a déclaré Mohan. « Vous n'avez aucune observabilité ni transparence. Peu importe ce que vous faites par-dessus, cela ne réussira pas. »
Mohan s'est entretenu avec John Furrier et Rebecca Knight de theCUBE Research à KubeCon + CloudNativeCon NA, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la deuxième journée de couverture de theCUBE lors de l'événement. (* Divulgation ci-dessous.)
Pourquoi les agents d'IA exigent l'observabilité des données au moment de l'exécution
Pendant des décennies, les données ont été créées une fois dans un système opérationnel, puis acheminées via des pipelines fragiles pour être extraites, transformées, cataloguées et préparées. Ce modèle fonctionne lorsque les humains consomment des rapports par lots, a expliqué Mohan. Des milliers d’agents changent les calculs.
« Ils n'attendront pas la fin de ce pipeline. Ils veulent accéder directement à la base de données », a déclaré Mohan.
Les agents font également quelque chose qu’aucun logiciel antérieur ne faisait. Ils créent des bases de données éphémères, copient des données et testent différentes chaînes de pensée avant de choisir une action, selon Mohan. Un agent examinant une demande de prêt peut interroger les registres du recensement et les réseaux sociaux avant de la rejeter, ce qui soulève la question de savoir comment cette décision est vérifiée.
« La gouvernance devient vraiment importante, et ce n'est pas comme la gouvernance du passé où vous gouverniez vos données et exécutiez ensuite un tableau de bord déterministe du rapport du CFO », a déclaré Mohan.
Cela fait que l’observabilité des données fait partie de l’architecture elle-même, et non une réflexion secondaire sur un entrepôt. Le livre de Mohan, publié en juin 2026 par John Wiley & Sons Inc., examine comment les agents d'IA, en tant que consommateurs de données de premier ordre, redéfinissent les principes architecturaux en vigueur depuis des décennies. Les futures plates-formes devront mélanger les données structurées et non structurées dans un seul système convergé, a-t-il noté.
« Vous devez sauver l'état et vous devez créer le contexte, et ce contexte est construit au moment de l'exécution », a déclaré Mohan. « Le contexte d'une même tâche pourrait être très différent pour nous trois. Nous verrons donc de nouveaux types de bases de données. »
Restez à l'écoute pour l'interview vidéo complète, qui fait partie de la couverture de SiliconANGLE et theCUBE de KubeCon + CloudNativeCon NA.
(* Divulgation : TheCUBE est un partenaire média payant pour KubeCon + CloudNativeCon NA. Les sponsors de la couverture de l'événement theCUBE n'ont pas de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
