Les services de déploiement deviennent le véritable champ de bataille en matière d’infrastructure d’IA, alors que les acheteurs découvrent que l’expédition du matériel ne représente que la moitié du travail. Avec un approvisionnement serré en GPU et des cycles de rafraîchissement qui s'accélèrent, les néoclouds et les entreprises jugent les fournisseurs sur la rapidité avec laquelle une usine d'IA est réellement mise en service.
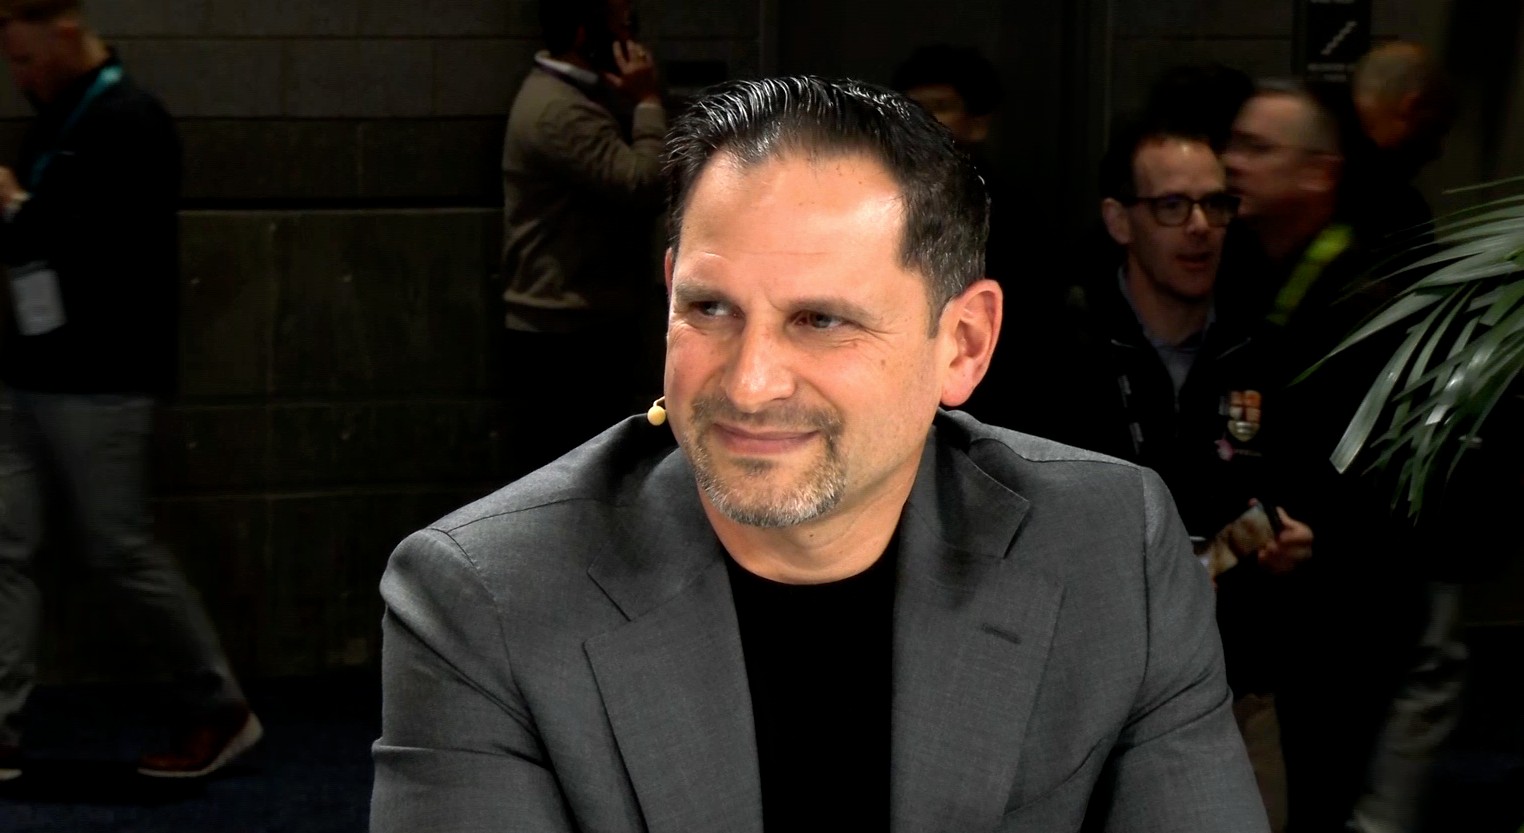
Les fabricants de serveurs qui étaient autrefois en concurrence en termes de délais de mise sur le marché sont désormais mesurés en termes de délais de production. Super Micro Computer Inc., qui a déclaré un carnet de commandes de 60 milliards de dollars en juillet, a étendu son modèle de serveur pour couvrir des centres de données entiers et fait passer la vitesse avant le nombre de GPU. Les Neoclouds veulent que les usines fonctionnent rapidement, tandis que les entreprises considèrent désormais l'inférence et l'IA agentique comme étant là pour rester, selon Matthew Thauberger (photo), directeur des revenus de Supermicro.
« Il ne suffit pas de livrer aux clients. Ils veulent que ce soit en ligne le plus rapidement possible. Le temps, c'est de l'argent », a déclaré Thauberger.
Thauberger s'est entretenu avec John Furrier et Gemma Allen de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont expliqué comment les services de déploiement accélèrent la mise en ligne, comment les mises à niveau du refroidissement liquide aident les anciennes installations à adopter des racks d'IA modernes et pourquoi un guichet unique élimine le jeu des reproches. (* Divulgation ci-dessous.)
Services de déploiement et course au temps pour la mise en ligne
Les clients comptent sur les fournisseurs pour bien plus que des boîtes. Les services d'allocation et de déploiement sont les deux plus grandes demandes entendues par Supermicro, et ses équipes de service mettent en place les systèmes, exécutent les charges de travail des clients et ne les transmettent qu'une fois que tout est opérationnel, a expliqué Thauberger.
« Nous savons que nous sommes dans un environnement contraint. Il n'y a pas de secret là-dessus. Les clients demandent donc essentiellement à Supermicro à quelle vitesse vous pouvez obtenir une allocation, à quelle vitesse vous pouvez la mettre en ligne et à quelle vitesse vous pouvez envoyer des personnes sur place pour les déployer », a déclaré Thauberger.
Les installations plus anciennes constituent un autre obstacle. Beaucoup n'ont pas été conçus pour le refroidissement liquide et la densité de puissance des racks AI modernes, c'est pourquoi Supermicro propose des options de mise à niveau telles que des side-cars et des unités de distribution de liquide de refroidissement en rangée, selon Thauberger. La société a également ajouté des racks IA pré-assemblés à sa gamme de composants pour raccourcir les installations.
« Nous disposons de la plus grande capacité de refroidissement liquide basée en Californie. Nous sommes une entreprise basée aux États-Unis, et la possibilité pour nous d'avoir autant de capacité de refroidissement liquide qu'aux États-Unis nous permet de nous déployer rapidement dans ces usines d'IA aux États-Unis », a déclaré Thauberger.
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour SC26. Les sponsors de la couverture de l'événement theCUBE n'ont pas de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
