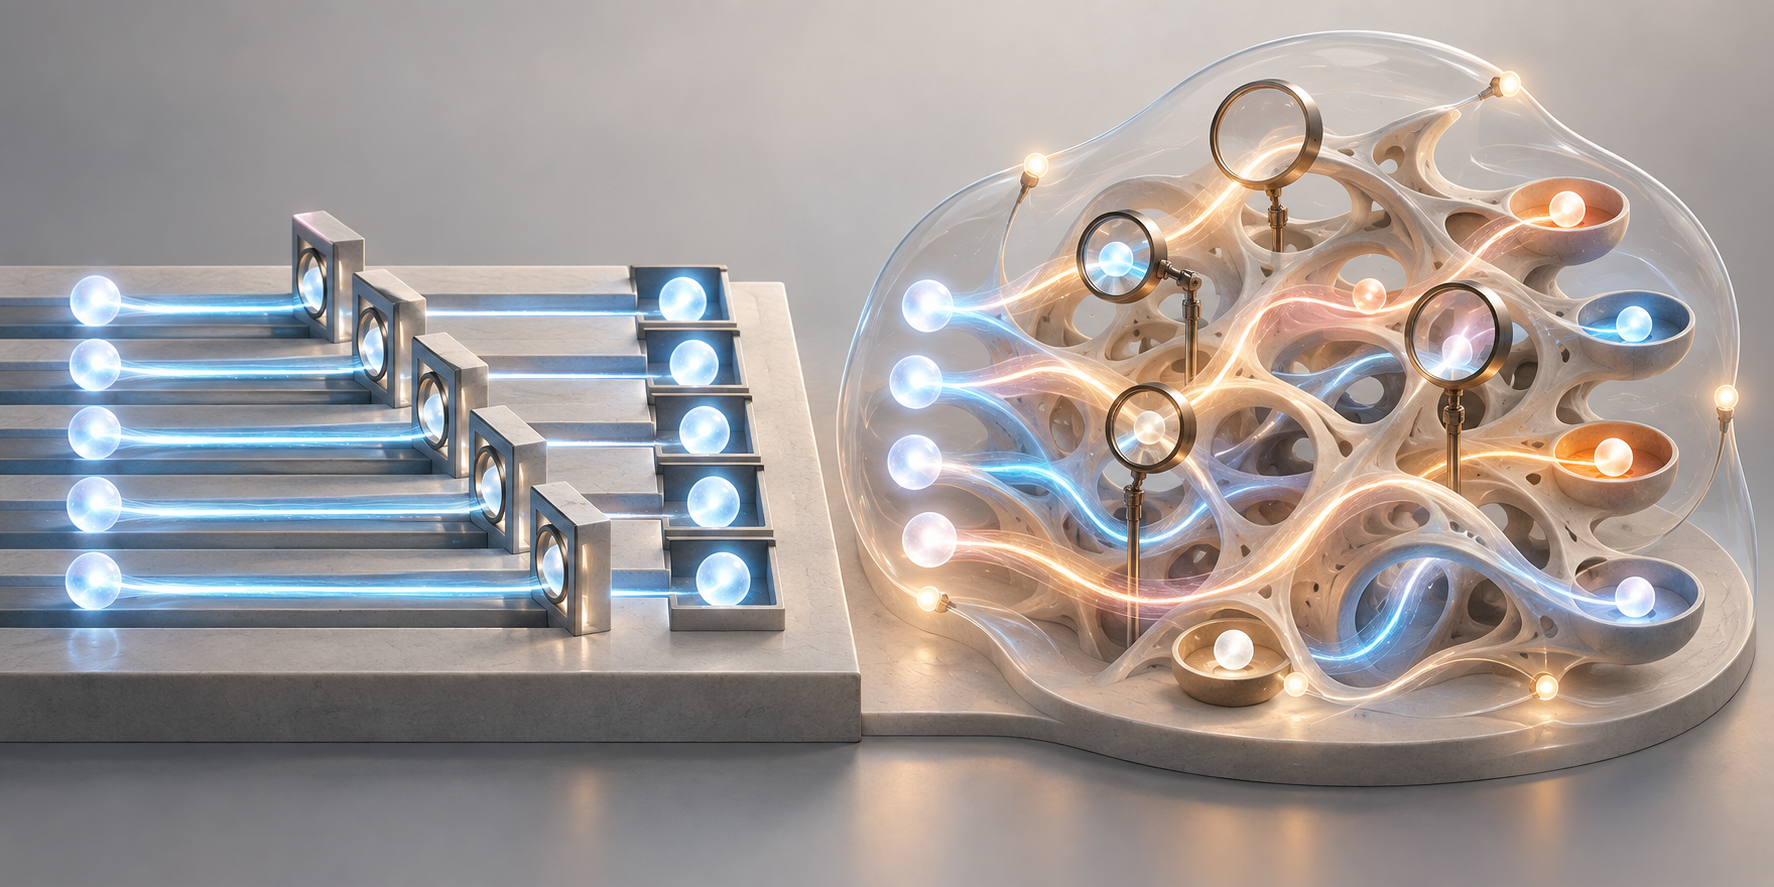
La plupart des systèmes d'entreprise traditionnels ont été construits autour de trois hypothèses : les tâches se terminent rapidement, une nouvelle tentative est gratuite et la même entrée produit toujours le même résultat.
Les charges de travail agents ne répondent pas à ces trois attentes, c'est pourquoi les pilotes qui fonctionnent bien se transforment en problèmes opérationnels une fois qu'ils fonctionnent sans surveillance. La difficulté est rarement le modèle ; ce sont l'infrastructure environnante et les pratiques de gestion qui assument les propriétés que ces charges de travail n'ont plus.
Qu'est-ce qui a changé
Les agents fonctionnent selon des règles différentes de celles des logiciels conventionnels. Voici trois différences significatives :
Le travail prend des minutes, pas des millisecondes. Une tâche agent peut s'exécuter suffisamment longtemps pour dépasser des seuils de délai d'attente que votre pile n'a jamais rencontrés auparavant. Des systèmes qui semblaient stables commencent à échouer d’une manière qui semble mystérieuse jusqu’à ce que quelqu’un en vérifie la durée.
Les tentatives coûtent désormais de l’argent. Traditionnellement, la logique de nouvelle tentative est presque gratuite, les équipes réessayent donc généreusement. Mais chaque tentative contre un modèle mesuré consomme des ressources de calcul, que le résultat soit utilisable ou non. La combinaison de seuils de qualité lâches et de tentatives automatiques crée un événement budgétaire. Étant donné que l'utilisation de l'interface de programmation d'applications cloud et modèles est facturée de manière asynchrone sur des cycles mensuels, ces coûts de nouvelle tentative composés s'accumulent discrètement et ne deviennent visibles que lorsque la facture arrive des semaines plus tard.
Les échecs ne peuvent pas être reproduits. C'est le plus grand changement. Lorsqu’un ingénieur étudie un mauvais résultat, la pratique standard consiste à le réexécuter et à le voir échouer à nouveau. Cela ne fonctionne pas lorsque des agents sont impliqués. Sans une trace étape par étape des décisions des agents, des appels d'outils et des exécutions de l'interface de programmation d'applications, il n'y a rien à enquêter et les avis deviennent des spéculations.
Pourquoi les pilotes cachent tout ça
Les équipes expérimentées se font prendre parce que l’environnement d’évaluation cache tout cela.
Lorsqu’ils travaillent de manière interactive, les humains sont les gestionnaires d’erreurs. Ils lisent chaque résultat, remarquent des problèmes et réessayent. Les coûts sont visibles car les tentatives sont comptées et les correctifs appliqués à la main. Il n'est pas nécessaire de disposer d'un enregistrement d'audit ou d'un moyen de reproduire l'échec exact.
En revanche, les flux de travail automatisés des agents s’exécutent sans interface graphique, avec un risque de pannes non enregistrées susceptibles de perturber les systèmes en aval. Un flux de travail qui se comportait de manière fiable lorsqu'une personne discutait avec l'IA et vérifiait chaque réponse se comporte différemment lorsqu'un planificateur le déclenche 400 fois pendant la nuit sans que personne ne le surveille. L’erreur était toujours présente, mais elle était invisible car un opérateur humain l’absorbait et la corrigeait une réponse à la fois.
Avant de passer à une production automatisée avec des agents, les responsables de l'ingénierie doivent identifier chaque tâche que l'humain effectuait manuellement et spécifier quel contrôle ou système automatisé assumera cette responsabilité.
Trois risques méritent votre attention
Coûts invisibles. Les dépenses ne dépendent plus uniquement du volume d’utilisation. Les boucles d'IA autonomes réessayent automatiquement les tâches ayant échoué, régénèrent les réponses et frappent les API à plusieurs reprises sans intervention ni approbation humaine. Un seuil fixé par un développeur peut faire évoluer la facture mensuelle plus qu'une négociation d'approvisionnement. Demandez le coût par unité terminée plutôt que le coût par appel d'API, car le deuxième chiffre exclut les tentatives rejetées.
Des échecs qui témoignent du succès. Les défauts les plus coûteux ne sont pas des erreurs mais des résultats qui semblent structurellement valides mais qui sont fondamentalement faux. Les agents probabilistes ne peuvent pas reconnaître leurs propres erreurs logiques, ils produisent donc des sorties correctement formatées avec des données incorrectes qui semblent structurellement valides. Les systèmes automatisés en aval les acceptent et les traitent sans déclencher d'alertes. La surveillance conventionnelle manque ces erreurs car rien n’a échoué. La qualité des résultats de l'IA doit être mesurée à l'aide de critères programmatiques prédéfinis (tels que des contrôles d'assertions, des règles LLM en tant que juge ou des références sémantiques) plutôt que de s'appuyer sur la disponibilité standard du système ou sur les journaux d'erreurs.
Des incidents que personne ne peut expliquer. Si votre équipe ne peut pas dire quelle version du modèle, quelles entrées et quels paramètres ont produit un résultat spécifique, elle ne peut pas l'enquêter et un auditeur non plus. Ces informations sont peu coûteuses à capturer pendant l’exécution du travail et presque impossibles à reconstruire ultérieurement.
Que demander à votre équipe
Cinq questions abordent la plupart des scénarios qui viennent d’être décrits :
- Qu'est-ce qui définit un résultat acceptable et est-il écrit avant l'exécution des travaux ? L'automatisation nécessite des critères d'acceptation clairs et reproductibles. Si les critères de réussite changent en fonction de l'opinion humaine individuelle lors de l'examen, le logiciel ne peut pas valider automatiquement le résultat.
- Combien de tentatives une unité terminée typique prend-elle, et est-ce plafonné ? Une boucle de nouvelle tentative illimitée par rapport à une norme vague est la source la plus courante de dépenses excessives.
- Qu'enregistrons-nous pour chaque passage, et pourrions-nous produire cet enregistrement sur demande dans six mois ? Les données de tâche doivent inclure la charge utile d'entrée exacte, la version de l'invite/du modèle, l'horodatage, la latence d'exécution, le nombre de tentatives, le coût du jeton et l'artefact de sortie final.
- Qui approuve les différentes classes de production, par leur nom ? Pas une équipe, un individu. Quand quelque chose ne va pas, c’est la première question qui sera posée.
- Que se passe-t-il lorsque le fournisseur met à jour le modèle ? Les mises à jour du modèle peuvent modifier subtilement le formatage, la précision ou la logique du raisonnement des réponses. Ces changements en aval peuvent interrompre les pipelines automatisés, c'est pourquoi les modifications de version du modèle doivent être testées dans un environnement intermédiaire avant d'être déployées en production.
Là où la consolidation aide
Le travail agentique a tendance à être dispersé car les équipes gèrent les outils agentiques en utilisant des pratiques logicielles traditionnelles. Les invites se trouvent dans le référentiel d'une équipe, les artefacts sont dans différents compartiments, les approbations ont lieu dans les fils de discussion et personne ne peut produire un enregistrement d'exécution sans un après-midi d'archéologie.
L'espace de travail d'IA souhaité est un endroit où les exécutions, les entrées, les sorties, les résultats qualité et les approbations sont enregistrés ensemble, fonctionnant comme une surface opérationnelle qui permet aux équipes de gérer activement l'exécution, de réexécuter les entrées, de tracer les journaux et de contrôler les flux de travail des agents en temps réel. Il s'agit d'une discipline plus qu'une décision de produit. Les rapports et la journalisation doivent être continus à chaque exécution plutôt que périodiques, afin que les équipes puissent tracer les anomalies et maintenir l'auditabilité en temps réel.
Ces mêmes questions déterminent quelle plateforme ancre votre espace de travail IA. La plateforme peut-elle rendre compte de ce qui a produit un résultat ? Peut-il être réexécuté à partir d'une entrée enregistrée ? Distingue-t-il un échec d’un refus d’un résultat dégradé ? Les fournisseurs au service des pipelines de production, y compris des plateformes telles que ImagineArt, le révèlent de plus en plus. Une démonstration de produit soignée montre les meilleurs résultats sélectionnés, mais elle ne révèle pas comment le modèle d'IA gère les cas extrêmes, les erreurs inattendues ou les tâches continues de longue durée lorsqu'il fonctionne automatiquement.
La conversation sur les compétences
Il est facile de manquer un modèle lors de la planification. Les équipes qui créent des fonctionnalités agentiques proviennent souvent du développement d'applications, où les modèles de requête et de réponse synchrones sont la norme. Ces charges de travail se comportent comme des pipelines de données : longues, partiellement défaillantes et coûteuses à réexécuter.
Si aucun membre de l’équipe n’a utilisé ce type de système auparavant, le déficit de compétences se manifeste sous la forme d’une série d’incidents surprenants plutôt que d’une indication que les compétences doivent être améliorées. La conversation sur les compétences est moins chère.
L’IA agentique n’a pas créé une nouvelle classe de problèmes opérationnels. Il a supprimé des hypothèses qui existaient depuis des décennies, et la plupart des incidents remontent à ces lacunes de processus plutôt qu'à la qualité du modèle.
Définissez ce que signifie « correct » avant l’exécution des travaux. Mesurez le coût par unité terminée. Enregistrez suffisamment pour enquêter sur ce que vous ne pouvez pas reproduire. Gardez une personne nommée responsable de ce qui est expédié. Rien de tout cela n’est exotique, mais rien de tout cela ne correspond à ce pour quoi votre pile actuelle a été conçue.
M. Touheed est spécialiste de la croissance chez Imagine Art. Il a écrit cet article pour SiliconANGLE.
