Le réglage fin des modèles grâce à l’apprentissage par renforcement est en train de devenir l’une des tâches les plus exigeantes de l’infrastructure de l’IA. Il mélange la formation, l'inférence et le travail d'agent en bac à sable dans une seule boucle, souvent avec du code de recherche enchevêtré dans les systèmes situés en dessous.
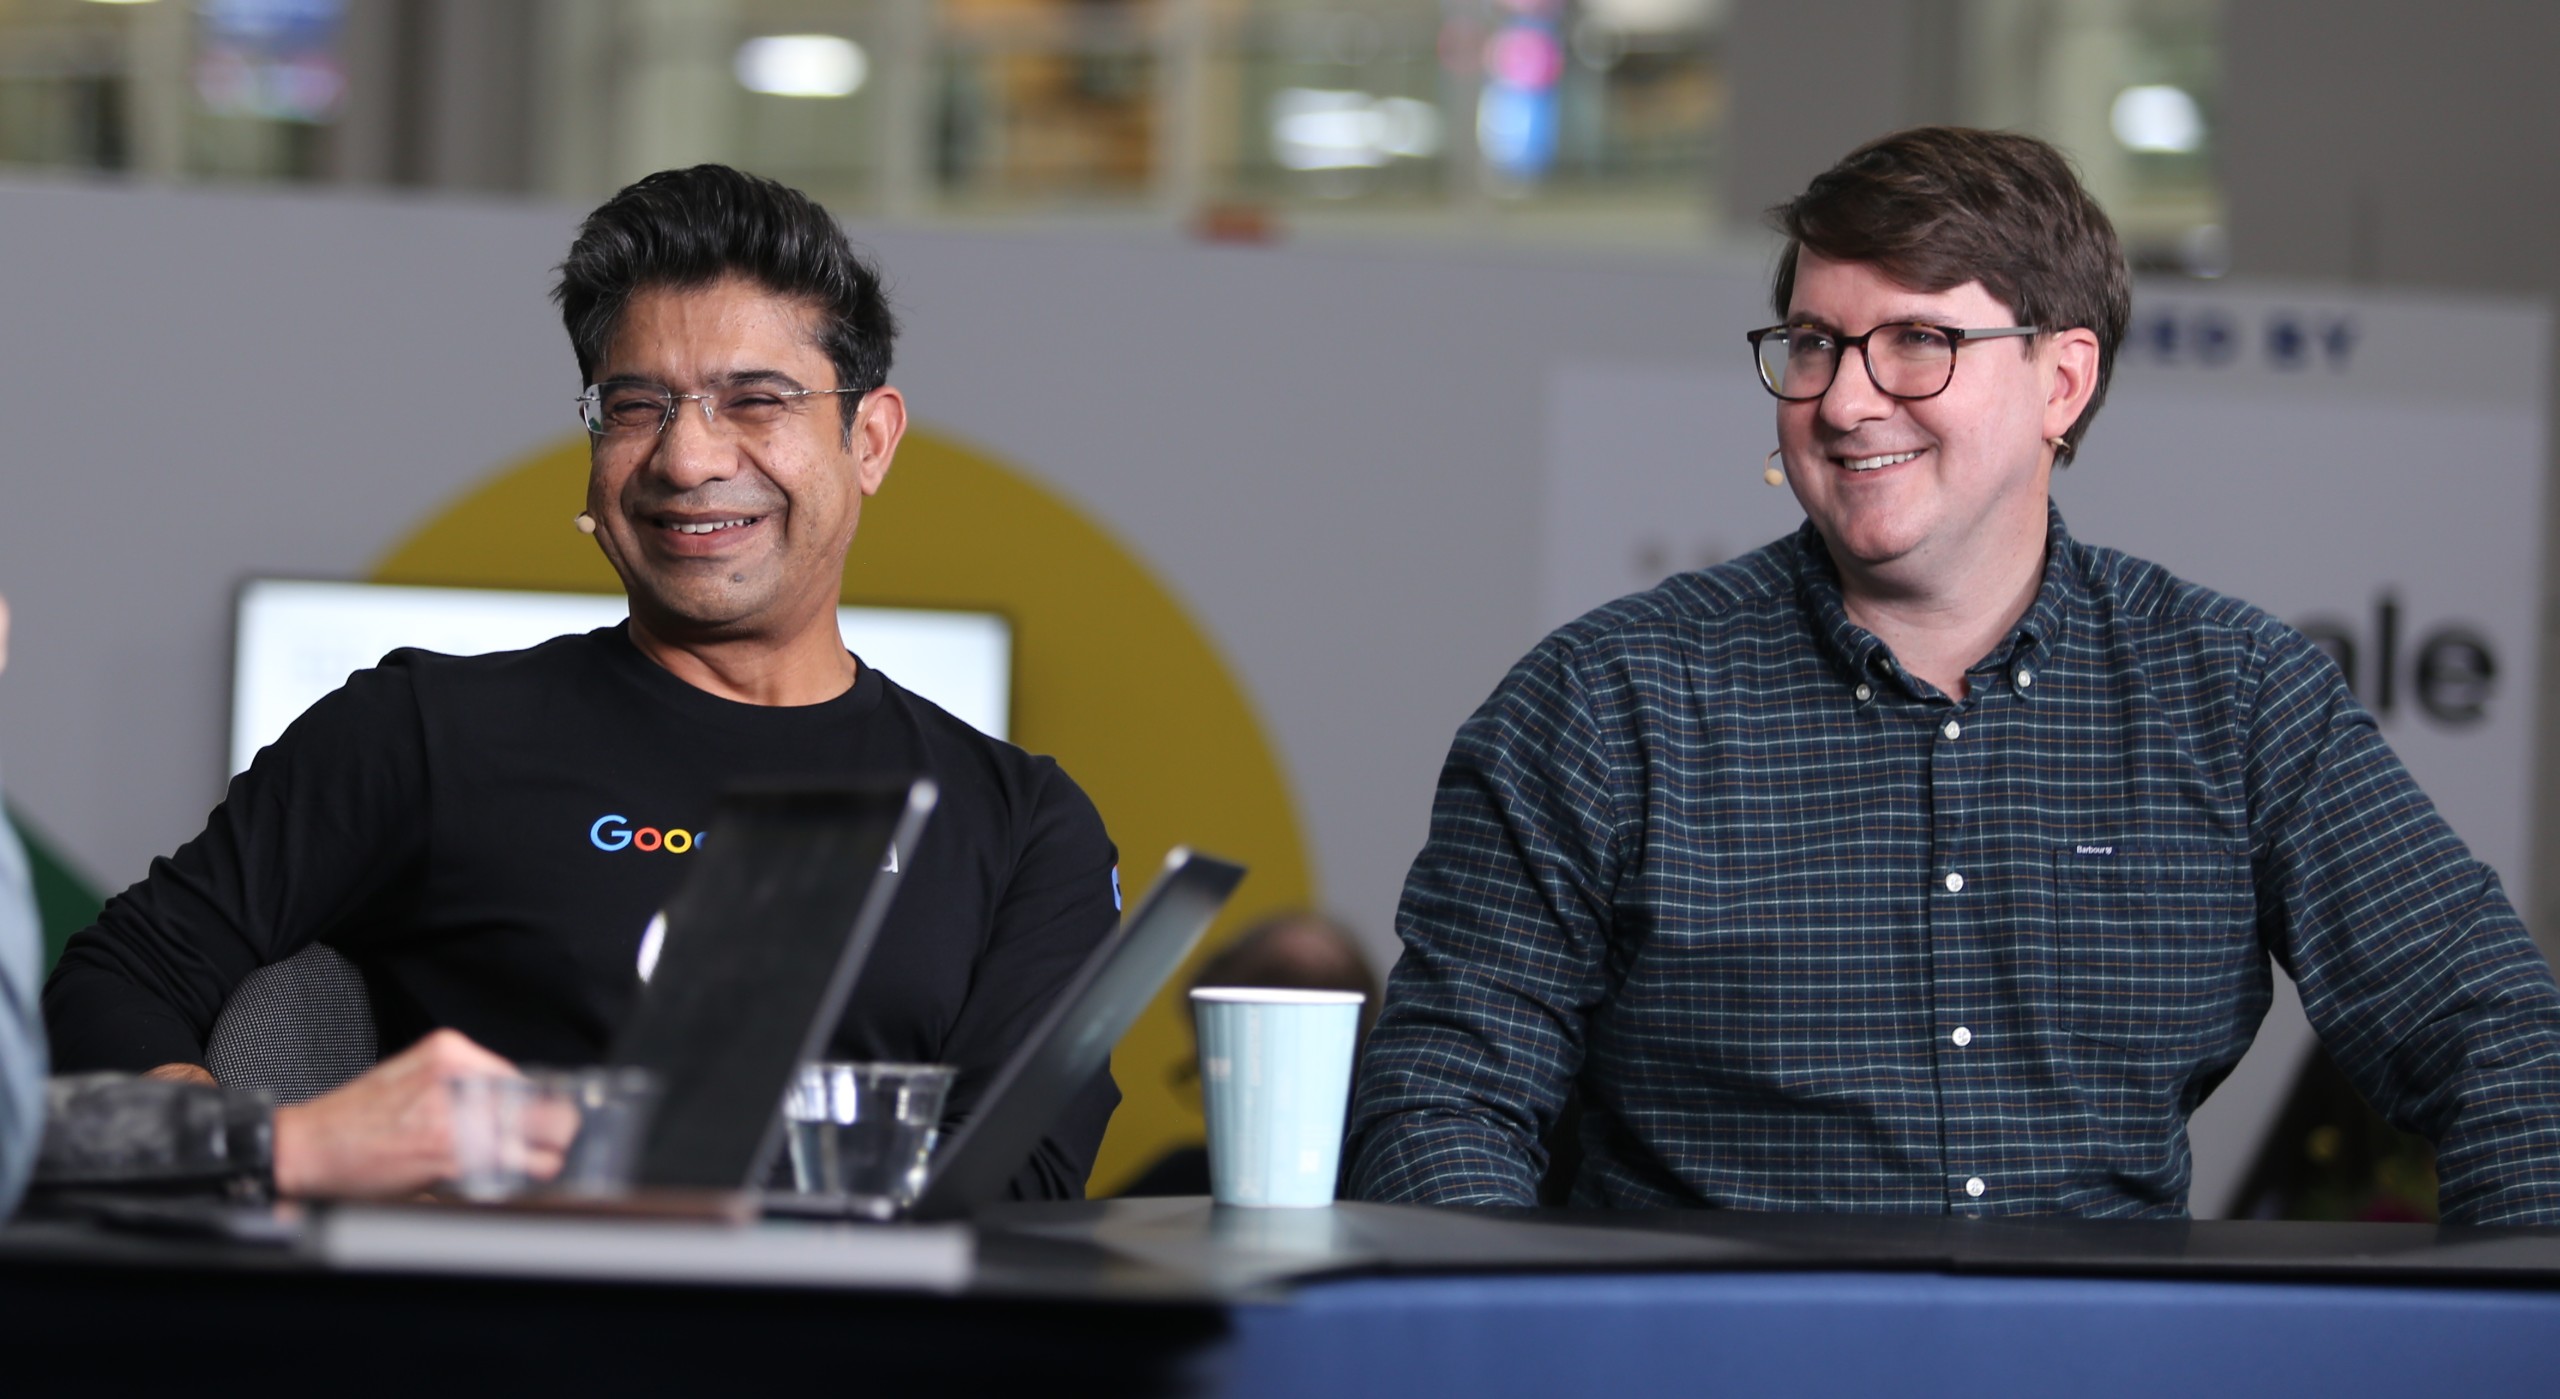
Google LLC s'est attaqué à ce problème au sein de son groupe d'ingénierie Kubernetes et a récemment fait don du résultat, OpenRL, à la Cloud Native Computing Foundation. L'équipe GKE Labs y est parvenue en créant un agent d'IA pour les tâches Kubernetes, puis un benchmark pour évaluer les modèles sur ce travail, selon Sunil Arora (photo, à gauche), ingénieur logiciel senior chez Google Cloud.
« Si vous regardez l'apprentissage par renforcement, je le considère comme une sorte de super application d'IA car il implique une formation. Cela implique un échantillonnage. Cela implique des agents qui font réellement des choses dans un bac à sable et parfois une sorte d'évaluation du travail », a déclaré Arora. « Il s'agit d'une charge de travail très diversifiée qui, je pense, repousse les limites de notre infrastructure. »
Arora et Justin Santa Barbara (à droite), développeurs chez Google, se sont entretenus avec John Furrier et Rebecca Knight de theCUBE Research à KubeCon + CloudNativeCon NA, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la mise au point du modèle et de leur travail au sein de GKE Labs, qui met très tôt les projets expérimentaux entre les mains des utilisateurs. (* Divulgation ci-dessous.)
Ajustement du modèle sans enchevêtrement d’infrastructure
OpenRL a fait ses débuts en tant qu'aperçu de recherche en juin 2026, proposant une API de formation auto-hébergée pour le cluster Kubernetes d'une entreprise. Il sépare la boucle d'apprentissage par renforcement de la plomberie informatique, de sorte que les ingénieurs en infrastructure gèrent la mise à l'échelle tandis que les chercheurs gardent le contrôle des expériences, a expliqué Arora.
« Avec OpenRL, l'une des choses que nous essayons de faire est en quelque sorte de faire abstraction de l'infrastructure en tant que sorte de primitives de base afin que les chercheurs et les ingénieurs en IA puissent simplement se concentrer sur leur boucle RL », a déclaré Arora.
Les bacs à sable sont l'endroit où cette boucle rencontre l'infrastructure des agents, car le calcul des récompenses peut nécessiter l'exécution de millions de commandes isolées. Selon Arora, l'Agent Substrate de Google regroupe davantage de ces bacs à sable sur un calcul limité. Pour Santa Barbara, le besoin est apparu étape par étape.
« Nous avons construit Kubectl-ai et, en théorie, Kubectl-ai aurait pu formater mon disque dur », a déclaré Santa Barbara. « J'aimerais bien avoir un bac à sable pour cela, afin que s'il formate un disque dur, il formate ce bac à sable sans dommage. »
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE de KubeCon + CloudNativeCon NA :
(* Divulgation : Google Cloud a sponsorisé ce segment de theCUBE. Ni Google Cloud ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
