L'inférence se déplace au centre des dépenses des entreprises en matière d'IA, et la couche de données d'IA apparaît comme l'élément qui décide si ces investissements sont rentables. Alors que les coûts des GPU augmentent et que les pénuries de composants persistent, l’architecture derrière l’IA passe d’une poignée d’installations massives à un réseau distribué de sites plus petits.
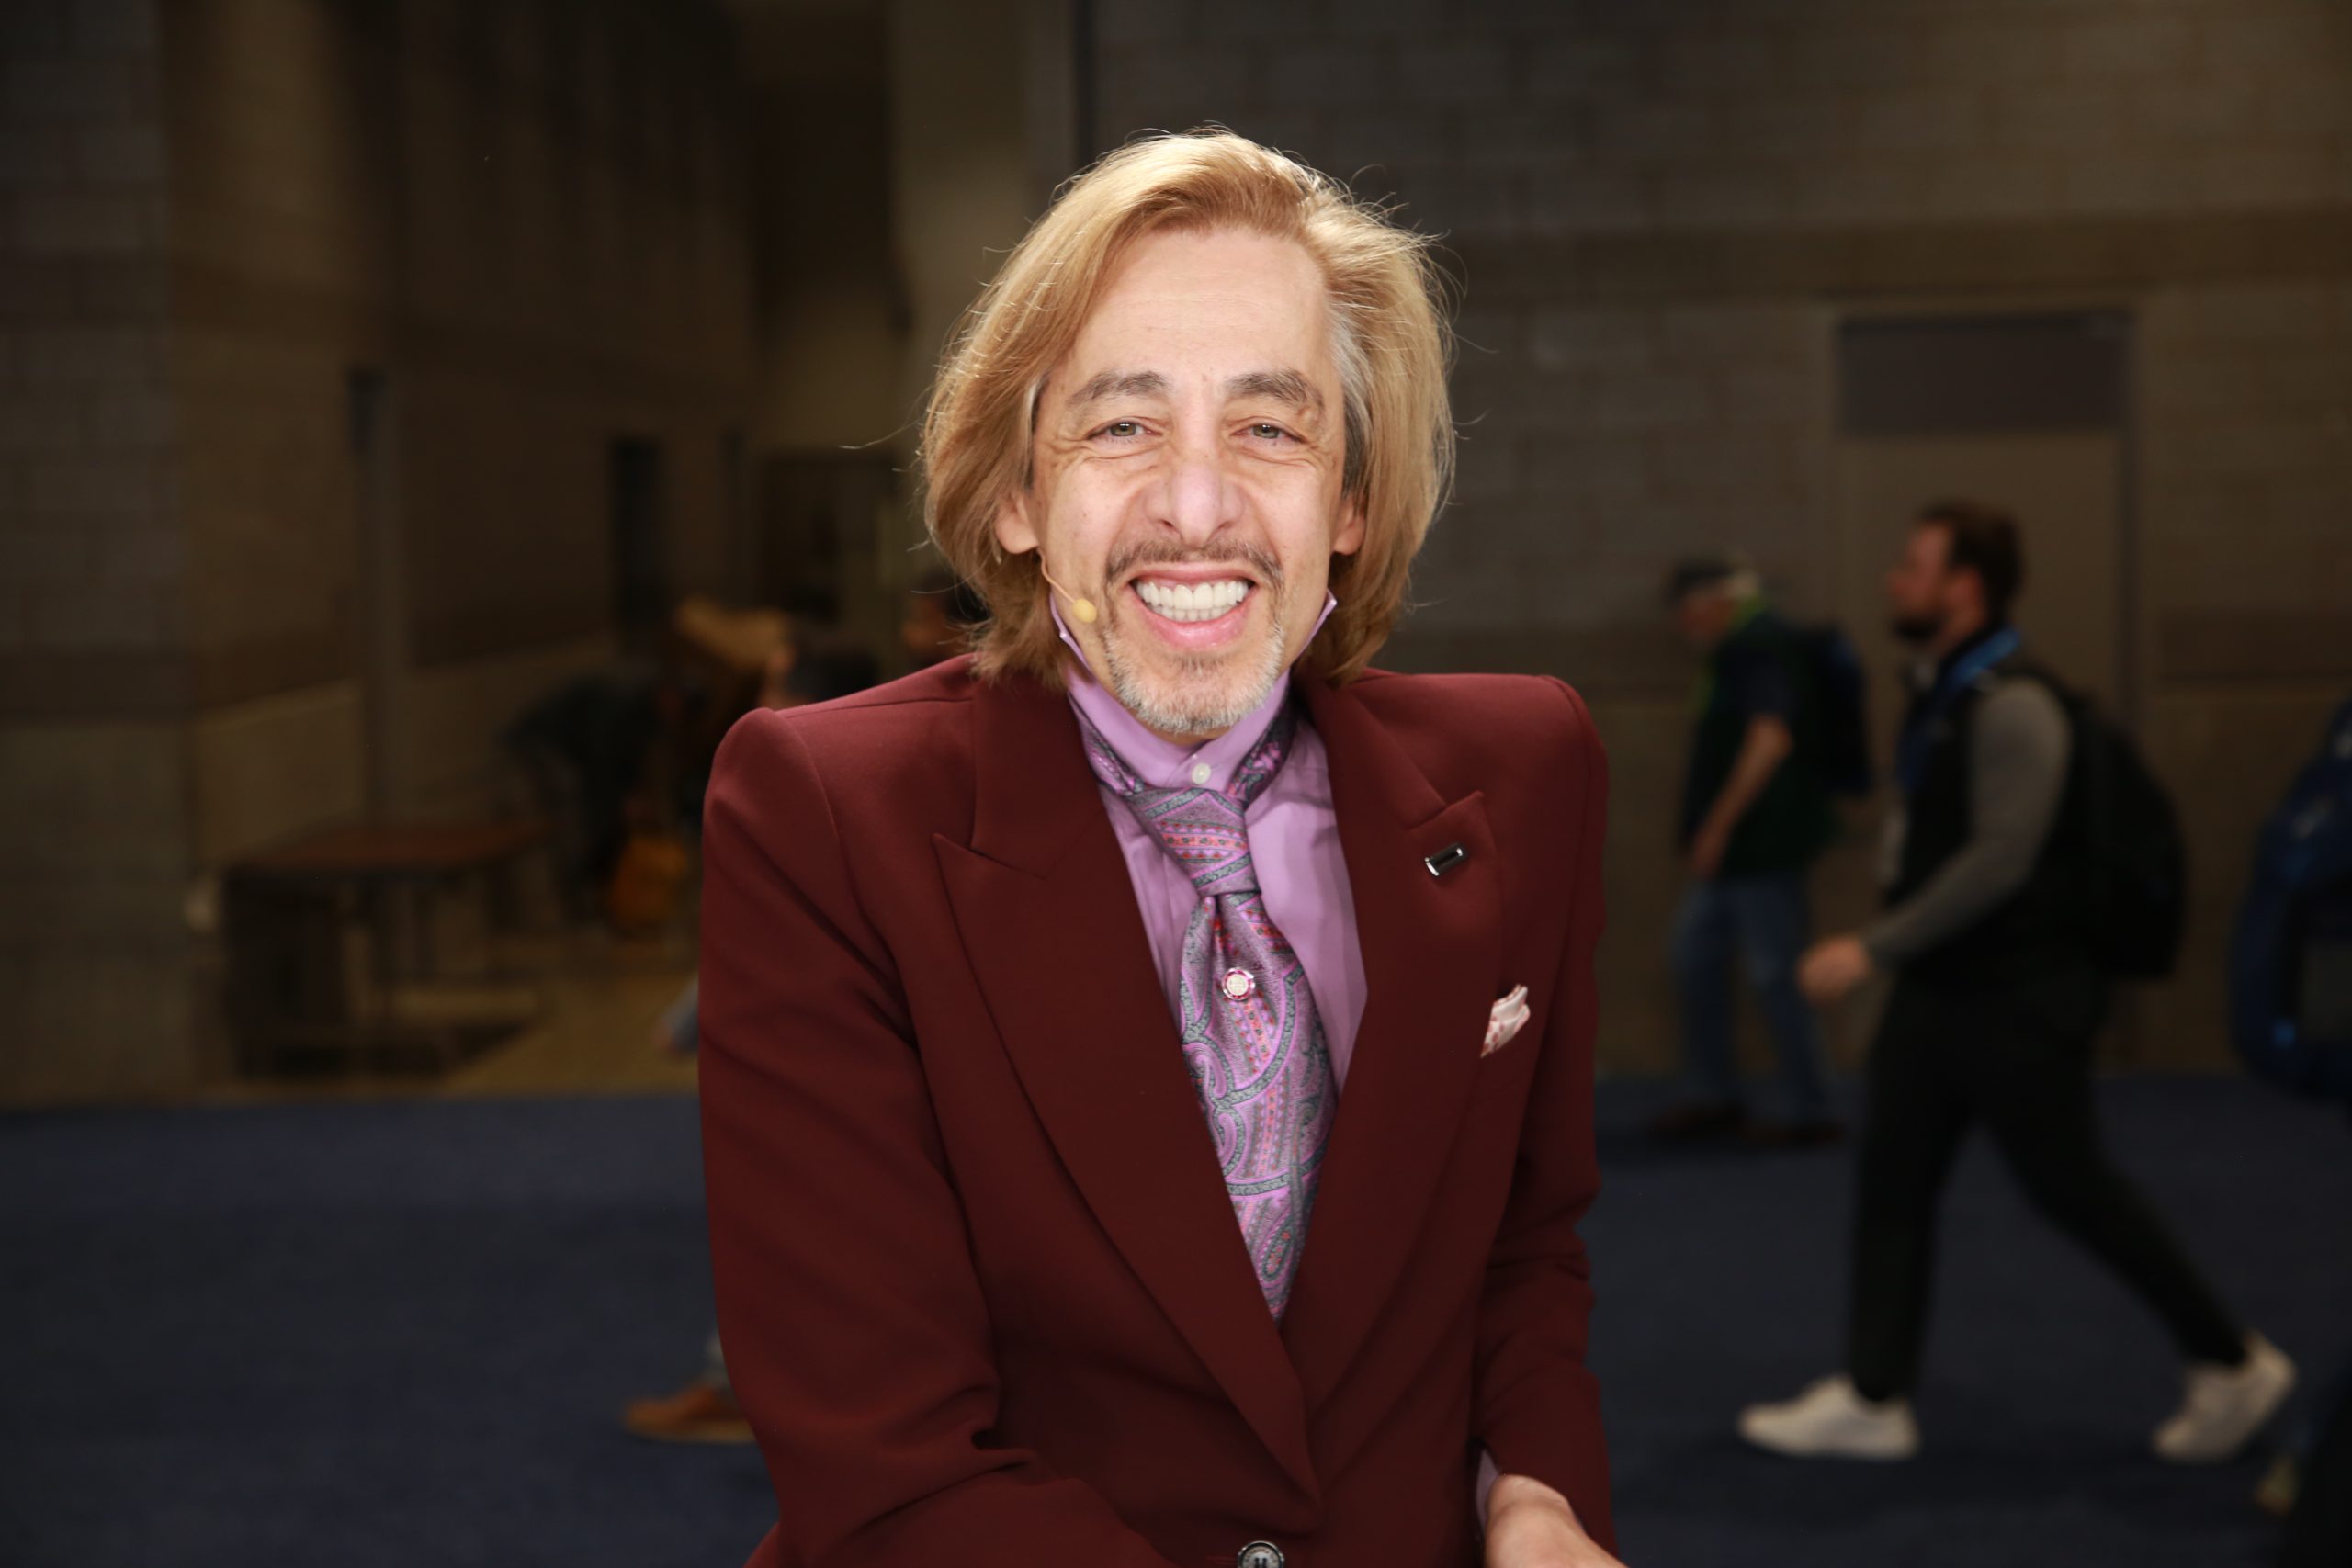
Ce changement place les sociétés de stockage ayant des racines dans le calcul haute performance au centre de la conversation sur l’IA. Transformer les données en informations à un coût acceptable dépend désormais d'un moteur de données résilient et sécurisé conçu pour l'efficacité du GPU, selon Alex Bouzari (photo), co-fondateur et PDG de DataDirect Networks Inc.
« Comme l'inférence est hors du commun en termes d'utilisation, la couche de données est ce qui fait la différence », a déclaré Bouzari. « Les coûts montent en flèche. Les GPU deviennent de plus en plus puissants, mais aussi de plus en plus chers. »
Bouzari s'est entretenu avec John Furrier et Rebecca Knight de theCUBE Research au SC26, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la manière dont l’inférence, la pression sur les coûts et les pénuries remodèlent l’infrastructure de l’IA. (* Divulgation ci-dessous.)
Pourquoi la couche de données IA va être distribuée
La première vague de développement de l’IA a concentré les GPU dans de grandes installations gourmandes en énergie. L'inférence modifie ces calculs car elle doit être proche des utilisateurs et de leurs données, a expliqué Bouzari. Les communautés s’opposent également aux centres de données monolithiques géants, a-t-il ajouté.
« Maintenant, ce qui se passe avec l'inférence, vous devez compléter cela avec des empreintes plus petites. Appelons-les des centres de données, 1 mégawatt, 2 mégawatts, 5 mégawatts. Et ceux-ci doivent résider là où se déroule l'action, là où se déroule la conduite autonome, là où se déroule l'IA physique, là où se trouvent les données des capteurs », a déclaré Bouzari.
Connecter de petits pods à de grandes usines d’IA nécessite une approche différente des données. DDN construit une couche logicielle qui couvre de nombreux types de matériel, une orientation reflétée dans sa récente décision visant à libérer son système de fichiers EXAScaler du propre matériel de DDN. L’objectif est d’optimiser l’utilisation d’équipements très coûteux, selon Bouzari.
« Il s'agit d'une couche logicielle qui doit s'adapter aux différents types de matériel car, regardez, les coûts étant si élevés, les gens veulent pouvoir maximiser l'utilisation sur une période de temps prolongée, tout comme c'était le cas dans le calcul haute performance », a déclaré Bouzari.
L’ampleur des dépenses a radicalement changé. Quelques centaines de millions de dollars finançaient autrefois le supercalculateur le plus rapide du monde, mais ils permettent désormais d'acheter 15 à 20 racks d'équipements, a noté Bouzari. Les pénuries de GPU, de mémoire et de disques SSD se heurtent à un contrôle budgétaire plus strict.
« D'un côté, vous avez des contraintes budgétaires et la nécessité de tirer le plus de valeur possible de votre investissement », a déclaré Bouzari. « D'un autre côté, il y a des pénuries. Et donc une couche de données qui peut faire beaucoup plus avec beaucoup moins d'infrastructure, avec une empreinte plus petite est extrêmement précieuse. »
Cette réflexion s’étend à l’entreprise. L'Enterprise AI HyperPOD de DDN regroupe les processeurs, les GPU, la mise en réseau et le stockage dans un rack qui peut être installé sur les sites d'entreprise existants avec l'énergie disponible. Garder le module sur site donne également aux entreprises un contrôle plus strict sur leurs données, a expliqué Bouzari.
« Je pense que nous entrons dans une ère où nous verrons une prolifération de modules à plus petite empreinte déployés dans les entreprises du monde entier », a déclaré Bouzari.
Bouzari a présenté la couche de données IA comme la contrepartie du calcul accéléré, Nvidia Corp. fournissant le traitement et DDN fournissant les données. À mesure que l'inférence et les agents prennent le relais, l'aspect données prend plus de poids, a-t-il déclaré : « Vous avez besoin des deux pour réussir. Mais le moteur de données, je pense, devient de plus en plus important, car l'inférence et l'agent deviennent réellement le moyen prédominant d'utiliser l'IA et d'en tirer de la valeur. »
Voici l'interview vidéo complète, faisant partie de la couverture du SC26 par SiliconANGLE et theCUBE :
(* Divulgation : NYSE Wired a sponsorisé ce segment de theCUBE. Ni NYSE Wired ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
