Les graphes de connaissances peuvent donner aux agents de l’entreprise une compréhension commune de la façon dont les données, les règles métier et les processus s’articulent. Cependant, ce contexte devient plus difficile à maintenir lorsque chaque nouvel agent apporte sa propre version de ce que l’entreprise connaît.
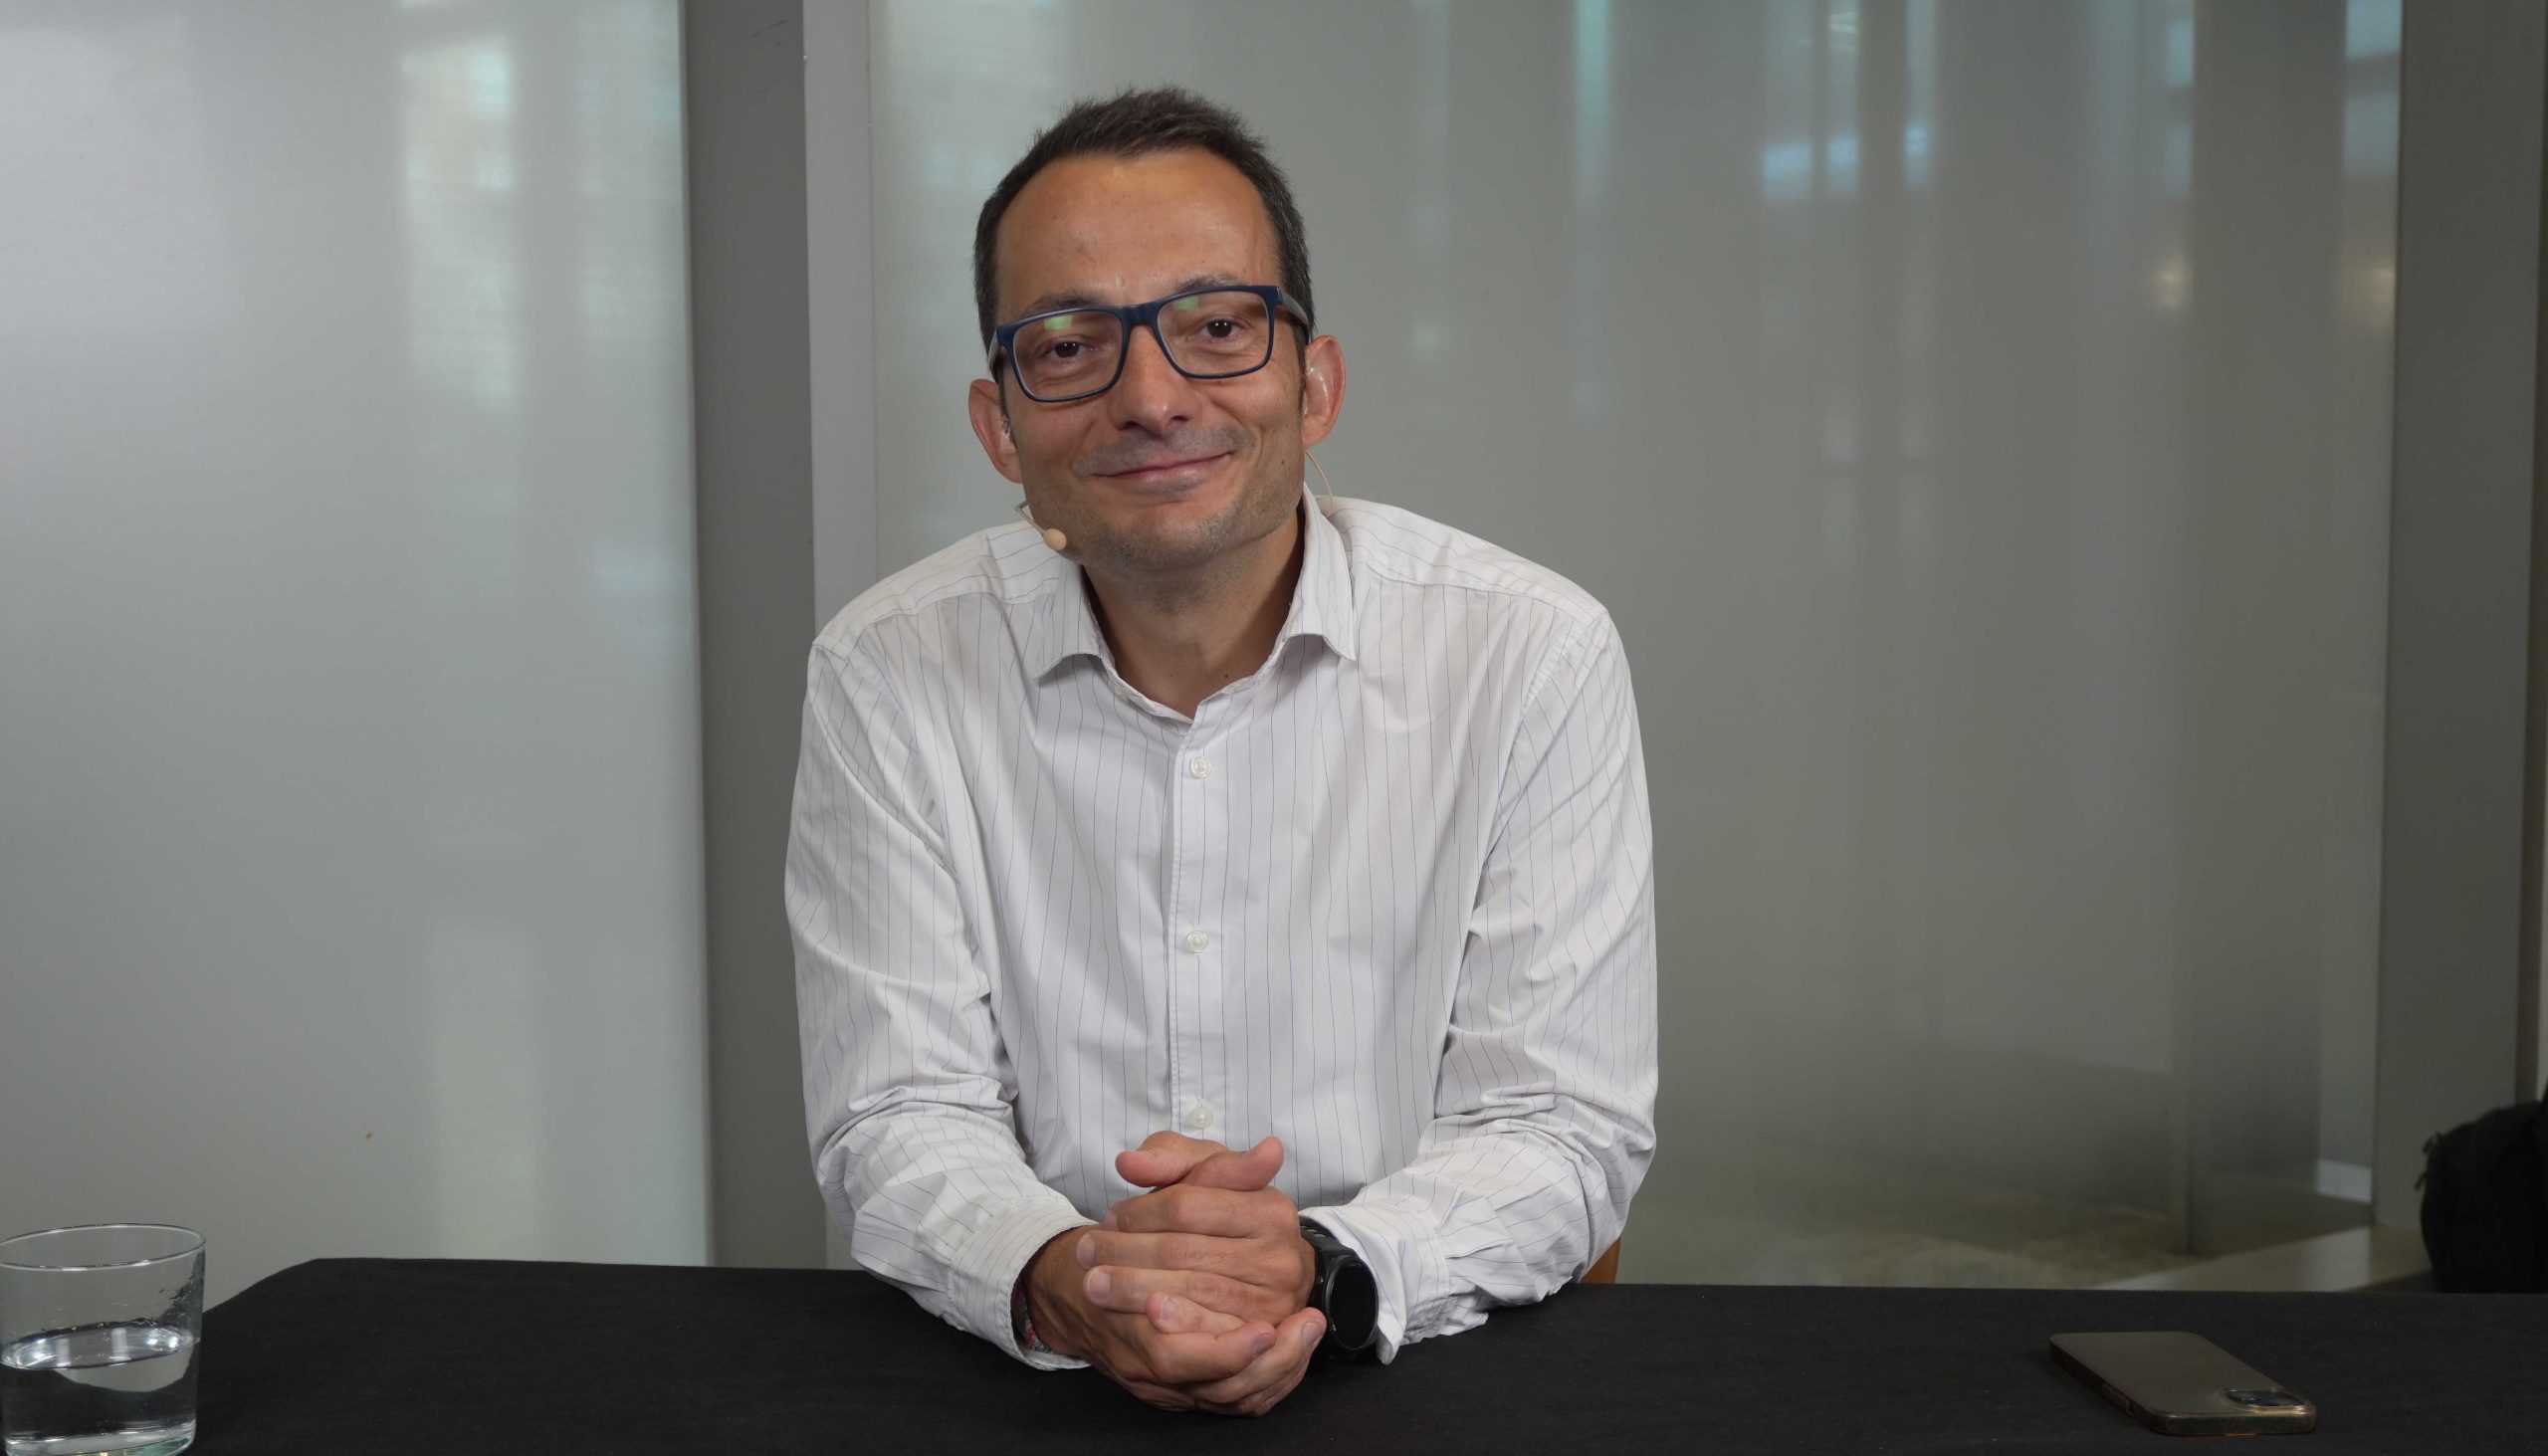
Les organisations sont devenues plus compétentes en matière de création d’agents, mais leurs résultats varient encore considérablement. La différence réside souvent dans la manière dont les connaissances de l'entreprise sont présentées, selon Jesús Barrasa (photo), directeur technologique de Gen AI chez Neo4j Inc.
« Vous devez donner aux agents accès non seulement à vos données, mais aussi à votre signification, à vos connaissances d'entreprise », a-t-il déclaré. « Cela n'est malheureusement pas toujours bien capturé… (ou) bien représenté. »
Barrasa s'est entretenu avec John Furrier de CUBE Research au GraphSummit, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la manière dont une couche de connaissances partagée pourrait aider les agents à utiliser le contexte de l'entreprise, à expliquer leurs réponses et à réutiliser leurs connaissances entre les tâches. (* Divulgation ci-dessous.)
Pourquoi les graphes de connaissances ont besoin d'une couche partagée
À mesure que les organisations utilisent davantage d’agents, elles sont confrontées à un problème familier : le travail effectué pour une application ne s’applique pas nécessairement à la suivante. Barrasa voit un parallèle avec les systèmes de reporting antérieurs qui produisaient des résultats contradictoires.
« Ils identifient un problème unique et développent les connaissances dont l'agent a besoin chez l'agent lui-même sous forme d'invites, sous forme de compétences », a-t-il déclaré. « Mais ensuite, que se passe-t-il ? Ils construisent l'agent numéro deux. Ils vont faire exactement la même chose. Nous répétons donc les erreurs que nous avons commises il y a sept ans lorsque nous créions des rapports sur différentes plates-formes et obtenions des résultats incohérents. »
Une couche de connaissances est une représentation gouvernée des actifs de données, des concepts, des politiques et des processus d'une organisation, selon Barrasa. Cela peut également aider les gens à examiner comment un agent est parvenu à une réponse – une préoccupation croissante à mesure que les agents passent de la conversation à l’action.
« Cette couche de connaissances, cette idée de capturer les connaissances de votre entreprise et de les utiliser comme moteur de contexte pour vos agents, vous donne non seulement la cohérence dont nous parlions auparavant, mais également l'explicabilité », a-t-il déclaré. « C'est la source de mes données. Ce sont les éléments que j'utilise pour produire la réponse. »
Créer des graphiques de connaissances dans tous les cas d'utilisation
Les graphes de connaissances peuvent relier les données aux concepts commerciaux et aux relations dont les agents ont besoin pour les interpréter. Les organisations peuvent développer ce contexte sur plusieurs applications au lieu de tenter dès le départ un modèle à l'échelle de l'entreprise, selon Barrasa.
« Vous voulez commencer avec un cas d'utilisation. Et lorsque vous créez le deuxième cas d'utilisation, vous devez essayer de l'aligner sur le premier », a-t-il déclaré. « C'est ainsi que vous construisez la couche de connaissances. Vous la construisez progressivement. Il s'agit de « identifier un cas d'utilisation, de réaliser de la valeur, puis de construire à partir de là ». La construction de l’ontologie est quelque chose qui (les grands modèles de langage) peut s’accélérer considérablement.
Une couche de connaissances partagée peut nécessiter une mesure de retour sur investissement plus large que les résultats d’un seul agent. Les organisations devraient également évaluer les changements à mesure qu’elles créent davantage d’agents, selon Barrasa.
« Vous souhaitez mesurer la façon dont la construction de l'Agent 2, de l'Agent 3 et de l'Agent 4 se déroule au fur et à mesure, car vous développez des connaissances dans la couche », a-t-il déclaré. « Une autre (métrique) est… une métrique négative : quel est le coût de la dérive ? Que se passe-t-il lorsque deux agents renvoient des résultats divergents ou agissent de manière différente ? Quel est le coût de la réconciliation de ces résultats ? »
Voici l'interview vidéo complète, faisant partie de la couverture du GraphSummit par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour GraphSummit. Ni Neo4j, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
