L’économie des usines d’intelligence artificielle ne dépend de plus en plus que de l’accès à des unités de traitement graphique hautes performances. Étant donné que les systèmes agentiques s'appuient sur plusieurs modèles, bases de données et outils, l'ensemble du centre de données doit fonctionner comme un seul système informatique.
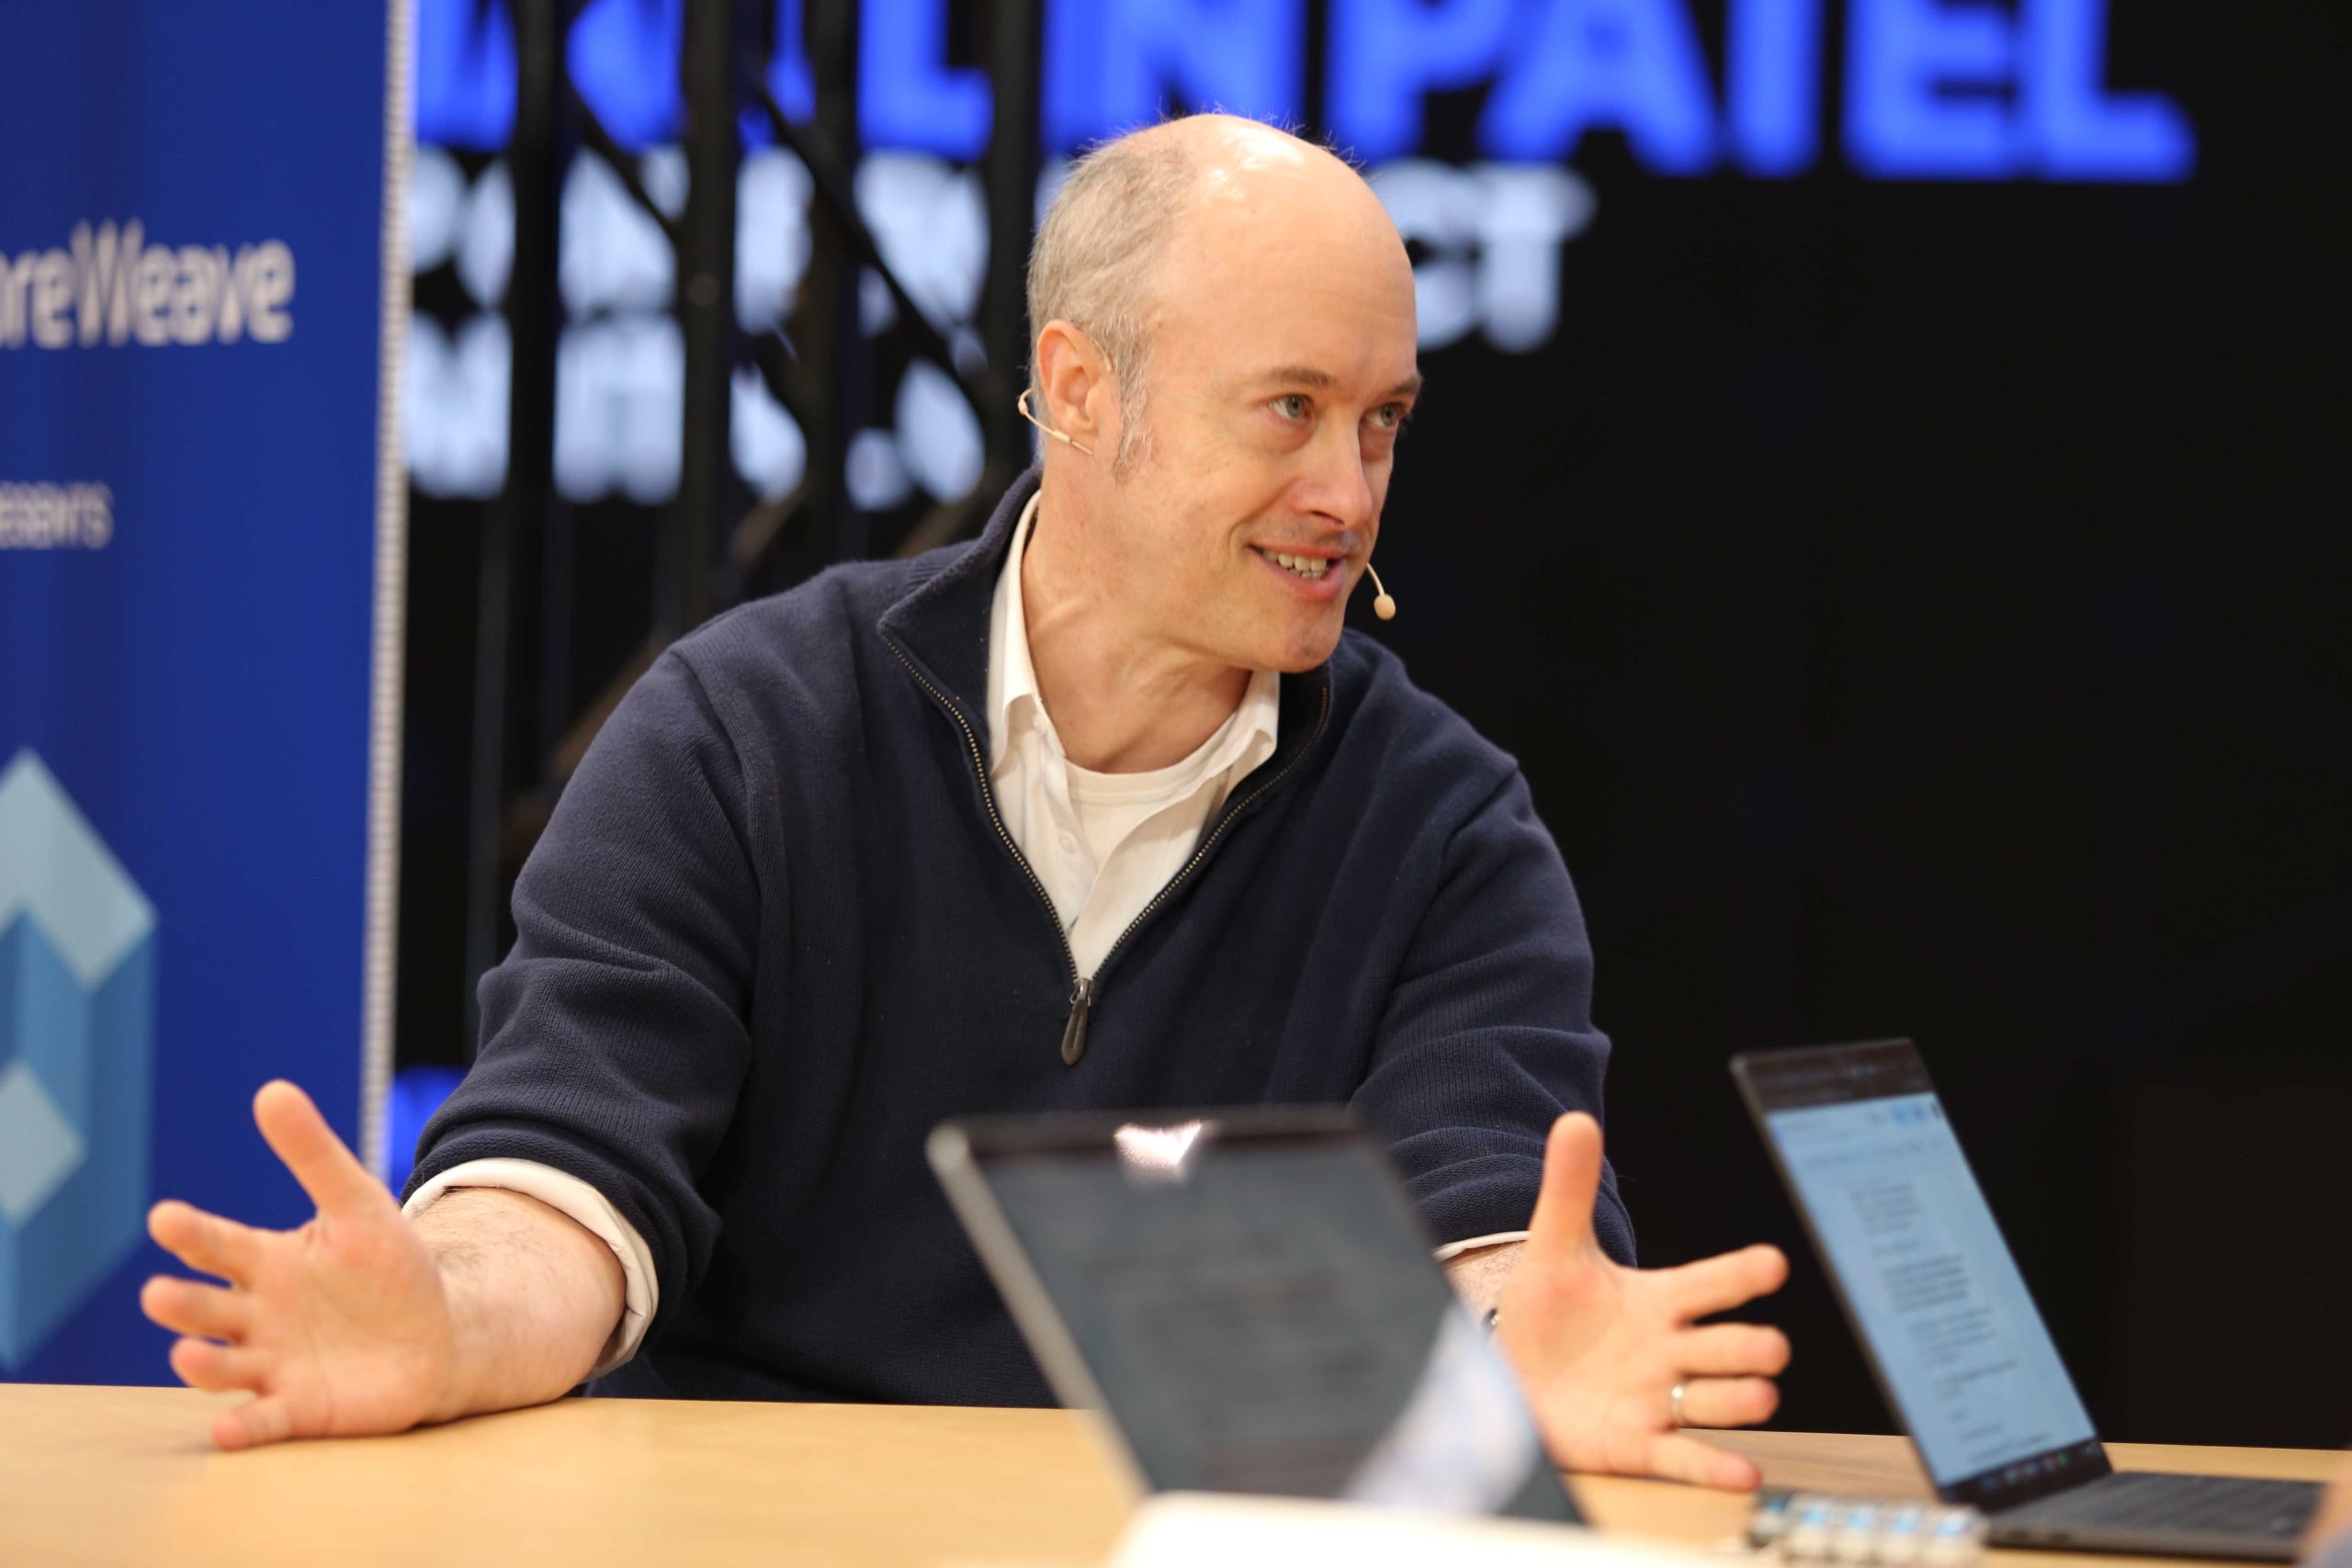
Cette transition détourne l’attention des puces individuelles vers l’infrastructure qui transforme la capacité informatique en intelligence utile. La mise en réseau, le stockage, les processeurs et les logiciels doivent fonctionner ensemble à grande échelle tout en augmentant la production générée par chaque unité d'alimentation, selon Ian Buck (photo), vice-président et directeur général de l'hyperscale et du HPC chez Nvidia Corp.
« Au lieu de voitures, d'appareils ou de PC, ce sont des jetons », a-t-il déclaré. « Ces actifs ne sont pas de l'informatique ; ils ne représentent pas des coûts. Ce sont en fait des éléments valorisants, générateurs de revenus, fongibles, durables et productifs d'une économie. »
Buck s'est entretenu avec Dave Vellante et John Furrier de theCUBE Research lors de l'événement Fully Connected, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de l’inférence, de la conception au niveau du système et de l’évolution économique de l’infrastructure de l’IA. (* Divulgation ci-dessous.)
L’inférence remodèle l’économie des usines d’IA
Le résultat commercial d’une usine d’IA provient de l’inférence, dans laquelle les modèles déployés traitent les demandes et produisent des jetons. Pourtant, l'inférence ne remplace pas la formation, car les organisations mettent continuellement à jour les modèles déployés à mesure que les données et les conditions du marché changent, selon Buck.
« Il ne s'agit pas simplement de tirer et d'oublier tous ces services », a-t-il déclaré. « Au fur et à mesure que les entreprises utilisent ces modèles, elles les affinent, les alignent, y ajoutent davantage de données. Les mettre à jour et les sensibiliser – cela représente en fait un petit peu de formation. Nous constatons le travail en matière d'apprentissage par renforcement et d'alignement en ligne. »
Une faible latence crée un autre niveau économique pour les charges de travail dans lequel un raisonnement plus rapide a une plus grande valeur. L'accélérateur d'inférence Groq 3 LPX de Nvidia fonctionne avec sa plate-forme Vera Rubin pour augmenter les taux de jetons par utilisateur pour les charges de travail sensibles au facteur temps.
« S'il y a de la valeur dans ces jetons pour avoir la réflexion la plus rapide possible, LPX peut être amélioré par rapport à Vera Rubin pour rendre cela possible », a déclaré Buck. « Nous constatons beaucoup d'intérêt pour des domaines comme la fintech et d'autres domaines où les choses se produisent en temps réel. »
La puissance fait de l’efficacité une priorité au niveau du système
En fin de compte, la capacité électrique limite la quantité d’infrastructure informatique qu’un centre de données peut déployer. Cette contrainte fait des jetons par watt une mesure centrale de l’économie des usines d’IA et met la pression sur les fournisseurs pour qu’ils améliorent les performances à chaque génération de matériel.
« Les centres de données ont un plafond naturel, et ce plafond représente en réalité leur pouvoir », a déclaré Buck. « Avec chaque génération de GPU, nous veillons à ce que nos jetons par watt soient jusqu'à 10 fois plus efficaces. En fait, nous l'avons vu avec Blackwell – nous avons finalement obtenu une amélioration de 30 fois du nombre de jetons par watt. »
Ce changement modifie également l’échelle à laquelle les systèmes doivent être conçus et exploités. CoreWeave permet aux clients de choisir des configurations ou d'utiliser des services d'inférence de niveau supérieur qui optimisent l'équilibre entre le débit et la vitesse des jetons, selon Buck.
« CoreWeave peut faire cela pour les clients », a-t-il déclaré. « Ils ne doivent pas se sentir dépassés par tous les choix. C'est là que notre écosystème de partenaires est si important. »
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE de l'événement Fully Connected :
(* Divulgation : TheCUBE est un partenaire média payant pour l'événement Fully Connected. Ni CoreWeave, le sponsor de la couverture de theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
