Pendant la majeure partie de la dernière demi-décennie, le récit autour Nvidia Corp. s'est largement concentré sur l'unité de traitement graphique. Les questions sont de savoir qui dispose des allocations, dans quelle mesure la prochaine génération sera plus rapide et si quelqu’un peut combler l’écart.
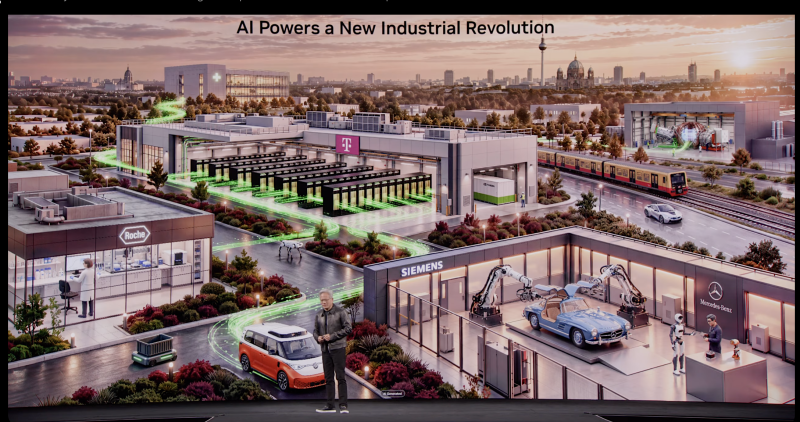
À CGV Berlin tôt dans la journée, le directeur général Jensen Huang a consacré étonnamment peu de son discours au silicium. Au lieu de cela, il a fait valoir que les contraintes de l'intelligence artificielle se sont déplacées vers la vitesse de déploiement, la puissance, la sécurité et la capacité à exploiter les données de l'entreprise, et que Nvidia a l'intention d'avoir une réponse pour chacun. « Nous avons été les premiers à remarquer qu'en fait, l'IA est une industrie manufacturière », a déclaré Huang à l'auditoire. « Plutôt qu'un outil que nous utilisons, il fait désormais partie de machines, d'infrastructures, d'usines qui produisent de l'intelligence. »
Ces commentaires de Huang regroupent la plupart des informations massives en provenance de Berlin. Un résumé de l'actualité inclut Nvidia présentant DSX POD, une conception de référence pour les usines complètes d'IA Vera Rubin construites par des partenaires dans des conteneurs ; lancer l'architecture de référence OpenShell pour exécuter les agents en toute sécurité ; étendre sa boîte à outils d'agent avec une base de connaissances d'agent et une nouvelle famille de modèles de données structurées appelée Kumo ; et approfondir sa présence dans les télécommunications avec Nokia et les opérateurs européens.
Individuellement, ce sont des lancements de produits. Ensemble, ils montrent que Nvidia passe de la vente du composant le plus important de l’IA à la vente du modèle opérationnel de l’IA.
Le temps jusqu'au premier jeton est la nouvelle métrique
L’un des moments les plus intéressants du discours d’ouverture est survenu lorsque Huang a fait des calculs au dos de l’enveloppe sur scène. Une usine d’IA d’un gigawatt coûte environ 50 milliards de dollars et devrait générer environ 40 milliards de dollars de revenus annuels. Retardez-le d’un quart et environ 10 milliards de dollars de revenus seront perdus. « Des revenus d’une valeur de 10 milliards de dollars rendront tout le monde anxieux », a-t-il déclaré.
C’est une façon intéressante et correcte de réfléchir à l’économie des infrastructures d’IA. Le coût qui empêche les constructeurs d’IA de dormir la nuit n’est plus le prix du matériel ; c'est le coût du matériel qui reste inactif pendant que les équipes tirent le câble. Une construction d’IA moderne est un projet de construction, avec des kilomètres de cuivre et de fibre assemblés sur site par une main-d’œuvre rare et spécialisée, notamment en Europe.
DSX POD intègre ce travail dans l'usine et cache la complexité au client. Chaque module contient sept racks Vera Rubin NVL72, avec environ 20 kilomètres de cuivre NVLink et 17 kilomètres de réseau évolutif, tous câblés, raccordés et testés avant expédition. Nvidia affirme que le déploiement sur un site préparé passe de six mois à 14 jours seulement.
La question la plus intéressante est de savoir où cela se situe. DSX POD ne remplacera pas les campus gigawatts, qui bénéficient toujours d'économies d'échelle. Le point idéal est le niveau des centaines de mégawatts, où un opérateur dispose d’un site et de l’électricité mais n’a pas le temps ou l’autorisation de piste pour une construction complète du terrain, de l’électricité et de la coque. C’est exactement là qu’interviennent les néoclouds, les projets souverains d’IA et les opérateurs télécoms européens. Le chiffre de 14 jours suppose que le site est prêt, avec une livraison prévue pour début 2027. Les conteneurs compressent l'intégration, mais ils ne corrigent pas les files d'attente d'interconnexion du réseau. Le DSX POD déplace le long mât dans la tente ; cela ne le supprime pas.
La puissance est désormais un élément de conception
La plate-forme DSX située sous le module est l'endroit où Nvidia effectue certains de ses travaux d'ingénierie les plus importants, qui ont tendance à passer inaperçus. Le refroidissement à eau chaude en boucle fermée permet aux opérateurs travaillant dans des climats appropriés d'éviter les tours d'évaporation, ce qui, selon Nvidia, permet d'économiser 54 millions de litres d'eau par jour à 2 gigawatts. DSX MaxLPS dirige l'alimentation là où les charges de travail en ont besoin, et Nvidia affirme qu'il fournit la même sortie avec jusqu'à 30 % d'énergie en moins.
La pièce que je surveillerais le plus est DSX Flex. Lors du match de l’Euro 2020 entre l’Angleterre et l’Allemagne, des millions de Britanniques ont allumé la bouilloire à la mi-temps et le réseau a connu un pic d’environ un gigawatt. Aujourd’hui, lorsqu’un opérateur de réseau a besoin de faire reculer un centre de données, le processus est principalement manuel, souvent par appel téléphonique. DSX Flex automatise cette interaction, permettant aux usines d'IA de différer ou de limiter le travail et de restituer la capacité.
C’est important car les centres de données qui se comportent comme des charges flexibles sont plus faciles à connecter et plus facilement acceptés par les communautés. L’industrie doit cesser de traiter les centres de données uniquement comme des consommateurs du réseau et commencer à les traiter comme des partenaires des opérateurs de réseau. Les hyperscalers évoluent déjà dans cette direction ; la différence est que Nvidia essaie d'en faire un standard.
La sécurité des agents appartient à l'infrastructure
La seconde moitié du discours s'est déplacée de l'usine vers ce qui y fonctionne, de plus en plus d'agents plutôt que de modèles. Huang a décrit un agent comme étant composé de cinq parties : le modèle, le harnais, le bac à sable, les connaissances et les outils. Il était clair sur la priorité. « L'agent est un système autonome qui a accès aux fichiers, aux ressources et aux réseaux, ainsi qu'aux outils, et nous devons nous assurer que les privilèges que nous accordons à ce système autonome sont minimes et que nous le surveillons en permanence », a-t-il déclaré.
Une grande partie du débat sur la sécurité de l’IA s’est concentrée sur l’alignement du modèle et les garde-corps, en supposant qu’un modèle qui se comporte bien est suffisant. Ce n'est pas le cas. Aucun modèle ne peut être formé pour comprendre les exigences politiques de chaque entreprise et secteur réglementé. Les agents sont des systèmes probabilistes qui trouveront des moyens créatifs de résoudre les problèmes, et certaines de ces approches toucheront aux données ou prendront des mesures que personne n'a prévu. Ils ont besoin de contrôles déterministes appliqués hors de leur portée.
C'est la thèse derrière l'architecture de référence OpenShell. Les harnais fonctionnent sur les processeurs Vera, les modèles fonctionnent sur Vera Rubin et BlueField-4 avec Nvidia Sentry fonctionne comme un moniteur isolé entre eux, capable de couper un agent en quelques millisecondes. Les professionnels du réseau reconnaîtront le modèle. C'est pourquoi le secteur a délaissé la sécurité basée uniquement sur l'hôte et a transféré son application vers le réseau. Il permet également aux équipes de sécurité de rédiger des politiques pour leur propre pays et secteur d'activité, ce qui est particulièrement important en Europe.
Comme prévu, la réponse de l'écosystème pour s'aligner sur Nvidia a été forte, avec CrowdStrike Holdings Inc., Palo Alto Networks Inc., Zscaler Inc., Cisco Systems Inc. et d'autres ajoutant leur support. La question est de savoir si OpenShell, qui est open source et fonctionne sur x86 ou Arm, peut fournir une application isolée du matériel sans BlueField. Les entreprises doivent distinguer les protections disponibles via le logiciel OpenShell de l'application matérielle supplémentaire fournie par BlueField-4 et Sentry.
La connaissance est l'endroit où les agents gagnent leur vie
« Ce qui transforme ces agents en super-agents, c'est leur donner accès aux connaissances de votre entreprise », a déclaré Huang. Les entreprises détiennent environ 70 % des données mondiales, et la plupart d'entre elles n'ont pas été préparées pour les agents. L'attention de l'industrie s'est principalement concentrée sur les documents et les PDF, mais une grande partie de la valeur commerciale réside dans les lignes et les colonnes des progiciels de gestion intégrés, de la chaîne d'approvisionnement et des systèmes financiers, et les modèles de langage ne sont pas conçus pour raisonner sur ces données.
Historiquement, obtenir une prédiction à partir d’un tableau signifiait créer un modèle personnalisé pour une seule question. Kumo est une famille de modèles prédictifs capables de répondre à de nombreuses questions de type « et si » à partir des mêmes données. C'est le genre de fonctionnalité qui transforme les agents d'interfaces de chat en outils opérationnels.
Il démystifie également le récit ridicule selon lequel « l’IA tuera les logiciels ». « Certaines personnes ont dit que l'IA allait signifier la fin des logiciels, la fin des sociétés d'outils », a déclaré Huang. « C'est exactement le contraire. » Je suis d'accord. Les agents ont besoin de simulateurs, de solveurs et de bases de données, et les entreprises qui possèdent ces outils gagnent en valeur lorsqu'elles les proposent aux agents.
Les opérateurs télécoms devraient devenir la couche d'IA distribuée
Huang a également fait une prédiction audacieuse en matière de télécommunications. « Chaque entreprise de télécommunications du futur, avec 100 000 sites représentant quelque 100 gigawatts de stations de base et de centres de données de télécommunications distribuées, évoluera vers un réseau d'IA distribué », a-t-il déclaré.
Les chiffres européens soutiennent la thèse. Environ 20 % des centres de données européens appartiennent à des opérateurs de télécommunications, et il existe plus de 1 500 installations de télécommunications susceptibles d'héberger des GPU. J'ai déjà vu des opérateurs rechercher l'Edge Computing, et l'Edge Computing multi-accès n'a jamais été livré. La différence réside désormais dans une véritable charge de travail d'inférence, ainsi que dans la possibilité d'exécuter le réseau radio lui-même sur la même plate-forme, comme l'ont démontré T-Mobile et Nokia avec le premier appel AI-RAN sur un réseau commercial.
L’IA physique renforce le dossier. Les robots géreront la perception à bord, mais devront parfois « appeler un ami » sur un serveur sur site, un site de télécommunication périphérique ou le cloud. Ce modèle hybride convient bien aux opérateurs, à condition qu’ils puissent développer les capacités de commercialisation nécessaires pour le vendre.
L’IA physique n’est plus non plus un projet scientifique pour Nvidia. La société a déclaré que les revenus de l’IA physique ont atteint près de 11 milliards de dollars au premier semestre 2026, soit environ 30 % de plus que pour l’ensemble de l’année dernière. L’Europe, avec sa base de fabrication de précision et son Mittelstand de fabricants de taille moyenne, a le plus à gagner maintenant que la technologie est suffisamment performante pour les entreprises ne disposant pas d’équipes de robotique internes.
Comme mentionné, les opérateurs télécoms ont déjà eu l’occasion d’augmenter leur valeur pour leurs clients. Le cloud, le mobile et Internet ont permis aux opérateurs de télécommunications d’être autre chose qu’une marchandise, mais ils ont échoué. Cependant, cette fois, Nvidia les aide à opérer ce changement, et les avantages pour Nvidia sont élevés si les opérateurs télécoms réussissent.
Réflexions finales
Nvidia décrit son approche comme optimisée verticalement mais ouverte horizontalement, ce qui signifie que les clients peuvent utiliser autant ou aussi peu de pile qu'ils le souhaitent. Berlin a montré jusqu'où la partie verticale s'étend désormais, de la logistique des conteneurs et de l'intégration du réseau à la sécurité des agents et aux modèles de données structurés. Plus Nvidia fournit de pile, plus cette promesse d'ouverture sera testée, et les acheteurs devraient obliger l'entreprise à respecter cette promesse.
Mais le point stratégique a été fait. Les concurrents de Nvidia sont encore largement en concurrence sur les puces, tandis que Nvidia est de plus en plus en concurrence sur le temps pour générer des revenus, soutenu par une base installée où les GPU Volta de 2019 sont toujours au service des clients. Pour les responsables de l’information et les opérateurs pesant des investissements de plusieurs milliards de dollars en IA, cette durabilité, combinée à un délai d’obtention plus rapide du premier jeton, est un argument plus difficile à battre que n’importe quelle référence.
Zeus Kerravala est analyste principal chez ZK Research, une division de Kerravala Consulting. Il a écrit cet article pour SiliconANGLE.
