Le marché du néocloud est en train de dépasser ses origines en tant que palliatif aux rares unités de traitement graphique. Les startups natives de l'IA choisissent désormais leur infrastructure en fonction de la latence, de la capacité de rafale et de l'ouverture, et pas seulement de la disponibilité des puces.
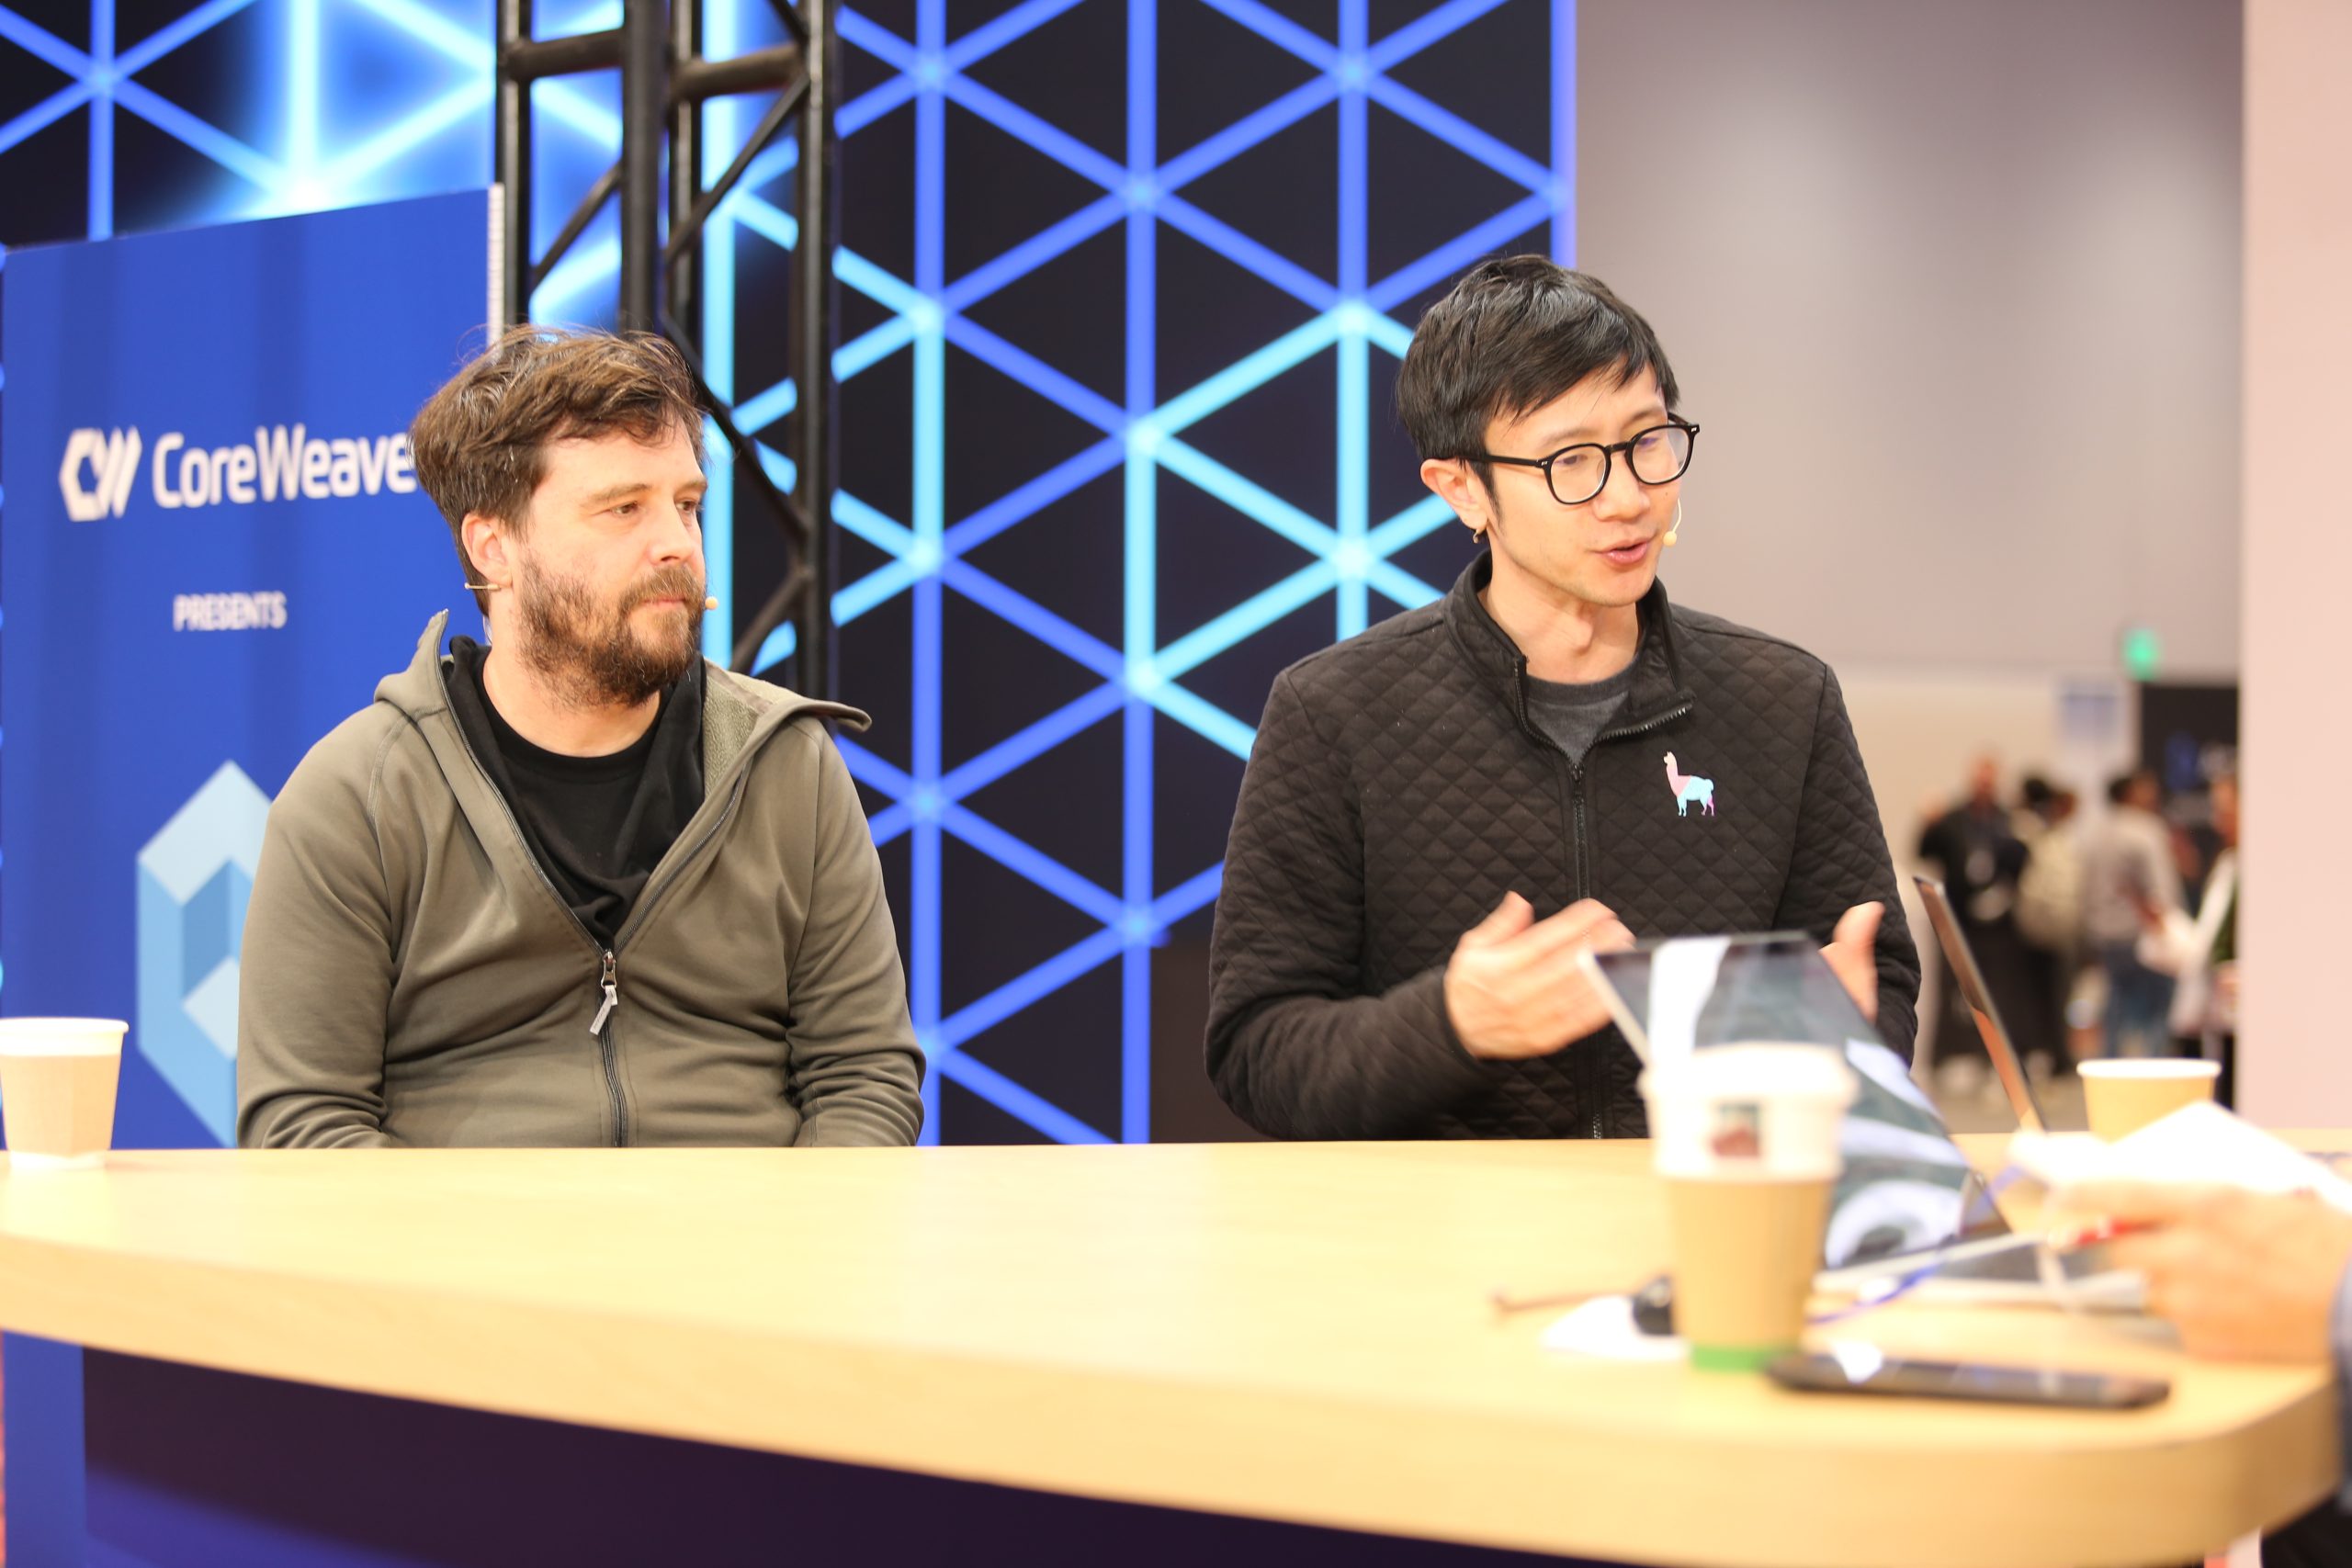
Ce changement se produit chez CoreWeave Inc., qui s'étend au-delà du calcul GPU vers les réseaux, le stockage et les logiciels à mesure que la demande d'inférence augmente. Dans le même temps, LlamaIndex Inc. est passé d'un framework open source pour la génération augmentée par récupération à un constructeur de modèles qui loue son calcul plutôt que de le posséder, selon Jerry Liu (photo de droite), co-fondateur et PDG de LlamaIndex.
« Nous sommes actuellement en fait un laboratoire d'IA spécialisé qui se concentre uniquement sur la création de modèles pour l'analyse et l'extraction de documents. Nous post-entraînons des modèles à poids ouvert, nous rassemblons nos propres ensembles de données et nous le rendons vraiment très efficace dans l'analyse et la lecture de documents pour extraire essentiellement ces données », a déclaré Liu. « Nous nous soucions beaucoup de pouvoir réellement adapter tout ce que nous faisons à la frontière Pareto des performances, des coûts et de la latence pour nos clients. »
Liu et Lukas Biewald (à gauche), vice-président senior des initiatives d'IA chez CoreWeave, se sont entretenus avec John Furrier et Dave Vellante de Fully Connected, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté des agents de longue date, de la gouvernance et des raisons pour lesquelles les startups natives de l'IA se tournent vers des cloud spécialisés pour les charges de travail lourdes d'inférence. (* Divulgation ci-dessous.)
Pourquoi les charges de travail d'IA en rafale favorisent le modèle néocloud
L'empreinte informatique de LlamaIndex existait à peine il y a un an. Aujourd'hui, sa charge de travail comprend environ 75 % d'inférence et 25 % de formation, et elle traite des millions de pages de documents par jour pour des clients financiers, juridiques et d'assurance dont les documents arrivent en rafale, selon Liu. La société ne possède aucun cluster GPU, la capacité garantie est donc plus importante que la propriété du matériel.
« Nous servons de nombreux clients différents avec des charges de travail extrêmement persistantes et pointues », a déclaré Liu. « Nous devons vraiment, vraiment nous assurer que nous avons la bonne capacité pour servir nos clients sans être limités. »
CoreWeave parie que la capacité à elle seule ne constitue pas un différenciateur. Biewald a rejoint l'entreprise grâce à l'acquisition de Weights & Biases, la startup d'observabilité de l'IA qu'il a cofondée, et CoreWeave a profité de l'événement pour lancer CoreWeave Forge, une couche de développement qui gère la formation, l'inférence, l'évaluation et le développement d'agents dans un environnement connecté. Venant du logiciel, il s'est d'abord demandé dans quelle mesure la configuration des puces pouvait réellement avoir de l'importance, a noté Biewald.
« Je vais vous le dire, la réponse est » une énorme différence « », a déclaré Biewald. « Je parle d'une différence d'ordres de grandeur en fonction de la manière dont vous effectuez la mise en réseau des puces (et) de la manière dont vous effectuez la distribution d'énergie. »
L'ouverture distingue également CoreWeave des hyperscalers, selon Biewald. Alors que des fournisseurs tels qu'Amazon Web Services Inc. s'appuient sur des interfaces de programmation d'applications propriétaires qui rendent les charges de travail difficiles à déplacer, CoreWeave suit les protocoles réseau standard recommandés par Nvidia Corp., qui apportent une prise en charge open source plus large. Les analystes ont observé que CoreWeave élargit son portefeuille tout comme AWS l'a fait à ses débuts, même si l'entreprise se hérisse du label néocloud.
« CoreWeave sait que tout le monde vient d'un cloud différent », a déclaré Biewald. « Tout le monde va héberger son service Web sur AWS ou GCP, pas sur CoreWeave. CoreWeave est d'accord avec cela, donc CoreWeave fonctionne beaucoup mieux avec les autres cloud. »
Cet écosystème laisse présager un changement plus important quant à la responsabilité de construire des renseignements, a noté Liu. La post-formation sur un petit modèle à poids ouvert reste aujourd'hui une compétence limitée à un groupe restreint de spécialistes. Une capacité néocloud abondante, combinée à des agents de codage en amélioration rapide, pourrait ouvrir ce travail à beaucoup plus de personnes.
« Tout le monde commence à devenir vraiment doué pour définir l'observabilité, les évaluations et les bonnes mesures sur lesquelles se concentrer », a déclaré Liu. « Je pense qu'il y aura un monde dans lequel nous allons simplement automatiser toute cette boucle et la rendre accessible à tout le monde. »
Voici l'interview vidéo complète, qui fait partie de la couverture de Fully Connected par SiliconANGLE et theCUBE :
(* Divulgation : TheCUBE est un partenaire média payant pour l'événement Fully Connected 2026. Ni CoreWeave, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
