La mémoire des agents IA crée de nouvelles demandes sur l'infrastructure, car les agents exécutent des sessions plus longues et se répartissent dans toute l'entreprise. Conserver ce contexte et le rendre disponible en cas de besoin exerce une pression sur la capacité de mémoire et le mouvement des données.
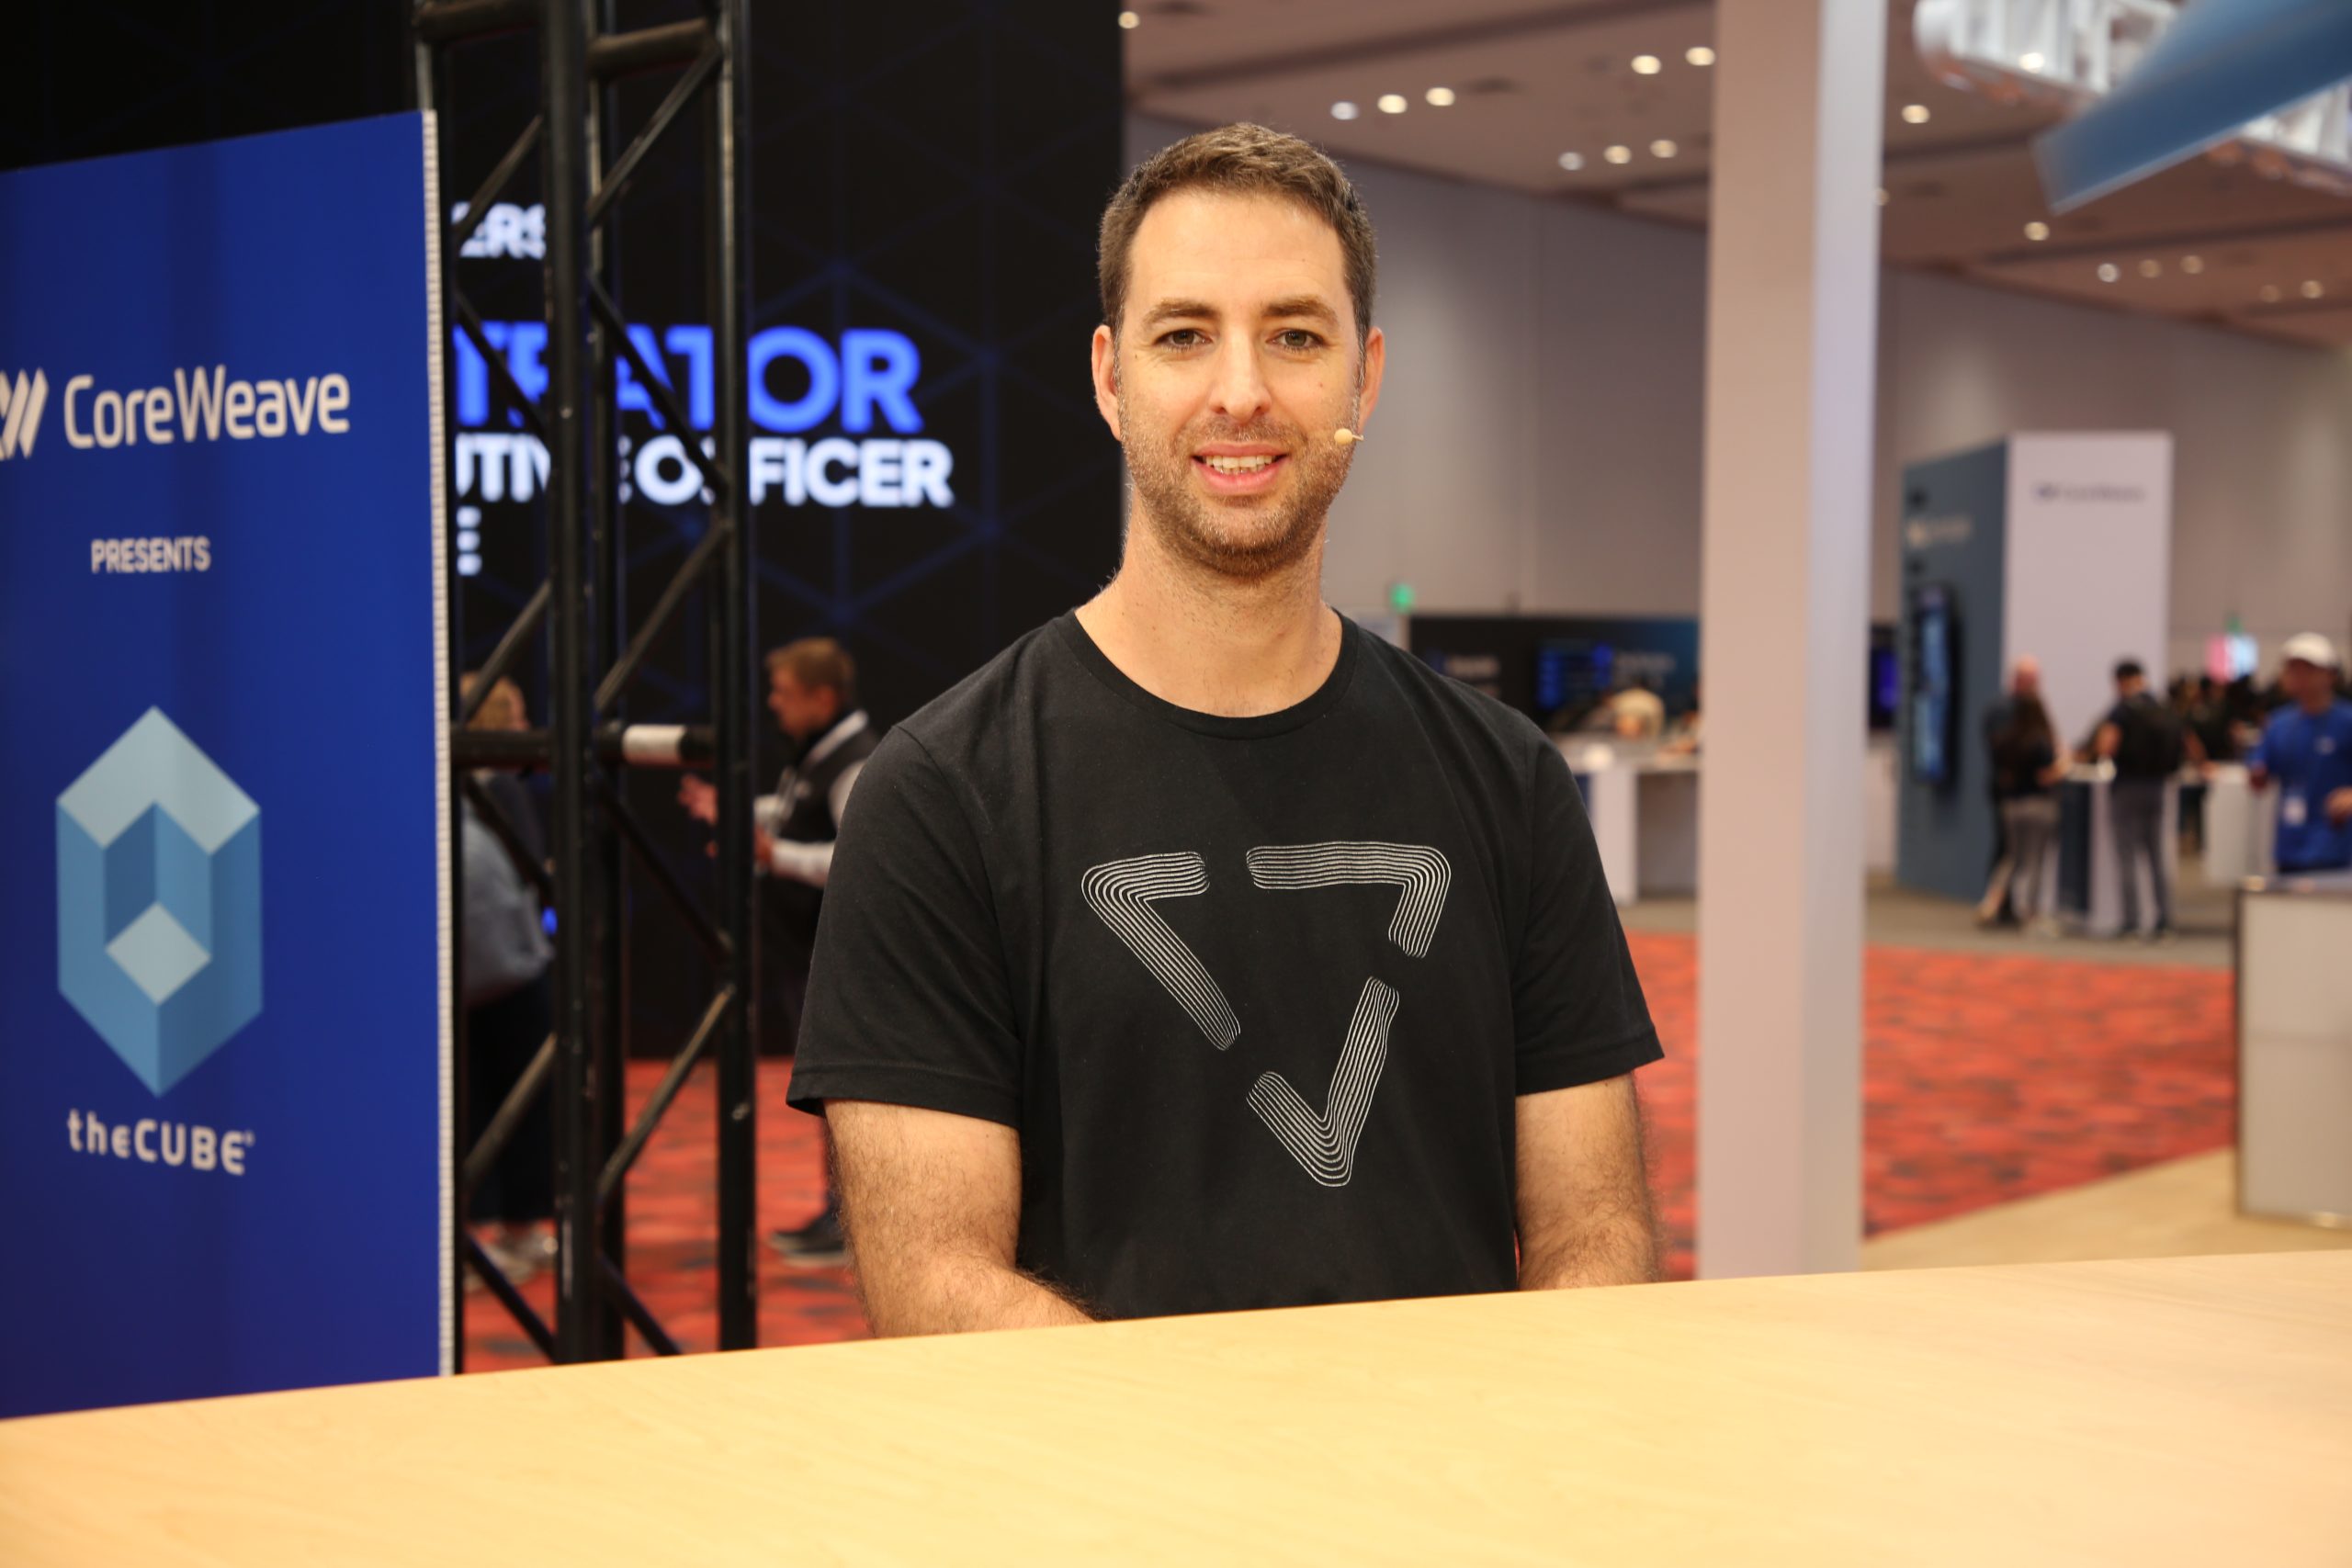
Ces exigences s’étendent au-delà du contexte d’une interaction individuelle. Les agents d'entreprise ont également besoin de connaissances partagées qui persistent au fil des sessions, selon Alon Horev, (photo) co-fondateur et directeur de la technologie de Vast.
« La mémoire des agents est un peu différente », a déclaré Horev. « Tout d'abord, il existe plusieurs types de mémoire. Il existe une mémoire à long terme dans laquelle un agent peut voir des conversations et des interactions passées, regarder en arrière et apprendre de ses expériences passées. »
Horev s'est entretenu avec John Furrier et Dave Vellante de theCUBE Research à Fully Connected 2026, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de la mémoire des agents IA, du déchargement du cache des valeurs clés et du passage au mouvement des données comme prochain goulot d'étranglement. (* Divulgation ci-dessous.)
Pourquoi la mémoire des agents IA va au-delà du GPU
La pression apparaît en premier dans l'inférence. Chaque session de longue durée conserve son cache KV dans la mémoire de l'unité de traitement graphique, et une session d'un demi-million de jetons peut occuper un dixième à un vingtième de la mémoire d'un GPU, a expliqué Horev.
« Il est également possible que l'agent arrête de parler au (grand modèle de langage) parce qu'il compile du code, teste un logiciel ou, en tant qu'humain, je veux prendre une tasse de café », a-t-il déclaré. « Ce que vous voyez, c'est que si vous pouviez étendre ce mur de mémoire et transférer ces sessions vers le stockage, vous pouvez éviter ce recalcul répété. »
L'approche de Vast utilise la mémoire par niveaux. La mémoire GPU est utilisée en premier, puis la mémoire de l'unité centrale de traitement sur la même machine, puis les supports persistants pouvant contenir des pétaoctets de cache KV, le logiciel Dynamo de Nvidia Corp. orchestrant le processus, a noté Horev.
« Vous pouvez déplacer une session d'un GPU occupé vers un GPU moins occupé et déplacer le cache KV soit sur le réseau, soit le lire depuis Vast », a-t-il déclaré. « Une fois que vous considérez l'inférence comme un problème distribué où vous avez la possibilité d'utiliser la mémoire GPU, la mémoire CPU et Vast sur un parc de machines, vous disposez de plus d'options et d'une planification plus optimisée. »
Les enjeux augmentent à mesure que les entreprises déploient des milliers d'agents qui traitent des données sensibles et agissent au nom des clients. Ces entreprises doivent enregistrer tout ce que font leurs agents et le conserver pendant une période définie, ce qui fait de la mémoire des agents IA à la fois un atout de gouvernance et de performance, selon Horev. Vast a également lancé un service informatique confidentiel pour les charges de travail sensibles.
« Ces conversations que fait l'agent, c'est aussi de l'or », a-t-il déclaré. « Il s'agit des mêmes informations qu'il peut utiliser pour affiner, former ou créer des modèles spécialement conçus. »
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE de Fully Connected 2026 :
(* Divulgation : TheCUBE est un partenaire média payant pour l'événement Fully Connected. Ni CoreWeave, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
