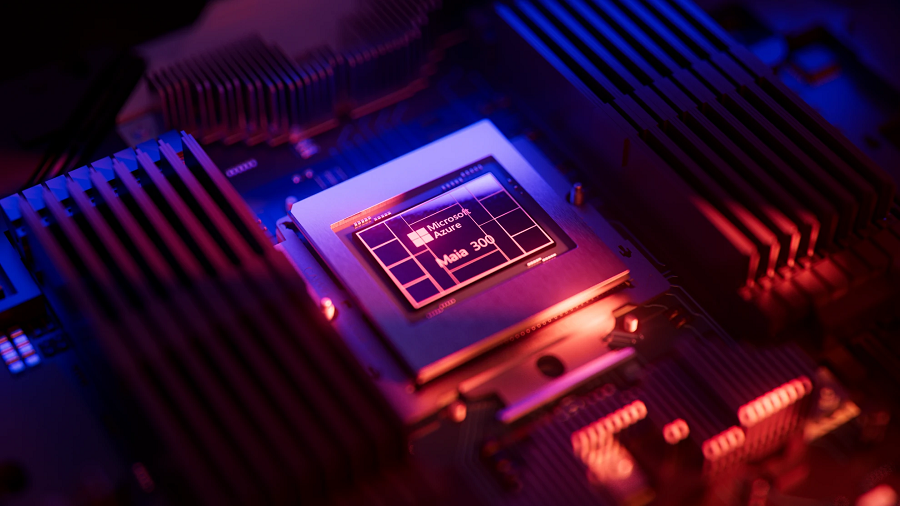
Microsoft Corp. a levé aujourd'hui les rideaux sur Maia 300, son tout dernier accélérateur d'intelligence artificielle développé en interne.
La puce est optimisée pour l'inférence, le processus de génération de réponses aux requêtes de l'IA. Microsoft estime qu'il peut traiter 40 % de jetons en plus par mégawatt que les « principaux systèmes basés sur GPU », ce qui est probablement une référence aux produits de Nvidia Corp. La société a déclaré que la série de puces Maia deviendra sa principale source de capacité d'inférence au fil du temps.
Maia 300 comprend quatre puces informatiques fabriquées à l'aide du dernier nœud de deux nanomètres de Taiwan Semiconductor Manufacturing Co. Les chipsets sont flanqués de huit modules HBM4 d'une capacité combinée de 288 Go, soit la même quantité que l'accélérateur phare Rubin de Nvidia Corp. Cependant, Maia 300 a environ 20 % de bande passante mémoire en moins que Rubin. La bande passante mémoire est une mesure de la vitesse à laquelle les données peuvent être transférées vers et depuis la RAM.
Les puces d'IA effectuent généralement des inférences en déplaçant de manière répétée des données entre leurs circuits informatiques et leurs circuits de mémoire. Ce mouvement constant ralentit le traitement. Selon Microsoft, Maia 300 présente une architecture de flux de données conçue pour minimiser les mouvements de données. Lorsque cela est possible, les chipsets informatiques conservent les informations dans un cache SRAM interne au lieu de les envoyer aux piles HBM.
Dans les situations où l'utilisation de HBM ne peut être évitée, les chipsets informatiques du Maia 300 envoient des données à une pile mémoire physiquement proche. C'est plus rapide que de transmettre des informations à une pile HBM à l'autre extrémité de la puce. Pour plus de mesure, Maia 300 compresse les données dans des formats légers tels que MXFP4. La taille réduite de ces formats permet aux données de circuler plus rapidement à l'intérieur de la puce.
« Des représentations plus étroites réduisent l'empreinte mémoire et le mouvement des données, permettant au système de prendre en charge des modèles plus grands, des contextes plus longs et davantage de sessions simultanées au sein de la même enveloppe de puissance », ont écrit les dirigeants de Microsoft, Rani Borkar et Saurabh Dighe, dans un communiqué. article de blog.
Les modules de calcul et de mémoire du Maia 300 sont pris en charge par ce que Microsoft appelle un chiplet de contrôle de périphérique. Il gère le flux d'énergie vers les composants centraux du processeur, collecte la télémétrie et effectue d'autres tâches de support. Il existe également deux autres chipsets auxiliaires qui gèrent le mouvement des données entrant et sortant de l'accélérateur.
Microsoft prévoit de déployer Maia 300 dans des plateaux dotés chacun de quatre accélérateurs. Ces plateaux, à leur tour, seront placés dans des racks refroidis par liquide comportant un total de 96 accélérateurs. Microsoft s'attend à ce que les racks fournissent environ sept fois le débit de jetons d'un système équipé de sa puce Maia 200 de génération précédente. La société a lancé ce dernier accélérateur en janvier et l’utilise déjà en production.
Microsoft a l'intention de regrouper ses racks Maia 300 en superpods avec un total de 12 288 accélérateurs. Les puces individuelles seront reliées entre elles à l’aide d’une pile réseau Ethernet personnalisée. Le réseau peut ajuster la quantité de bande passante allouée au trafic dans le rack et la quantité disponible pour les communications entre racks, ce qui lui permet d'adapter sa configuration à chaque charge de travail. Le résultat est une performance accrue.
Habituellement, les puces échangent des données différemment selon qu'elles se trouvent dans le même rack ou dans des racks différents. Par conséquent, pour basculer entre les deux modes de mise en réseau, ils doivent utiliser l'unité centrale de traitement du serveur hôte ou une puce réseau autonome. Maia 300, en revanche, utilise la « même sémantique de communication » pour les deux tâches. Cela supprime le besoin de matériel supplémentaire et rend ainsi les clusters plus efficaces.
« Les tâches peuvent utiliser la capacité au-delà des limites des racks, réduisant ainsi les accélérateurs bloqués lorsque les tailles de charge de travail ne correspondent pas à la configuration physique du rack », ont expliqué Borkar et Dighe.
Microsoft prévoit de commencer à déployer Maia 300 en production l'année prochaine. La société s'attend à ce que son silicium personnalisé alimente une capacité de calcul d'IA d'une valeur de plusieurs gigaoctets.
