Au cours des deux dernières années, les investissements des entreprises dans l’IA ont été dominés par un seul sujet : le calcul. Les organisations se sont précipitées pour sécuriser les allocations de GPU, ont négocié des accords d’infrastructure et ont rapidement mis en place des plates-formes d’apprentissage automatique. Ce que beaucoup ont découvert seulement après coup, c’est que le goulot d’étranglement qu’ils pensaient résoudre n’était pas le seul dans la pièce. Le stockage limite désormais les accélérateurs mêmes que les entreprises se sont battus pour acquérir.
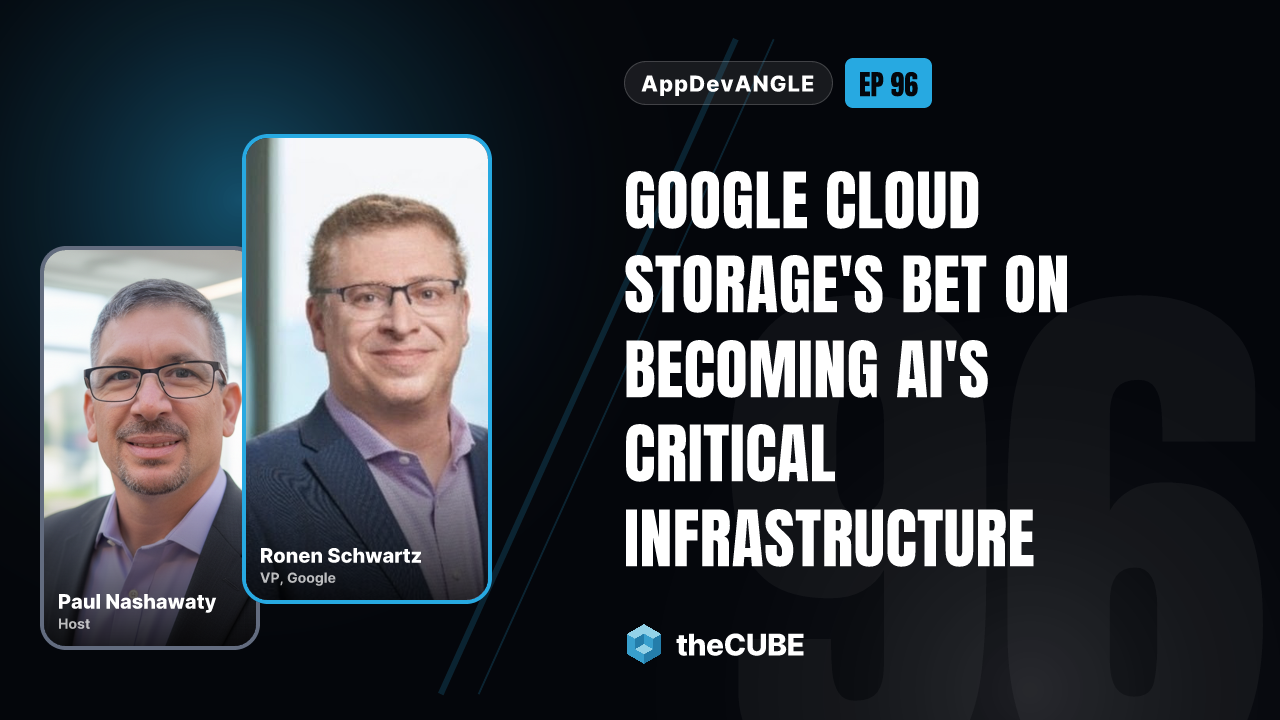
Dans le dernier épisode du podcast AppDevANGLE, j'ai discuté avec Ronen Schwartz, vice-président des produits pour Google Cloud Storage chez Google LLC, des raisons pour lesquelles le stockage est discrètement devenu la contrainte déterminante dans l'infrastructure d'IA d'entreprise et à quoi ressemble réellement une architecture spécialement conçue pour les charges de travail d'IA. La conversation aborde un problème réel, mesurable et encore largement sous-estimé dans la plupart des discussions sur la stratégie de l’IA.
« Le stockage vient d'être promu », a déclaré Schwartz. « Au lieu d'être un catalyseur en arrière-plan, il passe au premier plan en tant qu'élément essentiel de l'exécution de l'accélérateur. »
La taxe cachée sur l'investissement GPU
Les aspects économiques de ce problème sont directs. Les accélérateurs sont, comme le dit Schwartz, l'élément le plus coûteux d'une entreprise. Chaque seconde passée à attendre des données est une perte d’argent – non pas dans un calcul d’efficacité théorique, mais dans un gaspillage immédiat et traçable. Pourtant, lorsque les équipes ont enfin accès à leurs TPU ou GPU, le chemin de transmission des données n'a souvent pas reçu la même attention que la couche de calcul.
« Je parle à de nombreux clients, et ce que j'entends, c'est que l'équipe a passé beaucoup de temps à se battre pour obtenir ses TPU, ses GPU, pour mettre la main sur des accélérateurs. Et une fois qu'ils les ont obtenus, ils ne sont pas toujours en mesure d'obtenir le résultat dont ils avaient besoin. Très souvent, cela est dû à un manque de réflexion sur le chemin de livraison des données. «
Il ne s’agit pas d’un scénario marginal. Schwartz a décrit un modèle selon lequel les organisations identifient le goulot d'étranglement du stockage seulement après qu'il l'ait atteint, lorsque les mesures d'utilisation du GPU ne répondent pas aux objectifs et que les délais de formation dépassent les prévisions. D’ici là, le coût du sous-investissement dans l’architecture de stockage est déjà intégré au projet.
Formation, inférence et agents : trois problèmes de stockage distincts
L’un des enseignements les plus clairs de la conversation est que l’IA n’est pas une charge de travail unique et que la traiter comme telle crée des lacunes croissantes dans l’architecture de stockage. Schwartz a décrit les charges de travail de formation, d'inférence et d'agent comme ayant des « battements de cœur » fondamentalement différents avec des modèles de mouvement de données distincts qui nécessitent chacun une conception ciblée.
La formation exige des lectures séquentielles massives, mais le point de pression tout aussi critique est la gestion des points de contrôle. Toutes les 15 minutes environ, un cluster de formation doit s'arrêter et écrire un point de contrôle de plusieurs téraoctets pour protéger le travail effectué contre une défaillance potentielle. « Un stockage lent à cet endroit gèle l'ensemble du cluster GPU », a déclaré Schwartz. La technologie de stockage objet Rapid de Google, a-t-il noté, peut écrire des points de contrôle plus de trois fois plus rapidement et les restaurer plus de cinq fois plus rapidement que le stockage objet standard, et cette distinction est très importante à grande échelle. Il a cité comme exemple Torin, une entreprise de véhicules autonomes : des millions de points de données de capteurs sont stockés pour former des modèles de véhicules, où les performances des points de contrôle ne sont pas un cas limite mais une exigence opérationnelle essentielle.
L'inférence introduit une contrainte totalement différente, celle de l'interaction en temps réel, sensible à la latence, où le temps de réponse affecte directement l'expérience utilisateur et l'économie des jetons. Les charges de travail agentiques s'ajoutent à un troisième ensemble d'exigences : espaces de travail partagés, persistance de l'état entre les agents, récupération à faible latence et nécessité de prendre en charge les processus d'agent de courte durée et de longue durée qui peuvent hiberner et se réactiver à la demande.
« L'IA n'est pas une seule charge de travail. En réalité, le mouvement des données est complètement différent. C'est comme des battements de cœur différents selon l'endroit où vous vous situez dans le cycle de vie. »
Architecture dérivée de Colossus comme infrastructure d'entreprise
L'argument de différenciation de Google se concentre sur la crédibilité de l'infrastructure construite au fil des années d'exécution de charges de travail d'IA à grande échelle en interne avant d'offrir les mêmes capacités en externe. Schwartz a cité des chiffres de performances spécifiques : 15 téraoctets par seconde sur le stockage d'objets Rapid et 10 téraoctets par seconde sur les clusters gérés par Google Cloud, qu'il a décrits comme des chiffres vérifiés parmi les meilleurs du secteur.
La base technique comprend la colocalisation zonale ou le placement des données physiquement à proximité des clusters GPU et TPU pour minimiser le temps de trajet d'un octet vers l'accélérateur. Schwartz a décrit cela comme une première fonctionnalité sur le marché qui nécessitait de repenser les hypothèses inhérentes à la conception du stockage traditionnel, où la distribution multizone ou multirégion était l'objectif par défaut. Pour les charges de travail d’IA, la proximité de l’accélérateur est prioritaire. La technologie Rapid Bucket de Google réduit les étapes de traitement dans le chemin de stockage, permettant à un seul bucket de fournir un débit de plus de 15 téraoctets par seconde avec la prise en charge de 20 millions de requêtes par seconde avec une latence inférieure à la milliseconde.
« C'est parce qu'il est construit sur l'infrastructure de Google, qui est utilisée en interne depuis plus longtemps que quiconque pour prendre en charge les accélérateurs et leurs performances. Mais c'est aussi parce que Google travaille avec neuf des dix principales entreprises mondiales de modèles pionniers en matière d'IA. » Une architecture de stockage qui peut manifestement améliorer l’utilisation du GPU peut fournir une itération plus rapide grâce à moins de calculs inactifs et à un coût effectif inférieur par exécution de formation.
Rendre les données non structurées prêtes pour les agents
La dimension agentique de la conversation a révélé un problème sous-estimé dans l’état de préparation de l’entreprise à l’IA. Les agents nécessitent bien plus que de la navigation sur le Web et des requêtes de base de données ; ils ont besoin d'accéder à des données non structurées à grande échelle, notamment des images, des vidéos, des documents et des PDF qui représentent l'essentiel des actifs de données réels de la plupart des organisations. Sans moyen de rendre ce contenu sémantiquement accessible, les agents opèrent avec une vision restreinte et souvent non représentative des connaissances de l'entreprise.
La réponse de Google est ce que Schwartz a appelé une initiative de stockage intelligent, ancrée par une capacité d'enrichissement d'objets récemment lancée. Lorsqu'un fichier ou une image arrive dans un bucket de stockage, les modèles d'IA de Google extraient automatiquement le contenu et attachent des métadonnées structurées à l'objet, en quelques secondes et à grande échelle. Le résultat est que ce qui n’était auparavant pas structuré devient interrogeable par les agents sans intervention manuelle ni pipelines de traitement en aval.
« Un agent peut désormais interagir avec ce qu’on appelait autrefois des données non structurées car il a en réalité une très bonne compréhension du contenu. » La couche de stockage est également intégrée au cloud de données agentiques plus large de Google et à l'architecture Lakehouse sans frontières, permettant aux agents d'accéder également aux données stockées en dehors de l'environnement de Google.
Pour l'infrastructure d'agents à grande échelle, Schwartz a décrit des volumes d'agents Filestore dédiés intégrés directement dans Google Kubernetes Engine et l'environnement sandbox d'agent, conçus spécifiquement pour gérer les exigences de coût, de vitesse de réponse et de partage de données liées à l'exécution simultanée de milliers ou de millions d'agents.
Google Cloud Storage pour l'IA : l'essentiel
Le changement plus large du marché ici est architectural et non progressif. L'infrastructure d'IA d'entreprise a été construite en couches (le calcul d'abord, puis les frameworks, puis les données) et le stockage était souvent traité comme une case à cocher d'approvisionnement plutôt que comme une variable de performance. Ce séquençage s’avère coûteux. Alors que les objectifs d'utilisation des GPU deviennent des KPI mesurables et que les budgets des opérations d'IA sont soumis à un examen plus strict, la couche de stockage est réévaluée comme elle ne l'a pas été depuis des années.
Ce que la position de Google illustre, c'est que l'expérience opérationnelle à grande échelle au niveau de la couche de stockage se traduit directement par un avantage pour l'entreprise, non pas comme une affirmation marketing, mais comme une différence mesurable dans la vitesse des points de contrôle, le débit, la latence et la réactivité des agents. Les entreprises qui ont mené des formations et des inférences sur des modèles frontières à grande échelle ont été contraintes de résoudre ces problèmes ; les équipes d'entreprise les rencontrent désormais pour la première fois.
Pour les ingénieurs de plateforme, les équipes d’infrastructure ML et les architectes d’entreprise, l’implication est spécifique : les décisions d’architecture de stockage prises lors de la création initiale de la plateforme d’IA limiteront ou permettront les performances de chaque charge de travail qui suivra. Revoir ces décisions après l’apparition du goulot d’étranglement coûte beaucoup plus cher que de les aborder lors de la phase de conception.
Le marché se dirige vers un point où les conversations sur l’infrastructure de l’IA incluent systématiquement le stockage comme niveau principal, et non comme une réflexion secondaire. Les organisations qui reconnaissent ce changement dès le début tireront nettement plus de valeur des investissements en accélérateurs qu’elles ont déjà réalisés.
Pour entendre la conversation complète avec Ronen Schwartz, consultez le dernier épisode du podcast AppDevANGLE. Pour en savoir plus sur la façon dont Stockage Google Cloud peut prendre en charge l'évolution des demandes de l'IA d'entreprise, explorez Les solutions de stockage de Google ou connectez-vous à Google Cloud équipe pour discuter de la bonne approche pour les charges de travail de votre organisation.
Voici l'interview complète de theCUBE Research avec Ronen Schwartz de Google :
