Amazon.com Inc. aujourd'hui introduit TorchNeuron, une boîte à outils open source qui permet aux développeurs d'exécuter des charges de travail PyTorch sur ses puces AWS Trainium.
PyTorch est le framework de développement d'intelligence artificielle le plus populaire du secteur. Jusqu'à présent, l'exécution de projets d'IA alimentés par l'outil sur des instances Amazon Web Services basées sur Trainium impliquait une quantité importante de travail manuel. Cela a augmenté les coûts de développement et a ainsi créé une barrière à l’entrée pour les utilisateurs.
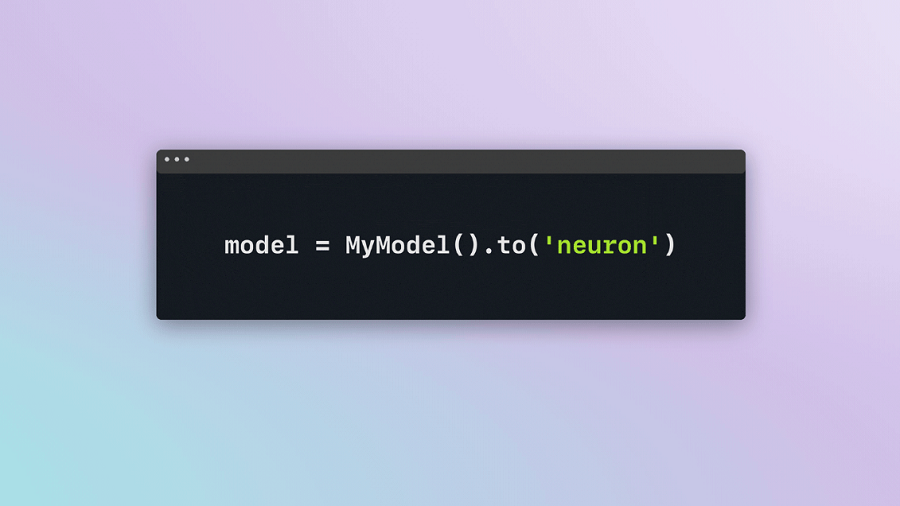
TorchNeuron permet d'exécuter des projets PyTorch sur des puces Trainium sans modifications importantes du code. Selon Amazon, les développeurs doivent uniquement configurer un paramètre qui indique aux charges de travail quelle puce elles doivent utiliser. TorchNeuron prend en charge Trainium2 et Trainium3, les deux derniers ajouts à la série d'accélérateurs. Les puces prennent en charge les cas d'utilisation de formation et d'inférence.
Trainium3, le plus performant des deux processeurs, dispose de huit cœurs de calcul. Chaque noyau comprend quatre modules, chacun optimisé pour un sous-ensemble différent de calculs avec lesquels les modèles d'IA traitent les données. La puce conserve les données du modèle dans un pool de mémoire intégrée de 154 Go.
AWS exécute Trainium3 sur des serveurs personnalisés pouvant chacun accueillir jusqu'à 144 accélérateurs. Selon l'unité Amazon, un seul système peut effectuer jusqu'à 362 quadrillions de calculs par seconde lors du traitement de données au format MXFP8. Le format est largement utilisé par les modèles d'IA.
La série Trainium propose un langage de programmation personnalisé appelé NKI. La syntaxe, fournie avec son propre compilateur, permet aux développeurs d'optimiser de bas niveau leurs modèles d'IA. De telles personnalisations réduisent l'utilisation du matériel des modèles d'IA et augmentent leur vitesse.
TorchNeuron comprend un ensemble d'opérateurs NKI préemballés, des éléments de base logiciels que les clients peuvent utiliser pour développer des modèles d'IA. Certains opérateurs facilitent la mise en œuvre d'une architecture mixte d'experts, tandis que d'autres sont conçus pour réduire l'utilisation de la mémoire des réseaux neuronaux. Ils accélèrent également les tâches connexes telles que quantification.
TorchNeuron prend en charge non seulement PyTorch, mais également les outils open source que les équipes logicielles utilisent souvent parallèlement au framework. La liste des outils pris en charge comprend TorchTitan, un moteur de formation d'IA populaire. Il automatise une partie du travail impliqué dans la distribution d’une formation sur les accélérateurs.
TorchTitan répartit les charges de travail entre les puces à l'aide d'une méthode appelée parallélisme de données entièrement fragmentées. Il divise non seulement le modèle en cours d'entraînement, mais également les états et les gradients de l'optimiseur. Un optimiseur est un programme qui affine les capacités d'un modèle, tandis que les dégradés sont des fichiers qui jouent un rôle important dans ce processus. Selon Amazon, TorchNeuron inclut des fonctionnalités qui permettent aux développeurs d'optimiser davantage le flux de travail de formation à l'aide des puces Trainium.
La boîte à outils a déjà été adoptée par plusieurs clients AWS. Cartesia AI Inc., une startup d'agents vocaux financée par du capital-risque, utilise TorchNeuron pour exécuter des charges de travail d'inférence sur les puces Trainium. L’Institut Lieber pour le développement du cerveau étudie les moyens d’optimiser ses flux de travail de recherche médicale basés sur l’IA.
Amazon prévoit d'ouvrir TorchNeuron mardi, premier jour d'une conférence PyTorch de deux jours à San Jose.
