L’inférence de l’IA est en train de devenir la charge de travail qui décide de l’économie du boom de l’IA. La formation a construit la première vague de cloud GPU, mais la fourniture de modèles plus rapides et moins chers définira la suivante.
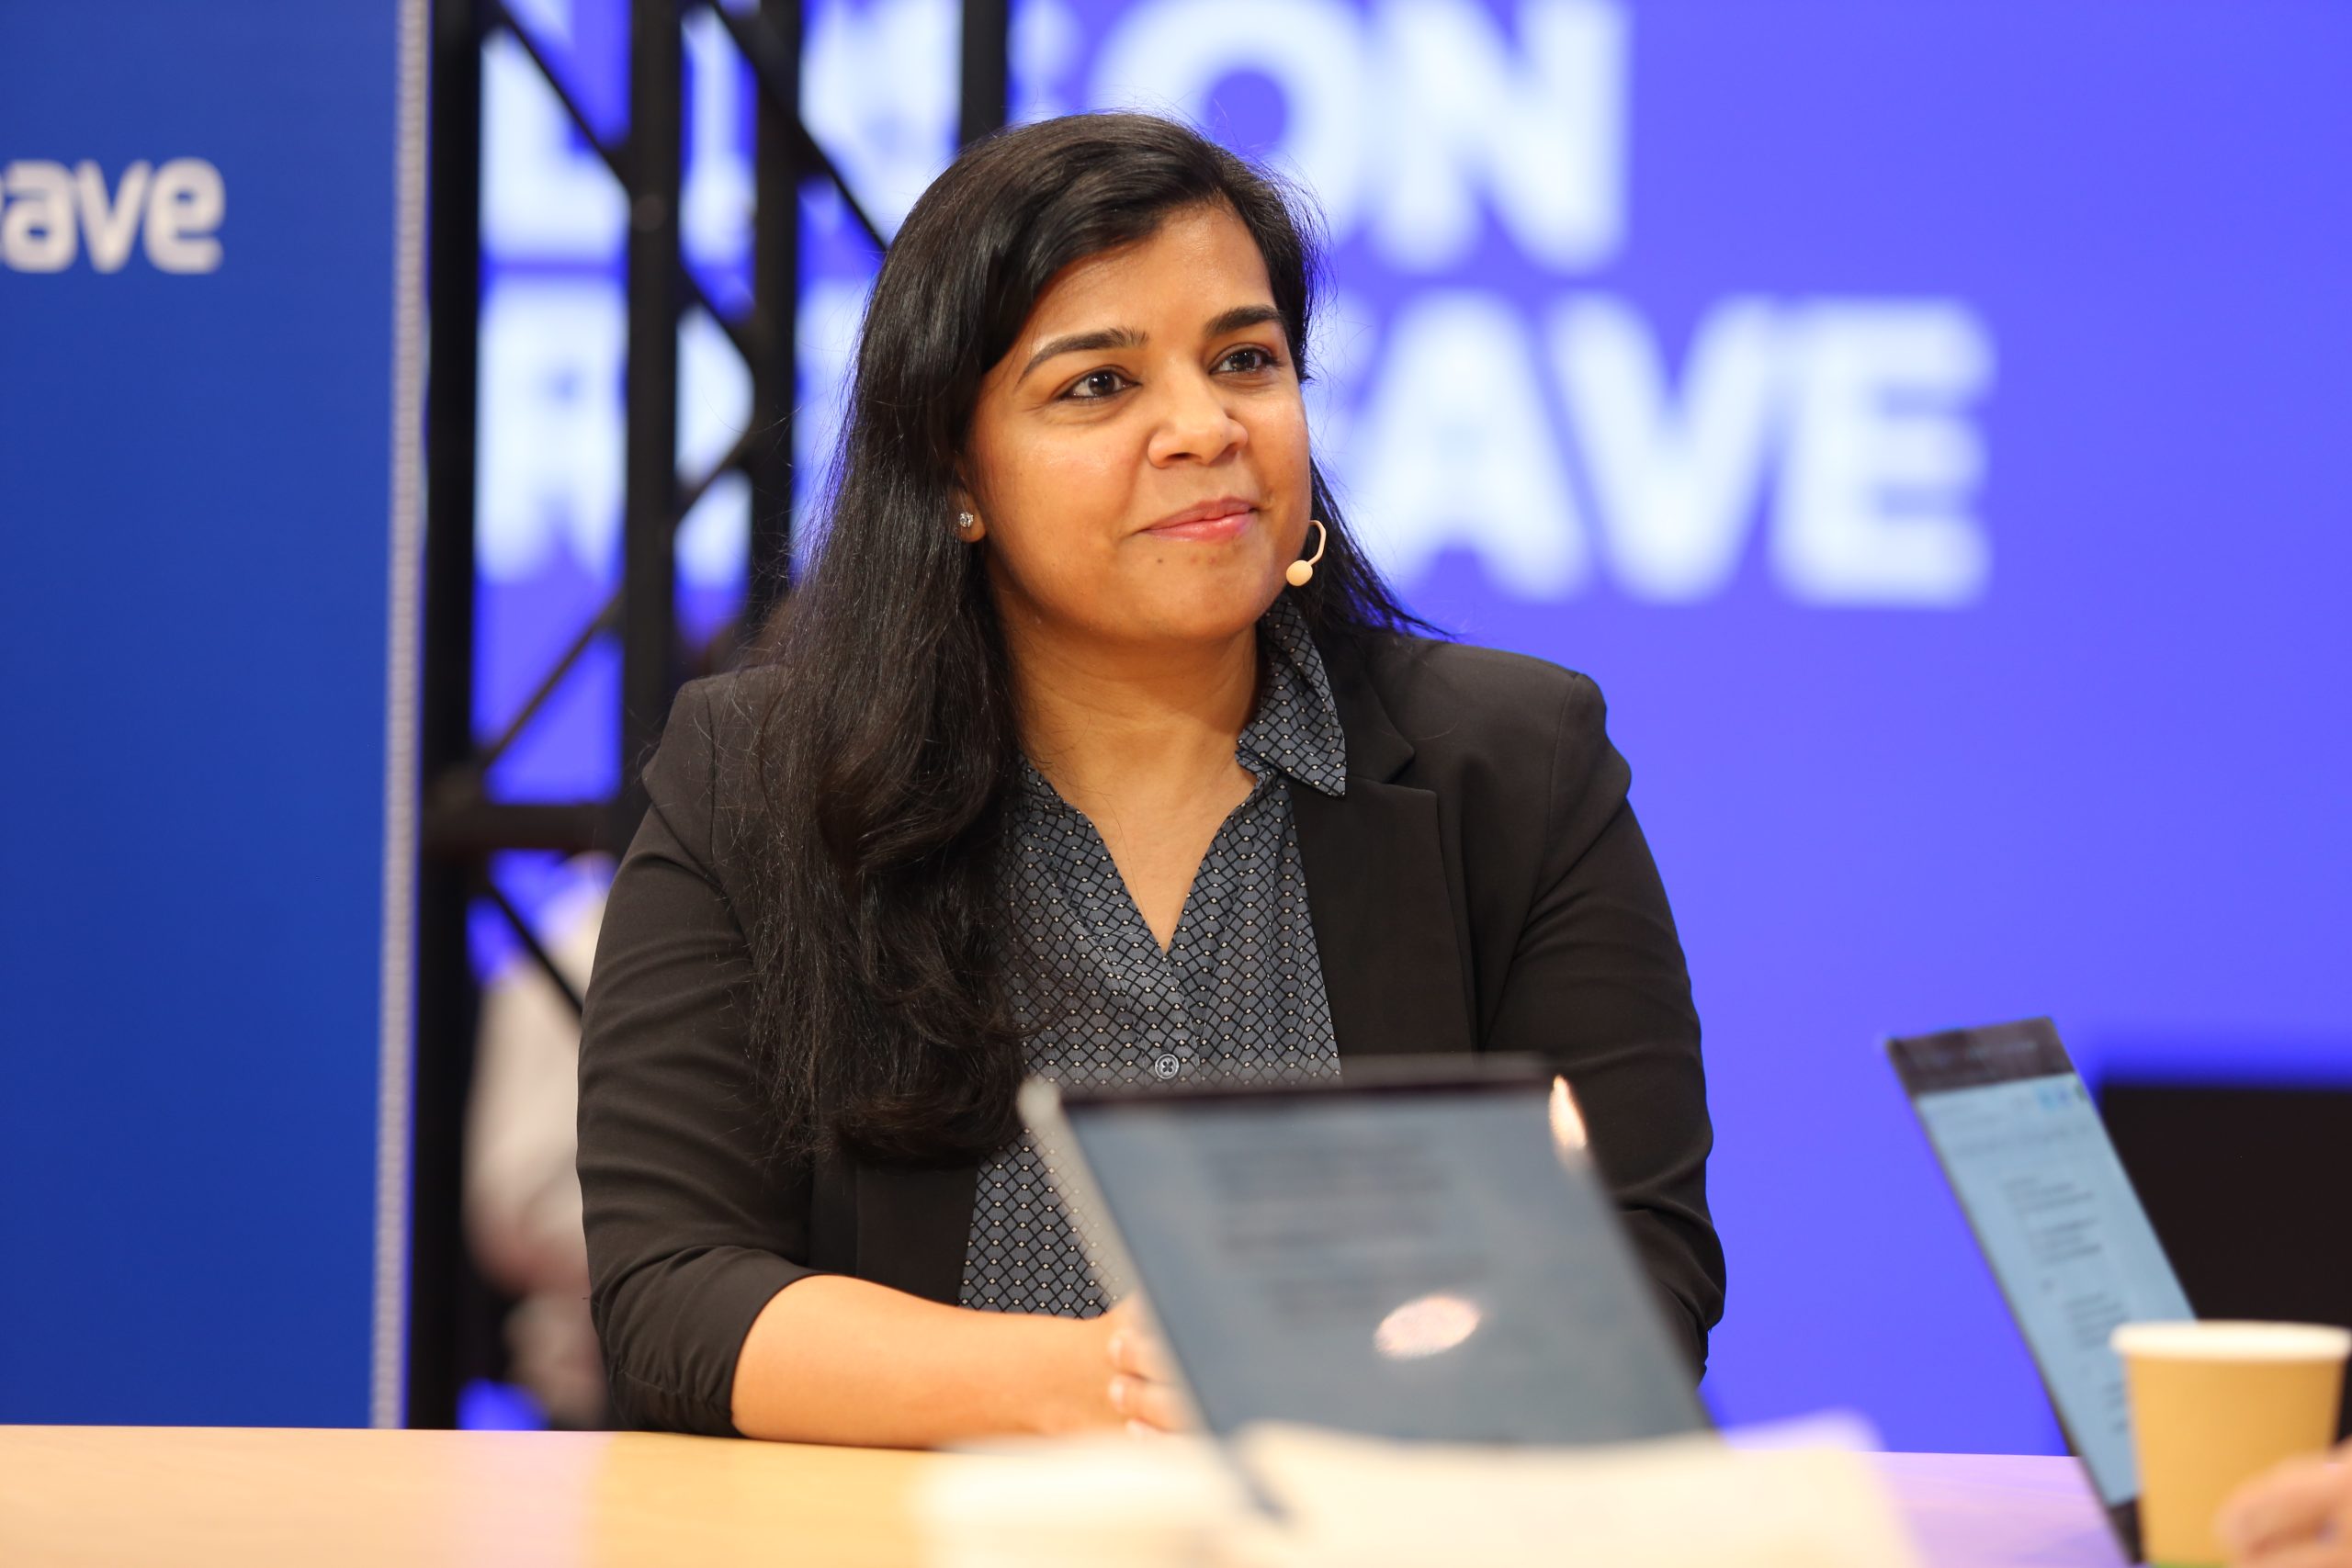
Ce changement pousse les fournisseurs de cloud spécialisés au-delà de la capacité brute du GPU vers le stockage, la mise en réseau et les logiciels. Un fournisseur superpose des services gérés pour la formation, la post-formation et l'inférence au sommet de son infrastructure, selon Urvashi Chowdhary (photo), vice-président des produits et des services d'IA chez CoreWeave Inc.
« Je pense que si vous regardez le parcours du développeur d'IA, il cherche à résoudre un problème et il veut le faire aussi rapidement que possible avec les meilleures performances et le meilleur coût d'évolution », a déclaré Chowdhary. «Nous nous sommes donc vraiment concentrés sur la construction des couches de notre pile, en nous appuyant sur une infrastructure fiable pour créer davantage de services gérés, que ce soit pour la formation, la post-formation ou l'inférence.»
Chowdhary s'est entretenu avec Dave Vellante et John Furrier de theCUBE Research lors de l'événement Fully Connected, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté de l'inférence de l'IA, des services gérés sur l'ensemble de la pile et des déploiements CoreWeave RL, une nouvelle fonctionnalité conçue pour accélérer l'itération des modèles agentiques. (* Divulgation ci-dessous.)
Optimiser la pile d'inférence d'IA couche par couche
La demande d’inférence augmente rapidement. Une enquête menée auprès des clients et prospects de CoreWeave par theCUBE Research a révélé que la part de la charge de travail d'inférence d'un client du secteur de la santé est passée d'environ 10 % la première année à 40 % la seconde, avec une part d'environ 50 % attendue d'ici 12 mois. La réponse de CoreWeave consiste à régler chaque couche au-dessus du matériel, du moteur vLLM aux modèles quantifiés et aux décodeurs spéculatifs personnalisés, a expliqué Chowdhary.
« Une chose sur laquelle nous avons été très intentionnels est d'exploiter les outils et technologies open source, de contribuer aux systèmes ouverts afin que les clients aient de la flexibilité, puis de construire nos services les uns sur les autres », a-t-elle déclaré.
L’apprentissage par renforcement ajoute une nouvelle pression. Lorsque les clients forment des modèles agents avec des récompenses et des vérificateurs, l'inférence devient le goulot d'étranglement lors des déploiements, selon Chowdhary. CoreWeave RL Rollouts, une fonctionnalité de prévisualisation basée sur le framework Dynamo de Nvidia Corp., charge de nouveaux points de contrôle dans un déploiement en direct. Lors des tests, cette fonctionnalité a amélioré la latence de rechargement du modèle de 15 fois par rapport à une configuration de base.
« Lorsque vous effectuez des déploiements RL, vous créez continuellement de nouveaux points de contrôle et versions de modèles et vous souhaitez que ceux-ci soient déployés dans votre configuration d'inférence afin que vous puissiez la faire évoluer de manière indépendante », a-t-elle déclaré. « Et nous avons pu accélérer cela de 15 fois, ce qui signifie que votre entraînement s'exécute rapidement et que votre inférence évolue tandis que vous continuez à entraîner votre modèle rapidement. »
Ces capacités se trouvent désormais dans CoreWeave Forge, une plate-forme lancée lors de l'événement qui relie le service, l'observabilité, la post-formation et l'évaluation. Forge est gratuit au démarrage, avec des niveaux payants offrant des fonctionnalités supplémentaires, étendant l'accès aux outils et services de développement d'IA aux développeurs individuels, a expliqué Chowdhary.
« Nous voulons rendre accessibles ces technologies de pointe », a-t-elle déclaré. « Même si vous êtes un développeur individuel qui s'inscrit seul aujourd'hui, vous bénéficiez toujours des meilleures performances, de la meilleure fiabilité et vous n'avez pas à faire de compromis. »
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE de l'événement Fully Connected :
(* Divulgation : TheCUBE est un partenaire média payant pour l'événement Fully Connected. Ni CoreWeave, le sponsor de la couverture de l'événement theCUBE, ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
