Depuis trois ans, l’infrastructure de l’intelligence artificielle est dominée par une idée : plus c’est gros, mieux c’est. Des modèles plus gros, des clusters plus grands et des chèques plus gros adressés à un petit groupe de fournisseurs. Lors du sommet mondial Open Compute Project de cette semaineIntel Corp.. a fait valoir que la prochaine phase de l’IA sera très différente et qu’Intel est bien placé pour en bénéficier.
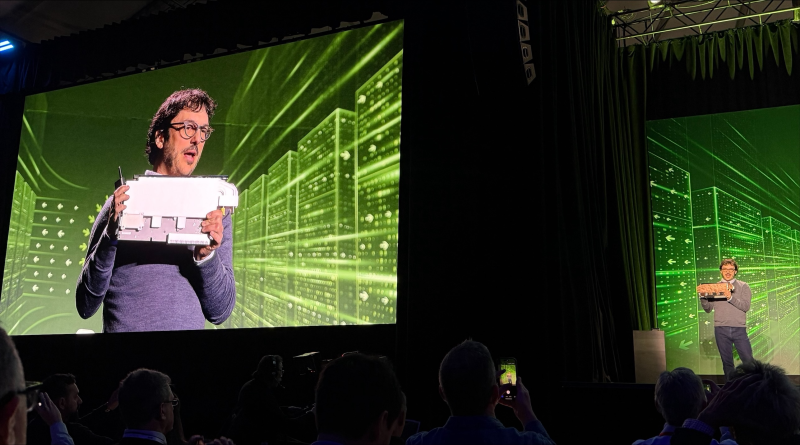
Lors de son discours d'ouverture, Nicolas Dubé (photo), vice-président d'Intel, a structuré son discours d'OCP autour d'une phrase simple : « Mettez chaque invite à sa place ». Il a partagé de nouveaux détails sur la série Intel GPU D, anciennement nommée Crescent Island, ainsi que sur les conceptions de rack Xeon construites en grande partie sur la spécification Open Rack v3 d'OCP et le travail logiciel ouvert.
En dessous se trouve un argument stratégique qui mérite attention : Intel pense que l’inférence, et non la formation, définira l’économie de l’IA d’entreprise et que l’IA agentique ramènera le processeur au centre du centre de données. Si c'est vrai, le redressement d'Intel obtient un deuxième moteur exactement au bon moment.
Toutes les invites n'ont pas besoin d'un modèle frontière
Aujourd’hui, la plupart des organisations envoient par défaut chaque demande à un modèle frontière, que la tâche le justifie ou non. C'est comme embaucher un associé juridique principal pour relire une note. L'alternative d'Intel est une couche d'orchestration qui évalue chaque requête en fonction de la profondeur d'intelligence requise, de la longueur du contexte, de la latence, de la sensibilité et de la souveraineté des données, ainsi que du coût et de l'énergie.
Des recherches approfondies peuvent justifier l’utilisation d’un modèle frontière. Les documents exclusifs devront peut-être rester au sein de l’entreprise. Les tâches de routine de codage, de synthèse ou opérationnelles peuvent s'exécuter sur un modèle ouvert plus petit pour une petite fraction du coût.
« Les modèles ouverts élargissent les options dont disposent les entreprises pour déployer l’IA », a déclaré Dubé. « Pour réaliser leur plein potentiel, les organisations ont besoin d’une infrastructure capable de répondre à différentes charges de travail avec les bonnes informations, ressources informatiques et économies. »
La dynamique derrière les modèles ouverts n’a jamais été aussi forte. Ces derniers mois, j’ai parlé avec des dizaines d’entreprises qui s’y sont tournées de manière agressive. Intel a cité les données de Vercel AI Gateway montrant que la part des modèles à poids ouvert dans le trafic de jetons observé est passée d'environ 31 % début juillet à environ 78 % fin septembre. Une passerelle n'est pas le marché, mais elle correspond à ce que j'entends de la part des responsables informatiques qui s'inquiètent des factures de jetons incontrôlables et de l'envoi de données sensibles au modèle de quelqu'un d'autre.
Crescent Island cible le milieu des affaires
La série D, dévoilée pour la première fois lors du sommet OCP de l'année dernière, est l'incarnation matérielle de cette thèse. Il est construit sur l'architecture Xe3P et offre 1,3 pétaflops de calcul FP8 et 1,5 téraoctets par seconde de bande passante mémoire dans un facteur de forme PCIe refroidi par air de 350 watts. La conception prend en charge jusqu'à 480 Go de mémoire LPDDR5X. La carte de marque Intel contient 160 Go et les partenaires peuvent créer des cartes de plus grande capacité.
La décision la plus intéressante est le choix de la mémoire. Plutôt que de chasser Nvidia Corp. et Advanced Micro Devices Inc. avec une mémoire à large bande passante coûteuse et limitée en approvisionnement, Intel a choisi le LPDDR, échangeant la bande passante maximale contre de la capacité et du coût. C'est le bon métier pour l'inférence, où le goulot d'étranglement consiste souvent à mémoriser le modèle et son contexte. Intel affirme prendre en charge des modèles allant jusqu'à 300 milliards de paramètres sur une seule carte et plus de 1 000 milliards dans un système à huit GPU.
Ce qui n’est pas nécessaire est tout aussi important. La plupart des centres de données d'entreprise n'ont pas été conçus pour des racks refroidis par liquide consommant plus de 100 kilowatts. Une carte de 350 watts adaptée à un serveur standard refroidi par air permet à une entreprise de démarrer avec une seule carte, de passer à un serveur à huit voies et de passer à des systèmes au niveau rack uniquement lorsque la charge de travail l'exige. L’inférence devient la charge de travail déterminante de l’IA, et les entreprises ont besoin d’une infrastructure qui rend la transition plus facile et plus rentable.
L'IA agentique est une histoire de CPU
La partie la plus sous-estimée de l’annonce est le travail en rack Xeon. L'IA agentique transforme l'inférence en un flux de travail en plusieurs étapes couvrant la récupération, le raisonnement, les appels d'outils, les requêtes de base de données et l'exécution d'applications. Chaque agent génère des jetons et une quantité importante de tâches générales exécutées sur les processeurs.
Intel a présenté des conceptions de rack Xeon construites par des partenaires, dont beaucoup sont basées sur ORv3, avec certaines configurations Xeon 6+ évoluant au-delà de 46 000 cœurs par rack à 133,45 kilowatts. Xeon 6+ avec des cœurs denses et efficaces cible les charges de travail d'agents à forte concurrence, tandis que Xeon 6 avec des cœurs performants gère les tâches qui dépendent de la vitesse d'un seul thread. Intel affirme que la bonne mesure n'est plus le nombre de cœurs mais le nombre d'agents simultanés qu'un rack peut supporter avec la latence cible, une perspective utile pour les acheteurs.
Le résultat est un système hétérogène : Xeon pour l'orchestration, le traitement des données et l'exécution des outils ; la série D pour l'inférence en modèle ouvert ; et SambaNova en tant que moteur à jeton rapide en option où la vitesse est la priorité. Au cours de sa présentation, Dubé a expliqué qu'Intel relie le système à une architecture logicielle qu'elle construit avec la communauté, qui est ouverte, téléchargeable aujourd'hui et conçue pour fonctionner sur le large silicium.
Du carburant pour le rebond du Lip-Bu Tan
Tout cela souligne le revirement d'Intel sous la direction du PDG Lip-Bu Tan, qui passe d'espérant à mesurable. Au deuxième trimestre, Intel publié Un chiffre d'affaires de 16,1 milliards de dollars, en hausse de 25 % sur un an, avec un chiffre d'affaires des centres de données et de l'IA en hausse de 59 %, à 6,3 milliards de dollars. Cela a marqué le septième trimestre consécutif au-delà de ses propres prévisions. Le stock a plus que triplé au cours de la dernière année.
Il est important de comprendre ce qui stimule la croissance. Ce n’est pas Intel qui gagne la guerre des unités de traitement graphique. C’est la reconnaissance du fait que l’IA a besoin de nombreuses unités centrales de traitement. Lors de la conférence .conf26 de Splunk en septembre, Tan a déclaré qu'Intel ne pouvait répondre qu'à environ la moitié de la demande de processeurs des clients, même après qu'Intel ait déjà augmenté ses dépenses d'investissement pour 2026 à plus de 20 milliards de dollars.
Les annonces de l’OCP prolongent cet élan de deux manières. Le travail en rack agent renforce la demande de Xeon qui fait déjà grimper les chiffres, positionnant Intel comme un fournisseur d'infrastructure d'agent essentiel plutôt que comme un fournisseur traditionnel. Et Crescent Island donne à Intel un jeu d'accélérateur qui lui permet de ne pas avoir à battre Nvidia en termes de performances maximales. Cela pourrait constituer le moyen le plus pratique et le plus économe en énergie d’exécuter des modèles ouverts dans un centre de données existant.
C'est la discipline que Tan a apportée : arrêter d'essayer de gagner chaque combat et se concentrer sur les combats dans lesquels Intel a un avantage structurel. Intel n'a pas besoin de posséder une formation de pointe. Elle doit s’approprier le milieu de l’entreprise, une opportunité bien plus grande que ce que la plupart des gens lui attribuent.
Ce que les responsables informatiques devraient faire maintenant
Le passage de l'échelle à l'adéquation ne se produit pas dans une organisation. Cela doit être planifié. Voici où je me concentrerais :
- Vérifiez votre mixage rapide. La plupart des organisations ont une visibilité limitée sur ce que leurs dépenses en IA achètent. Extrayez quelques semaines de journaux d'utilisation et triez les demandes par type de tâche : raisonnement approfondi, questions nécessitant beaucoup de récupération, aide au codage, résumé et classification. Lors de mes conversations avec les responsables informatiques, je constate souvent qu’une grande partie du trafic est un travail de routine qu’un modèle ouvert plus petit pourrait gérer à une fraction du coût. Faites-le avant le prochain renouvellement de votre contrat modèle, pas après.
- Traitez l’orchestration comme une couche stratégique et non comme une fonctionnalité. Le routage basé sur le coût, la latence, la longueur du contexte et la sensibilité des données est à l'origine des économies et du contrôle. Que vous la construisiez ou l'achetiez, la couche d'orchestration doit être indépendante du modèle, de sorte que changer de fournisseur ou intégrer une charge de travail en interne constitue un changement de politique plutôt qu'une réarchitecture. C'est également l'endroit naturel pour appliquer la gouvernance, par exemple en garantissant que les données réglementées ne quittent jamais votre environnement.
- Changez la façon dont vous évaluez l’infrastructure. Les pics de FLOPS et le nombre de cœurs sont des mesures du fournisseur, et non des mesures commerciales. Demandez aux fournisseurs de démontrer des agents simultanés maintenus à une latence cible, un coût par million de jetons et des jetons par watt sur un modèle que vous envisagez d'exécuter. Exécutez ensuite les tests vous-même avec vos propres invites et longueurs de contexte. Un système qui remporte un benchmark dans un contexte court peut être très différent dans les contextes longs générés par les flux de travail agents.
- Planifiez le centre de données dont vous disposez. Le refroidissement liquide a sa place, mais la modernisation des installations est coûteuse, lente et souvent limitée par la puissance disponible. Avant d'engager du capital, exécutez une preuve de concept à l'aide de l'inférence PCIe refroidie par air dans les racks existants. Commencez petit, avec une carte ou un serveur, et évoluez uniquement lorsque l'utilisation le justifie. Pour de nombreuses charges de travail d’entreprise, ce chemin sera suffisant et il est beaucoup plus rapide à déployer.
- Ne négligez pas le budget CPU. L'IA agentique transfère une part significative du travail vers le calcul à usage général : appels d'outils, récupération de données, requêtes de base de données et exécution de code. Les organisations dont la taille se limite aux accélérateurs verront leurs agents confrontés à des goulots d'étranglement ailleurs. Modélisez la demande de CPU en fonction de la demande de GPU et tenez compte d’une offre limitée. Intel lui-même affirme qu'il ne peut pas répondre à toute la demande actuelle, alors bloquez la capacité le plus tôt possible.
- Insistez sur les normes ouvertes ainsi que sur les logiciels et le matériel ouverts. ORv3, PCIe et Open Adapter Card, combinés à des frameworks ouverts et des couches d'orchestration, protègent votre capacité à mélanger les fournisseurs et à vous adapter à l'évolution du marché. Notez que l'OAC, bien que proche, n'est pas une spécification finale. En attendant, PCIe, une norme éprouvée, constitue une bonne option. Il ne s’agit pas de PCIe contre OAC, mais d’assurer l’ouverture partout. Demandez à chaque fournisseur à quelle vitesse les nouveaux modèles ouverts s'exécutent sur son matériel et si ses optimisations résident dans des frameworks grand public ou dans une pile propriétaire. Le verrouillage au niveau de la couche logicielle est plus difficile à dénouer qu’au niveau de la couche matérielle.
Réflexions finales
Intel a passé une grande partie de ces dernières années à être radié dans le domaine de l'IA, et pendant un certain temps, ces critiques étaient méritées. La société a poursuivi Nvidia selon les conditions de Nvidia et a perdu. Ce qui est différent maintenant, c'est qu'Intel joue à un jeu différent, construit autour de la direction que prend l'IA d'entreprise plutôt que de la direction qu'elle a prise.
Le pari est que l’inférence sera hétérogène, que les modèles ouverts continueront de combler l’écart avec les modèles propriétaires et que les agents rendront le CPU aussi important pour l’IA que le GPU. Aucune de ces idées n’est plus particulièrement controversée, et les données soutiennent de plus en plus les trois. Ce qui reste ouvert au débat, c'est de savoir si Intel peut exécuter. Crescent Island doit être expédié à temps et fonctionner comme promis ; la pile logicielle doit suivre le rythme d'un écosystème de modèle ouvert qui évolue chaque semaine ; et l'entreprise doit remédier à ses contraintes d'approvisionnement pour capitaliser sur la demande déjà présente en Xeon.
C’est là que l’ère Lip-Bu Tan diffère de ce qui l’a précédée. Sous Tan, Intel a été plus discipliné quant à ses concurrents, plus franc sur ce qu'il pouvait offrir et plus concentré sur les clients que sur les feuilles de route. Sept quarts-temps consécutifs de guidage ne se produisent pas par hasard. Si Intel apporte cette même discipline à la série D et à ses plates-formes agents Xeon, on se souviendra peut-être de l'OCP 2026 comme du moment où Intel a cessé d'essayer de rattraper son retard en matière d'IA et a commencé à définir sa propre voie.
La première phase de l’échelle récompensée par l’IA. Le prochain récompensera la forme. Le message d'Intel à l'OCP est qu'il comprend la différence, et ses récents résultats suggèrent que le marché commence à y croire.
Zeus Kerravala est analyste principal chez ZK Research, une division de Kerravala Consulting. Il a écrit cet article pour SiliconANGLE.
