Les centres de données IA ont dépensé massivement en accélérateurs plus rapides, en racks plus denses et en refroidissement liquide pour maintenir ce matériel en fonctionnement. Le pipeline de données qui alimente ces processeurs n'a pas suivi le rythme, et les calculs coûteux finissent par dépendre de la mémoire et du stockage.
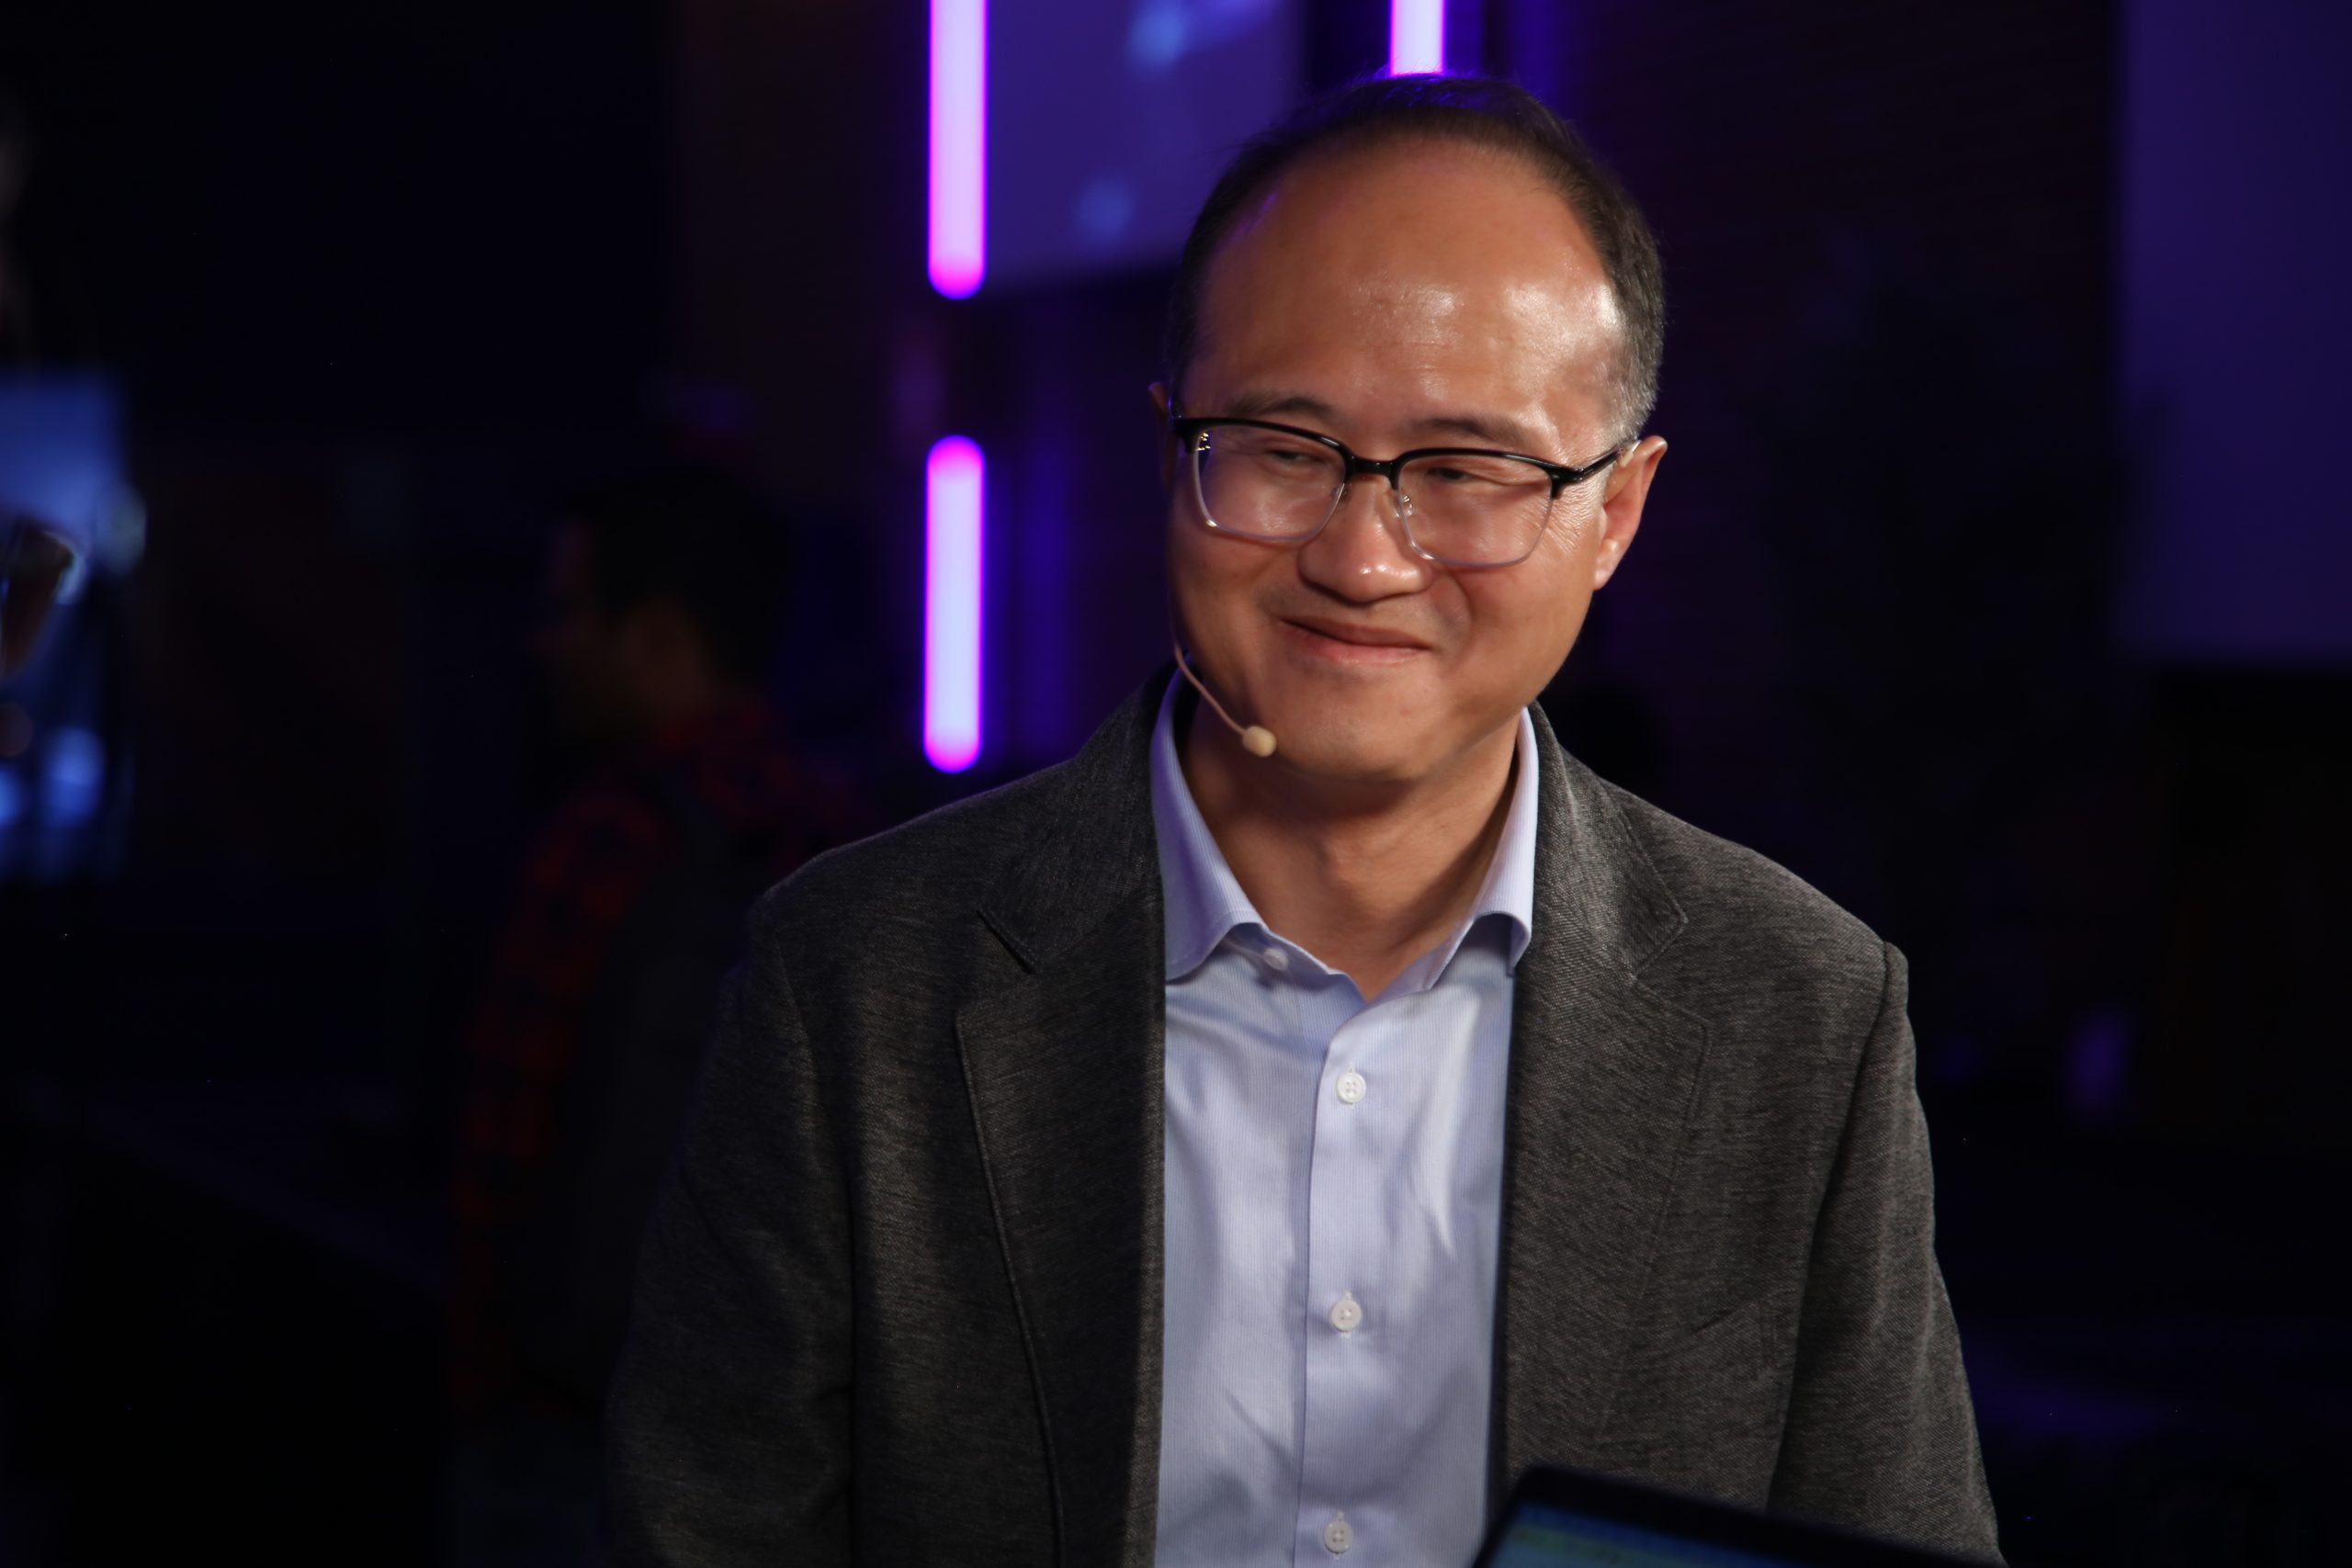
Cette lacune retient de plus en plus l’attention à mesure que les goulets d’étranglement de l’infrastructure d’IA deviennent au cœur de la planification des centres de données. La solution consiste à repenser la mémoire externe et les niveaux de stockage derrière le GPU, selon Hao Zhong (photo), co-fondateur et PDG de ScaleFlux Inc.
« Les performances des GPU et TPU ont progressé incroyablement rapidement, presque plus de 1 000 fois au cours des huit dernières années », a déclaré Zhong. « Et nous devons suivre le flux de données. Sinon, nous n'en tirerons pas suffisamment d'efficacité. »
Zhong s'est entretenu avec John Furrier de theCUBE Research au AI Data Pipeline Forum, lors d'une diffusion exclusive sur theCUBE, le studio de diffusion en direct de SiliconANGLE Media. Ils ont discuté des goulots d'étranglement de la mémoire de l'IA, du refroidissement liquide et de l'évolution vers les charges de travail d'inférence et d'agent. (* Divulgation ci-dessous.)
Passer du refroidissement liquide au pipeline de données IA
Zhong décrit l’infrastructure de l’IA comme un pipeline comportant plusieurs étapes. Les processeurs dotés d'une mémoire à large bande passante constituent la première étape, et les DRAM et SSD externes constituent les deuxième et troisième, a-t-il expliqué. Cette année, ScaleFlux a dévoilé de nouveaux contrôleurs conçus pour ces niveaux : un pour les SSD PCIe Gen 6 et un pour la mémoire Compute Express Link.
« Ce que ScaleFlux aide notre écosystème, c'est à construire les puces de contrôleur ou les petits processeurs pour les pipelines de données des deuxième et troisième étapes », a déclaré Zhong.
Les charges de travail évoluent également. À mesure que les applications d’IA passent de la formation à l’inférence et au travail agent, les systèmes ont besoin de beaucoup plus de données à portée de main, selon Zhong. Cela place la capacité, la bande passante et les performances des DRAM et SSD externes au centre des décisions d’infrastructure.
« C'est pourquoi le stockage des données et la mémoire deviennent désormais extrêmement importants et deviennent littéralement le goulot d'étranglement de la future IA », a déclaré Zhong.
Voici l'interview vidéo complète, faisant partie de la couverture par SiliconANGLE et theCUBE du forum AI Data Pipeline :
(* Divulgation : Scaleflux a sponsorisé ce segment de theCUBE. Ni Scaleflux ni les autres sponsors n'ont de contrôle éditorial sur le contenu de theCUBE ou SiliconANGLE.)
